用知识图谱梳理代码库的结构与依赖
作者用 Graphify 在约 5 分钟内解析一个含 1095 个文件的仓库,选取其中 105 个结构相关文件,生成 4022 个节点和 10079 条关系。文章提供本地安装方式,可让编程 Agent 查询函数、类、模块及其调用和导入关系。
AI 深度解读
一个有 1,095 个文件的仓库,AI agent 用 5 分 25 秒生成了包含 4,022 个节点、10,079 条边的知识图谱。作者从中找到了公共函数、CLI 入口,还发现了一处过时的架构文档。
这次尝试的价值,在于把「谁调用谁、谁依赖谁」变成可查询的结构。不过,速度和结果来自作者自己的仓库,不能直接当成所有项目的效果承诺。
1,095 个文件,是怎么变成一张图的?
作者分析的是 Graphify-Labs/graphify,固定在 commit dac0634。仓库包含 Python 源码、测试、文档、示例和 fixtures。
运行环境是 Perplexity Computer,并启用了 Graphify skill。作者输入 /graphify,粘贴 GitHub URL,再要求生成仓库知识图谱。没有使用 connector,也没有上传文件,由 agent 自行克隆公开仓库。
关键细节是:这次并没有把全部 1,095 个文件都解析进图,而是挑选了其中承载代码结构的 105 个文件。
解析后的函数、类、模块成为节点,调用、导入、包含关系成为边。社区发现(community detection)再将它们划分成 192 个簇,大致对应代码的组织方式。可以把它理解成:根据连接关系,把联系密切的代码归到一起。
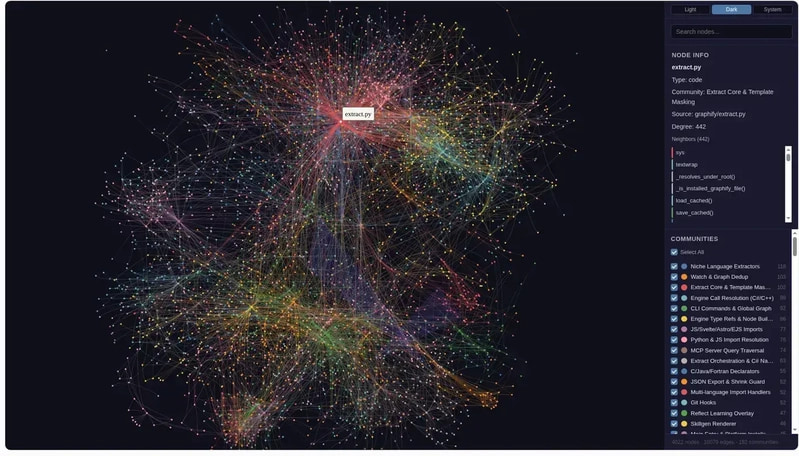
原文没有交代这 105 个文件的具体筛选规则,也没解释节点和边如何去重。因此,4,022 和 10,079 是这次运行的产出,不能单靠数量判断覆盖率或准确率。
比起看图,更有用的是找到改动的影响范围
图里最有信息量的部分,是几个连接密集的位置:
_read_text()有 270 个连接,是连接最多的函数。作者说几乎所有 extractor 都经过它,因此建议新人先读这个小工具函数。_make_id()有 234 个连接,负责为每张图里的节点生成身份标识。修改它,可能影响后续大量处理。dispatch_command()调用了 127 个不同函数,是 CLI 的入口,可以用来观察工具暴露的功能范围。extract.py的度数(degree)为 442。度数描述节点关联的边数,这个结果符合作者对它处于项目中心的直觉。
这里要区分「连接数」和「调用了多少个函数」:原文给 _read_text()、_make_id() 的是连接数,只有 dispatch_command() 明确对应调用的不同函数数量。
图谱还帮助作者找到了一处文档错误:ARCHITECTURE.md 写着 to_html 位于 export.py,图中显示实际位置是 exporters/html.py。作者据此修正了文档。
最终产物包括可缩放、点击的交互地图,一个包含 graph.json、graph.html 和笔记的 ZIP,以及一份介绍关键节点、社区和入口的报告。
作者认为,日常使用最重要的是 graph.json。agent 可以查询「谁调用了 _make_id()」,直接利用已提取的结构关系,减少每次会话重新搜索、阅读文件的工作。
本地安装使用下面这条命令:
pip install graphifyy
注意包名是 graphifyy,末尾有两个 y。原文接着建议对项目目录运行工具,让 Claude Code、Cursor 或 Codex 查询图谱,但没有给出完整的本地生成命令和接入配置。
我的判断
我认可把结构查询引入 AI 编程流程。查找调用方、定位公共入口、判断修改可能波及哪里,都适合从明确的依赖关系入手。交互图帮助人建立整体印象,结构数据则更方便 agent 持续查询。
但这仍是一份单仓库的使用记录。作者没有提供与文本搜索、IDE 引用查找或语言服务的对照数据,也没有测量查询准确率、成本和后续维护开销。「减少重复阅读」有合理依据,究竟能节省多少时间,原文没有证明。
还有两个前提需要保留。首先,连接多可以提示影响面,却不能独自证明业务重要性。其次,原文没有说明如何处理动态调用、反射,以及代码修改后的图谱更新。对于前端、Node 项目,也没有给出实测结果。
更合适的定位,是把图谱当成阅读和排查的导航,再回源码确认具体行为。
能拿来做什么
- 接手陌生仓库时,可以沿用作者的问题,让 agent 找出连接最多的五个函数及其依赖方,再据此安排阅读顺序。
- 修改公共工具函数前,先查询调用方和依赖关系,再回到源码核对,帮助确定需要检查的影响范围。
- 维护架构文档时,可以用图谱核对函数归属和模块位置,优先检查文档中写死的文件路径。
- 想在前端或 Node 项目尝试时,先确认实际解析了哪些文件,以及本地如何生成、更新
graph.json。原文的安装命令还不足以复现完整流程。