开源数据集收录 66 条编程智能体实战轨迹
数据集以 MIT 许可证发布,每条记录对应一次在 Docker 沙箱中执行的完整会话。记录包含任务要求、工具调用及原始输出,也保留了测试失败、修复重试和最终补丁。
AI 深度解读
MegaBit Trajectories 在 Hugging Face 免费放出了 66 条完整的编程 Agent 会话。作者想补上训练数据里容易被清掉的一段:模型遇到工具调用错误、搜索没结果或测试失败时,接下来怎么查、怎么改、怎么重试。
这批数据已经提供了可下载的会话、格式转换工具和离线校验脚本。作者还用同一套口径比较了 5 个公开数据集。至于保留失败过程能让模型进步多少,这次发布还没有给出训练结果。对做 AI 编程工具的人来说,眼下最直接的用途是用这些记录检查自己的加载器和评估流程。
一条数据为什么要装下整次改代码的过程
数据集的一行就是一条按时间排列的完整会话。开头是系统提供的工具、工作区和规则,接着是用户工单,里面写明要改什么、怎么验收。随后是 Agent 的 read、grep、edit、write、bash、todo 等操作,以及工具返回的原始结果。测试跑挂、改完再跑、最终补丁都在记录里。
作者的理由是,失败发生前后的消息要放在一起才有训练价值。一次 grep 没搜到东西,单看输出很难判断下一步。连着读原命令、工作目录和工单,才可能看出是路径选错了、搜索条件太窄,还是该去查另一个文件。只留下最终补丁,模型就看不到这些判断依据。作者因此把它定位为继续预训练(continued pretraining)数据,建议整条会话打包,保留消息顺序、工具结果和截断标记,评估时也观察整个修复过程。
按作者的描述,命令在真实的 Docker 沙箱里执行,工作区从一个新的根提交开始,避免 Agent 通过 Git 历史直接拿到人类补丁。作者列了 4 项审计检查,分别覆盖工单路径、来源、许可证和测试。公开版涉及 5 个仓库,任务用 Python。引擎已支持 JS、TS、Go、Rust,原文把其他语言的公开样本留给后续发布需求。
66 条会话能证明什么
作者拿 MegaBit 和 5 个公开数据集按同一口径做了对照,也把自己的短板列了出来。MegaBit 有 66 条会话,对照项中有 59,136 个任务和 702,062 对编辑记录。仓库覆盖是 5 对 222,最长的「出错到重试」链是 4 对 64。会话、任务和编辑对是不同的计数单位,读表时要保留这个区别。
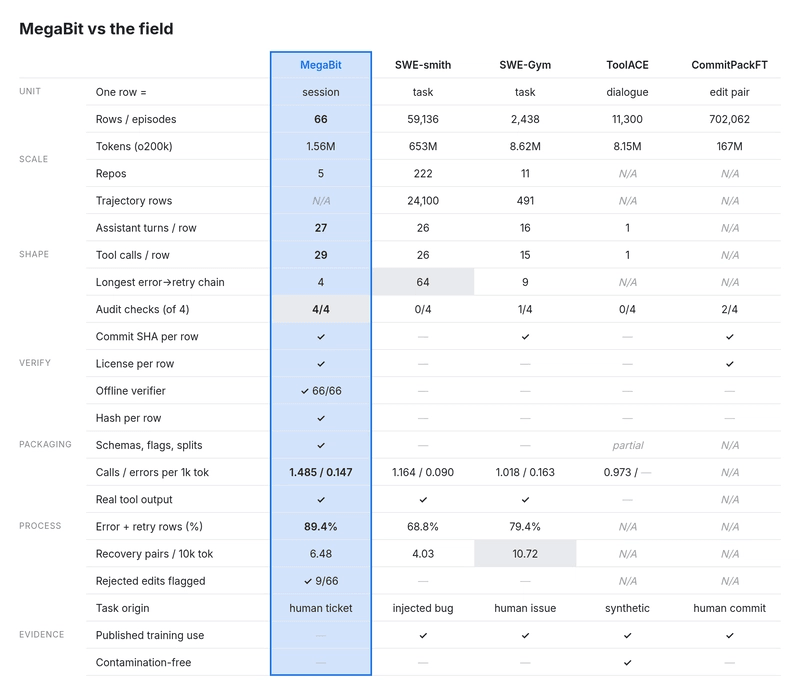
下载后可以在仓库目录运行 python3 verify.py,原文展示的结果是 66/66 episodes verified。脚本为每条会话重算两个 SHA-256 值,并检查头尾记录、工具调用次数、导出判定和来源字段。这里能验证的是手里的记录与发布时一致。测试表现要回到工单的验收条件看,训练效果则需要单独跑实验。原文明确说,对照数据里已有公开训练证据,MegaBit 这次还没有。
接入训练前,先把工具消息读对
用 Hugging Face 的 datasets 可以直接加载 train,下面三行用来查看第一条会话来自哪个仓库,以及包含多少条消息。
from datasets import load_dataset

ds = load_dataset("Sumama-Jameel/megabit-trajectories", split="train")

print(ds[0]["repo"], len(ds[0]["messages"]), "messages")
第二行的 split="train" 读取公开训练集,最后一行统计的是单条会话的消息数。
工具调用的 arguments 存的是 JSON 文本。数据里有 1 次格式错误的调用,其 arguments 为 null,原始输入留在 arguments_raw,同时标了 parse_status: "error"。下面的代码让加载器避开这一次解析错误。
import json

row = ds[0]

for msg in row["messages"]:
    for tc in msg["tool_calls"] or []:
        if tc["parse_status"] != "error":
            args = json.loads(tc["arguments"])
先判断 parse_status,再调用 json.loads(tc["arguments"])。训练数据里仍可保留这次失败及后续消息,让模型看到错误发生后怎么处理。
data/train.parquet 和 data/train.jsonl 是同一批训练记录,data/ 中过长的工具输出带有明确截断标记,全文可在 episodes/ 的原始记录里找到。运行 python3 convert_formats.py --help 可以查看 OpenAI 消息格式、ShareGPT、Hermes、纯文本和适配 LoRA 等流程的通用布局。转换工具提供无损检查模式,clean 标志用于筛选已验证会话。许可证也分两层:数据打包采用 MIT,上游代码沿用各自的许可证,逐行记录 SPDX 标识,并随数据附带上游声明。
我的判断
保留失败记录最有说服力的地方,是它让人看得到 Agent 有没有用上工具反馈。例如测试报了一个具体断言,下一次编辑是否针对那个断言,可以沿着记录查清。只用「工单 + 最终补丁」做评估,更容易比较最后改对了多少。完整会话还可以用来观察模型在哪一步绕路、收到失败结果后有没有调整。两种记录能回答的问题各有侧重。
至于完整轨迹是否比精简后的轨迹更适合训练,目前仍是作者基于数据观察提出的经验判断。原文比较了数据规模和错误链长度,却没有在同一模型、同一训练预算下,对照「保留失败」和「移除失败」后的结果。公开版也只覆盖 5 个 Python 仓库。换到需要跨包定位、跑构建再跑测试的前端项目,现有记录能覆盖多少常见问题,原文没有给出数据。
能拿来做什么
- 给自己的 Agent 日志加载器加一轮兼容性检查。挑一条含失败和重试的会话,核对
tool_call_id能否把调用和结果关联起来,再用那条坏 JSON 确认导入流程能保留错误记录并继续往下读。 - 给前端或 Node 项目的本地 Agent 评估多记两项观察。除了最终测试是否通过,再看首次测试失败后做了什么,以及后续修改能否从报错中找到依据。
- 如果要验证作者的训练主张,用同一模型、同一训练预算和同一组留出工单做小规模对照。一组保留完整轨迹,另一组保留工单和最终补丁,同时记录任务通过率与测试失败后的恢复表现。