让值班 Agent 记住失败的修复方案
RecallOps 使用开源记忆系统 Hindsight 保存事故复盘,在告警分诊时召回类似事故的根因、有效修复和失败尝试。实现以单次事故为文档单位,并拆分记忆访问、提示词解析和界面代码。
AI 深度解读
值班 Agent 最危险的建议,有时恰好是教科书里的标准答案:连接池不够就扩容,服务忙不过来就加副本。RecallOps 的作者想解决的是,怎样让 Agent 记住团队以前为什么踩过这些坑,尤其是哪些补救措施曾让故障更严重。
他的做法是用 Hindsight 保存事故复盘,让新告警先检索历史,再生成排查建议。演示里最有价值的输出不是修复步骤,而是「不要做什么」。这套设计值得借鉴,但它目前证明的是几个具体案例中的效果,离稳定缩短线上故障处理时间,还有验证距离。
为什么相同的连接池告警,不能套同一份答案
作者模拟了一套金融科技后端:Java/Spring 的 payments-api 使用 HikariCP,Go 编写 auth-service,Postgres 数据库 ledger-db 前面放着 PgBouncer,另外还有 Redis、Kafka 和 Kubernetes。
这里的关键词是「模拟」。文中的事故库和运行结果,不能直接当作某家金融公司的生产统计。
三个事故出现过完全相同的报错:
HikariPool-1 - Connection is not available, request timed out after 30000ms
但原因各不相同:
- INC-1003 是批处理留下了 37 个「idle in transaction」连接,也就是事务没结束,连接却闲在那里。
- INC-1007 是异常处理路径泄漏了连接。
- INC-1012 是迁移遗留了无效索引,查询退回顺序扫描,把连接占用了 40 秒。
更麻烦的是 INC-1005。INC-1003 之后,有人把 maximumPoolSize 从 40 调到 80。几周后,payments-api 自动扩到 24 个副本,潜在连接数达到 1,920,而 Postgres 的 max_connections 只有 500,最终报出 FATAL: sorry, too many clients already。
单看应用实例,扩连接池像是在解围;放到整个集群,它可能是在增加数据库的压力。
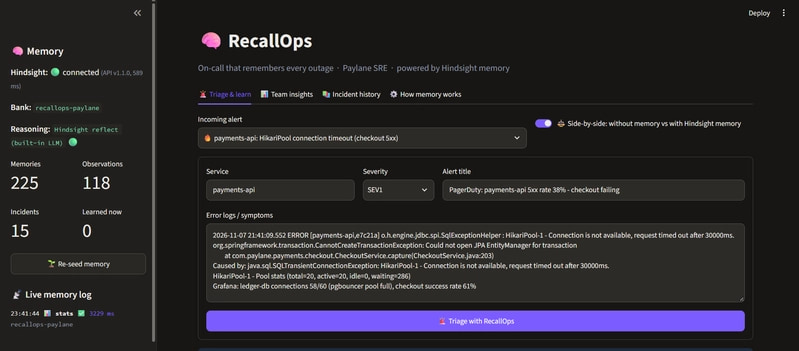
没有记忆时,模型给出的建议包括检查慢查询、临时增加连接上限、扩应用副本、重启连接。其中一些动作,恰好就是这个事故库里的错误尝试。
接入记忆后,RecallOps 引用 INC-1003、INC-1012 和 INC-1007,先建议检查 pg_stat_activity,区分闲置未提交事务和长时间运行的活跃查询,再决定处理方向。同时,它警告不要贸然提高 HikariCP 的 maximumPoolSize,也不要随意重启 PgBouncer,后者可能中断进行中的事务,造成结账错误激增。
历史记忆的价值,是让看似合理的建议接受本地事故记录的约束。
为什么要按事故存储,再按事实检索
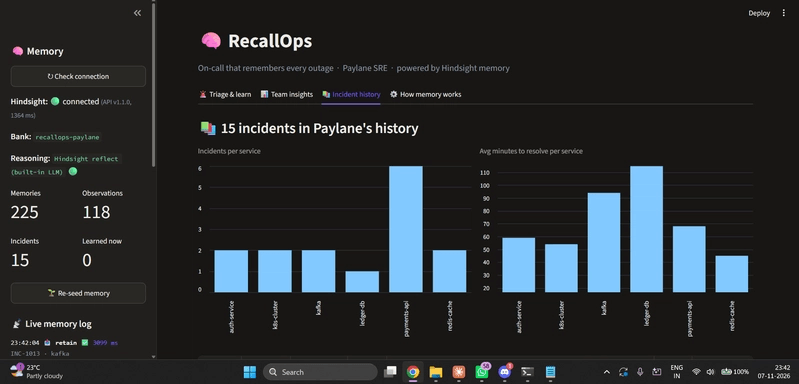
RecallOps 的流程分为四步:用 retain 写入复盘,用 recall 检索类似事故,让 LLM 推理,最后把工程师确认的真实结果再次写回。团队视图还通过 reflect 汇总整个记忆库,回答哪些问题反复出现、哪些修复持续有效。
实现并不复杂:memory.py 集中封装 Hindsight 调用,agent.py 管提示词和解析,app.py 提供 Streamlit 界面。更关键的设计在于记忆的组织方式。
Hindsight 会从文本提取事实、实体和时间,并非简单保存一整段原文。检索出来的可能是几句事实,但工程师需要知道它们属于哪次事故。因此,作者把每份复盘绑定到事故编号,并附上时间、扁平元数据和标签。
下面这次调用解决的就是「事实被拆开后,仍能追溯事故」的问题:
c.retain( bank_id=self.bank_id, content=incident_to_memory(inc), context=f"production incident post-mortem for {inc['service']}", timestamp=_parse_ts(inc["date"]), document_id=inc["id"], metadata=incident_metadata(inc), tags=incident_tags(inc), )
重点看 document_id=inc["id"] 和 timestamp=_parse_ts(inc["date"]):前者负责归属,后者必须使用事故实际发生时间。把所有历史复盘都记成今天,会损失「六月那次证书故障」这样的时间检索能力。
作者还在复盘每个章节重复事故 ID,例如根因和失败尝试都带上 INC-1003,避免提取后的短句失去出处。记忆库的 mission,也就是提取指导,明确要求把错误特征、修复和失败尝试关联到事故 ID。
召回后,应用根据 document_id 和 metadata 把事实重新聚合成事故。Hindsight 在后台归纳出的跨事故观察,则单独展示,例如同一种连接池耗尽曾有三个不同根因。个案证据和跨案例规律由此各有位置。
记住一次新故障,下一次回答真的会变吗
作者做过一次直接演示:工程师在「Mark resolved」表单中纠正 Agent 的猜测,录入新的结算报表 CronJob。它在 Postgres 主库执行分析查询,占住约 40 个连接;处理办法是改走只读副本,并给批处理配置独立的 PgBouncer 池。
这条记录保存为 INC-1016,耗时约 5 秒。再次运行完全相同的告警,它成为首位匹配,前三步建议也变成暂停对应 CronJob、识别阻塞查询、切到只读副本,均引用 INC-1016。预计处理时间也改为参考该事故的实际耗时。
没有重新训练模型,一次 retain 改变了下一次回答。这验证了写入到召回的链路,但重复同一告警,也属于比较容易命中的测试。
作者还测试了没有先例的故障:节点时钟漂移 61 秒,JWT 校验报 token used before issued。检索仍返回历史内容,Agent 则需要判断这些内容无关,再使用通用知识分析时钟偏差。
这里暴露出一个很实际的问题:模型会把事故写进「匹配列表」,理由却是它「没有涉及 clock skew」。如果界面照样画成命中卡片,用户看到的就是错误暗示。作者为此过滤 why 中包含 did not、no match、unrelated 等表达的条目。
这个过滤很粗,但背后的分工合理:召回可以宽松,推理负责判断相关性,界面必须尊重判断结果。
对照实验也做了一层约束:没有外部 LLM key 时,两侧都调用 Hindsight Cloud 的 reflect,使用同一模型和同一 API,无记忆侧连接空 bank。它排除了更换模型这个变量;不过,作者也提到不同的基线查询,原文没有完整展示两侧提示词,仍不能据此确认所有条件严格一致。
工程细节同样影响结果。reflect 接受 JSON response_schema,但作者发现,它先形成文字回答,再提取到结构中。只给大段 JSON 指令,得到的可能是合法 JSON、一个步骤和空的避免事项。改成明确要求运行手册,包含匹配事故、根因、5–7 个带事故 ID 的步骤、失败措施和时间估计后,同一 schema 得到了六个带引用的步骤和四条警告。
结构合法,只能证明格式正确,不能证明信息充分。
作者没有使用 tool calling,而是请求普通 JSON,再清理代码围栏、提取首个配平的 {...}、容忍尾随逗号,解析失败重试一次,最后降级展示原文。这是他的兼容性取舍,不是对所有模型供应商的普遍结论。
界面还公开记录 retain、recall、reflect 的调用和延迟,展示每次事故下的实际召回事实。作者实测几百个记忆单元时,召回约需 1–2.5 秒,写入复盘约需 5 秒;这些是该规模下的观测,不能直接推算大规模性能。
我的判断
我认可把失败尝试作为一等信息。常见知识库容易留下「最后怎么修好」,却省略中途哪些操作无效、哪些操作扩大了影响。对需要提出行动建议的 Agent,这部分信息很有用。
但失败记录必须带条件。某次扩连接池有害,不代表扩容永远错误;某次重启 PgBouncer造成中断,也不能推导出所有场景都禁止重启。事故 ID、真实时间和上下文,都是为了保留这些边界。
和普通复盘检索相比,RecallOps 多了事实提取、跨事故归纳和结果回写。收益是能组织出有引用的处置建议,代价是提取、相关性判断和结构解析都可能出错。模型预填的结案表单尤其需要工程师认真纠正,否则猜测可能被保存成下一次的依据。
原文没有批量评测、误匹配率或实际故障恢复时间的对照数据。它支持「这套方法在演示案例中有帮助」,尚不足以证明团队接入后一定更快、更稳。作者关于失败记忆价值最高的判断,目前也应视为经验之谈。
能拿来做什么
- 先给团队复盘补上「尝试过但无效」和「造成额外影响」两项,并写清操作条件。已有检索工具也能先利用这些信息。
- 给 Node 服务或全栈应用制作排障助手时,用事故编号关联证据,保留实际发生时间,让每条建议都能追到对应记录。
- 评估 AI 排障效果时,固定模型、API 和任务要求,比较空库与历史库,并加入没有先例的告警,检查它是否会硬套旧案例。
- 让工程师确认结案事实后再写入记忆,同时展示召回原句和调用耗时。文中遇到的 403 最终来自 key 仅适用于 inference API,而非 Cloud memory API,排错时也要读响应正文。