访问日志揭示假冒爬虫与敏感文件探测
作者核验两周 nginx 日志后发现,331 次自称 Googlebot 的请求中有 119 次来自假冒来源,部分主机随后探测环境变量和 Git 文件。文章同时指出,不执行 JavaScript 的爬虫不会出现在常规前端统计中。
AI 深度解读
AI 爬虫访问网站的次数,可能已经超过搜索引擎,但访问多不等于带来流量。作者检查了自己网站两周的 nginx 日志:核验身份后,AI 爬虫发出 1,590 次请求,所有搜索引擎合计只有 563 次。
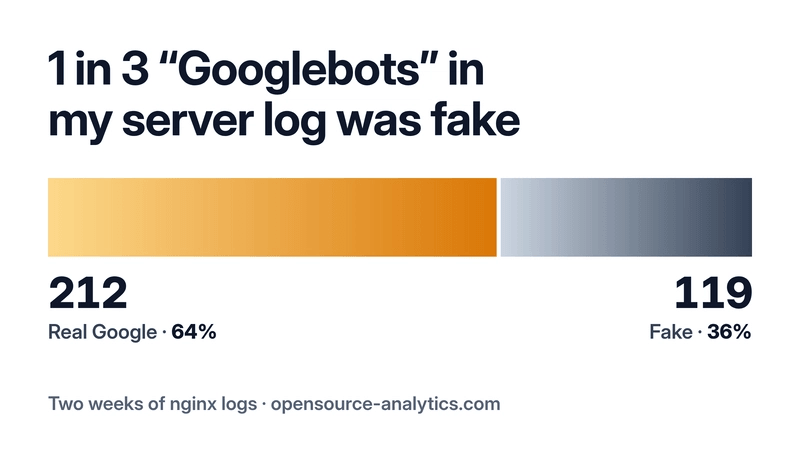
更需要留意的是冒名者:331 次自称 Googlebot 的请求中,119 次并非真正的 Googlebot。有些请求先正常读文章,随后就开始探测敏感文件。这份记录值得看,因为它把内容抓取、身份伪装和访问收益拆开了。
AI 抓取有多频繁,前端统计看不到
作者没有直接按 User-Agent,也就是请求自报的客户端名称,统计爬虫。他先筛出声称来自 AI 服务或搜索引擎的请求,再核验 IP 是否属于对应公司,只把身份通过核验的请求纳入统计。
结果是,两周内 AI 爬虫的有效请求数接近搜索引擎的三倍。Meta 的爬虫和 ClaudeBot,各自的请求数都超过了 Googlebot。
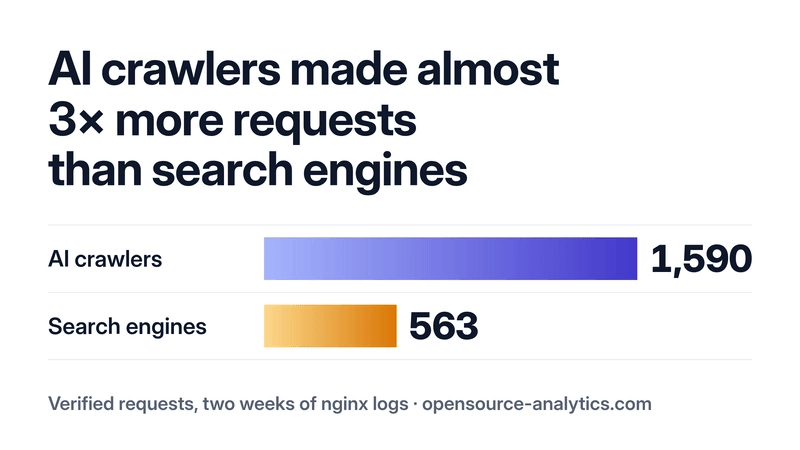
这些访问没有出现在 Plausible、Umami 或 Google Analytics 中。原因很直接:这些爬虫不执行页面里的 JavaScript,统计脚本也就不会触发。
页面统计里的访问量,覆盖不了服务器实际接收的全部请求。
对维护网站的程序员来说,这个区别很实用。分析内容被谁读取,需要看服务端日志;观察真人如何浏览,才是页面统计更擅长的部分。不过,这份数据只来自作者的一个网站、两周记录,不能据此推断整个互联网的抓取比例。
自称 Googlebot,为什么还会找 .env
作者发现,331 次标记为 Googlebot 的请求中,有 119 次来自租用的 Google Cloud 服务器,而非真正的 Googlebot。接近三分之一的请求冒用了身份。
这里要分清两件事:服务器托管在 Google Cloud,并不能证明请求由 Google 的搜索爬虫发出。云服务商的基础设施,也可以被租户用来运行自己的程序。
进一步查看行为后,作者发现 5 台服务器轮换使用了 30 个机器人名称,其中包括 ChatGPT-User 和 Claude-User。4 台服务器先访问首页、robots.txt 和约 15 篇文章,看起来像在正常抓取,随后却开始请求 .env 文件、云密钥和 Git 目录。
针对敏感文件的请求共有 1,045 次,作者的服务器全部拒绝了。这个数字属于敏感文件探测,不能与前面通过核验的 AI 抓取请求混算。
作者建议做两项检查:用反向 DNS 检查 Googlebot 身份,真实 Googlebot 的主机名应以 googlebot.com 结尾;确认 .env 等敏感文件返回 403。
robots.txt 是抓取约定,访问权限仍然要由服务器控制。
一个愿意冒充身份的程序,也没有理由一定遵守 robots.txt。前面读了多少篇正常文章,都不能成为放行后续请求的依据。
我的判断
这篇最有价值的地方,是先核验身份,再讨论访问量。只按 User-Agent 分组,既可能高估搜索引擎的抓取,也可能把敏感文件扫描误算成 AI 服务的内容访问。
但身份核验部分写得还不够完整。原文给出了 googlebot.com 的反向 DNS 判断,没有在这段材料里展开完整验证流程。实际实现时,还应把得到的主机名正向解析回 IP,确认与请求来源一致,不能只匹配主机名文本。
作者还检查了来自 ChatGPT、Perplexity、Claude 和 Gemini 的访客,两周内没有发现。它说明这次观察中,频繁抓取没有伴随可识别的来源访问;它不能证明这些产品从未引用网站,也不能证明 AI 抓取对所有网站都没有收益。原文没有交代来源识别方式,也没有更长周期的对照数据。
至于一律返回 403,真正要守住的是敏感文件无法被下载。作者报告了拒绝结果,但没有提供具体配置,读者需要自行检查。
能拿来做什么
- 维护个人博客或文档站时,可以抽取一段 nginx 日志,分别统计自报身份、核验后的身份和敏感路径请求,避免把不同性质的访问混在一起。
- 检查站点根目录下的 .env、Git 目录及其他敏感文件是否可能通过 HTTP 读取,并确认服务器确实拒绝访问。
- 评估 AI 抓取的价值时,把爬虫请求量和可识别的来源访客分开记录。抓取得多,只能证明内容被请求得多,不能直接当作获客效果。