用 Claude 做积木应用,难在结构校验
作者用 Claude 构建应用,从积木照片识别库存,再生成搭建方案和可交互的三维步骤。原型很快完成,后续工程重点是让方案符合实际积木的连接与支撑约束。
AI 深度解读
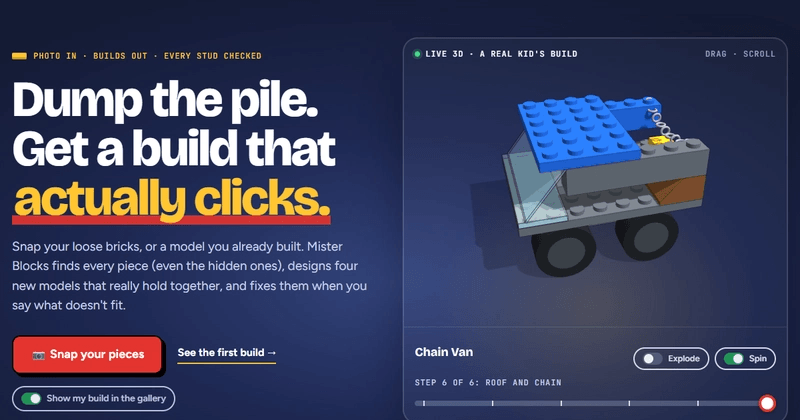
用一张散装 LEGO 的照片,生成只使用现有零件的搭建方案,还能旋转查看、逐步拼装和打印说明书。作者为儿子做的 Mister Blocks,第一版靠给 Claude 的第一个提示就跑通了,接下来几天却都花在同一个问题上:生成的积木到底能不能拼起来。
这篇最有价值的经验,是把 AI 生成接到确定性检查之后,再让具体错误驱动修复。不过,规则检查通过,距离实物牢固可靠仍有一段需要验证的距离。
能生成模型,为什么还会出现悬空积木
Mister Blocks 的技术组合很直接:没有应用框架,后端是普通 Node 编写的几个 Vercel serverless functions,MongoDB 保存会话,Cloudflare R2 存图片和 PDF,three.js 负责三维展示。
下面三个接口把识别、生成和修改串起来,也划清了各阶段的数据边界:
api/sessions/[id]/recognize   photo  -> inventory (every piece: kind, size in studs, color)
api/sessions/[id]/design      inventory -> one model (parts with x/y/z positions + steps)
api/sessions/[id]/chat        "make it a tow truck" -> a changed model, same checks
注意最后一行:聊天修改仍要走同一套检查,不能成为绕开约束的入口。
识别阶段由 Claude(Opus 5.5)看照片,输出结构化 JSON。每个零件都有编号、种类、颜色,以及用凸点数表示的尺寸、用薄板层数表示的高度。例如 B3 是砖块,P7 是薄板,W1 是轮子。数错了也能通过聊天纠正,比如告诉它「2×4 的有 48 个」,库存会更新,同时保留已有模型引用的编号。
生成阶段再把库存转换为摆放方案:x、z 使用凸点单位,y 使用薄板层数,一块标准砖高 3 层薄板,每个零件还带有所属步骤。
这些字段齐全,只能证明模型「描述得出来」。作者遇到的麻烦是,语言模型经常给出几乎正确的答案,而积木里的那一点错误,可能就是一块完全没有支撑的砖。
把错误说具体,比继续堆提示词更有效
作者把检查器写进一个普通 JS 文件 core.js,让服务端和浏览器加载同一份代码。这样,页面展示使用的规则和服务端接受模型的规则能够保持一致。
检查覆盖四类问题:零件底部是否落在下方凸点上,或直接站在桌面上;零件之间是否占用同一空间;使用的零件是否存在于库存、种类是否匹配、是否重复使用;轮胎周围是否留下转动空间。
这里的规则还包含零件形状差异。例如斜坡件只有顶部一排带凸点,不能把整个表面都当作连接位置。轮胎区域则不允许其他部件低于车台,只有轮胎自身上方的挡泥板可以例外。
检查发现问题后,不直接放行,而是把具体错误送回 Claude。下面这段循环解决的就是「第一次生成不可靠,怎样继续修」:
// lib/designer.js (simplified)
while (rounds < MAX_ROUNDS) {
  rounds++;
  const { data, message } = await askJSON({ system, messages, schema });
  model = toModel(data, inventory);
  issues = problems(model, inventory);   // "B4 is held by nothing", "P2 overlaps P5", ...
  if (!issues.length) break;
  messages.push({ role: 'assistant', content: message.content });
  messages.push({ role: 'user', content:
    `The checker found these problems:\n- ${issues.join('\n- ')}\n\nFix every one and answer again in full. Same rules.` });
}
重点看 issues = problems(model, inventory):反馈指向具体零件和具体冲突,模型接到的是可执行的修复任务。
最多运行三轮。按作者的实际观察,大多数模型一到两轮就能通过;作者也认为,这个循环对质量的帮助超过了提示词调优。但原文没有给出样本量、失败率或对照实验,因此只能把它当作项目经验。
让模型修复明确错误,比要求它提前记住所有错误类型,更容易形成可验证的流程。
提示词仍然有用,只是适合承载另一类知识。作者从儿子的真实卡车里提炼底盘做法:两个轮板前后排列,用宽度为 2 个凸点的薄板条连接,挡泥板向外偏移 1 个凸点,车台由挡泥板和中央支撑块托住。加入这些规则前,不少生成车辆的车台会压在轮胎上。
最终结构正确,搭建顺序也可能错误
还有一类问题,检查最终模型看不出来。
假设第 3 步放入一块砖,真正固定它的薄板却到第 5 步才出现。最终结构可能合法,但孩子得先用手把砖悬在空中,才能继续搭。
作者为此增加了第二遍处理 fixOrder:逐步检查新增零件能否连接到已经搭好的部分,或站在桌面上;如果不能,就把提供固定作用的零件提前到当前步骤。按作者描述的检查逻辑,提前移动不会破坏更早的步骤,后面的步骤还可能获得更多支撑,因此可以反复执行,直到顺序不再变化。
最终状态有效,不等于到达这个状态的每一步都可执行。
交互也围绕实际搭建展开。搭建页、说明书和打印视图共用一个 three.js 查看器,支持拖动旋转、滚动缩放和逐步查看;指向步骤列表时,对应零件会高亮,其他部分淡化。说明书可以打印成册或保存为 PDF,打开过的说明书支持离线使用。
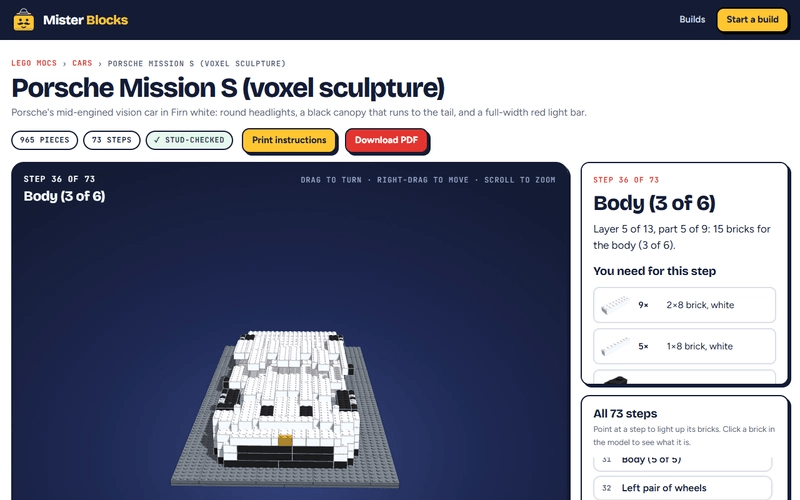
产品还提供文字描述入口。展示案例包括带机械臂的 Boston Dynamics Spot,150 个零件、13 步;SpongeBob 菠萝屋,237 个零件、18 步;Porsche Mission S,965 个零件、73 步,另有 69 个零件的版本;Mega Dragonite 则达到 1,315 个零件、121 步。
大型雕塑走另一条生成路径:先用椭球、肢体和管状结构描述三维形状,再用标准砖块填充到薄板底座上,补充明确的支撑,最后接受同样的凸点连接检查。因此,这些大模型不能直接当作「一张照片识别后生成」的效果证据。
每次生成耗时几分钟,API 调用成本约两美元。作者把每次 Claude 调用的 tokens 和费用记入 MongoDB,并设置每位访客的每日额度、全站每日预算,限制免费产品的支出。
我的判断
我赞同它对职责的划分:Claude 负责提出候选方案,代码负责检查能够明确表达的约束。相比不断拉长提示词,这种做法能积累可复用规则,也更容易定位失败原因。浏览器与 Node 共用校验代码,对前端和全栈团队尤其有参考价值。
但「通过检查」需要限定含义。原文描述了支撑、重叠、库存和轮胎空间检查,没有说明是否覆盖重心、连接强度、结构受力等问题,也没给出大型案例逐一完成实物搭建的记录。图片和三维模型不足以证明所有方案都牢固。
照片识别同样存在前提。人工可以纠正数量,但原文没说清遮挡零件、相近颜色、特殊零件的识别准确率,也没交代三轮修复后仍不合格时怎样处理。真实产品需要明确失败出口。
fixOrder 的可重复性,也应理解为作者当前规则下的性质;它没有证明所有现实装配约束都能靠「提前支撑件」解决。相比固定模板方案,这套生成流程更灵活,但也承担了识别误差、修复成本和输出波动。原文没有两者的对照数据。
能拿来做什么
- 在 Node 的 AI 生成功能里,把可枚举的错误写成校验函数,返回具体对象、字段和冲突原因,再将结果送回模型修复,并限制重试轮数。
- 当前端需要预览生成结果时,可以参考 core.js 的共享方式,让浏览器和服务端复用校验逻辑,同时由服务端决定结果是否可以保存或交付。
- 如果 AI 输出带有步骤,除了检查最终结果,还要检查每一步的依赖是否已经满足,避免得到看似完整、实际无法照做的说明。
- 为按次产生费用的 AI 功能记录 tokens 和成本,并同时设置单用户额度与全站预算;修复循环的调用也应计入其中。