26 节实验课拆解编程智能体工程
这套中文实验课程使用 TypeScript 和 Node.js,逐步构建具备文件读取、工具调用和权限边界的编程智能体。课程关注循环终止、参数校验、上下文预算、超时及规则覆盖风险,每课增加可验证能力。
AI 深度解读
会调用聊天 API,离能读文件、改代码、遇到权限边界就停下来的 Coding Agent,还有一段工程距离。作者做了一个「AI Agent 工程训练站」,用 10 个主题、26 节课,把 TypeScript 和 Node.js Agent 从模型循环一路补到安全执行,每节约 15 分钟。
它值得看的地方,是把循环终止、工具校验、上下文预算、超时恢复和授权拆成了可验收的练习。不过,这是一条学习路线,原文没有证明学完就能交付生产级 Agent,也没有给出学习效果的对照数据。
26 节课,为什么围着同一个 Agent 写
课程前 8 个主题沿着同一条项目主线推进。每一课都给已有 Agent 增加能力,后面的练习依赖前面建立的机制。这比每节换一个演示项目更容易暴露工程问题:工具接上以后,循环还能不能停?历史被压缩以后,结论还能不能追溯?
01–02 课先写 Agent 循环,再分离模型协议与运行时。以「找到失败的测试」为例,模型负责决定下一步,运行时执行工具,再把结果交回模型。fake model、Claude API 和本地推理应当共享同一份运行时契约,后续能力才不必绑死在某个模型供应商上。
03–04 课补工具契约、错误语义和文件读取范围。read_file 接到参数后,要先校验,再授权;只读操作也被限制在受控的 fixture 工作区。这里的 fixture 可以理解为练习专用的样本目录,方便检查工具是否越界。
05–06 课处理上下文:请求发出前,先给规则、任务、证据和预留输出分配预算,再裁剪工具输出、压缩历史。压缩时要留下证据指针,否则后续轮次可能只记得结论,却找不到依据。07–08 课进一步区分会话状态和长期记忆,并检查检索结果的时效与来源,避免把旧配置当成当前事实。
09–10 课把补丁流程建成状态机,并让审批绑定补丁版本。用户审阅过的内容,必须与最终写入的内容一致。11–12 课从任务最终状态构建回归集,再用执行轨迹定位失败步骤;13–14 课处理超时、重试、取消与幂等恢复,区分「没执行」「已经生效」和「结果未知」。15–16 课收束到任意命令、间接提示注入、安全回归和系统设计复盘。
课程真正训练的是:让每一步执行都有条件、证据和可检查的结果。
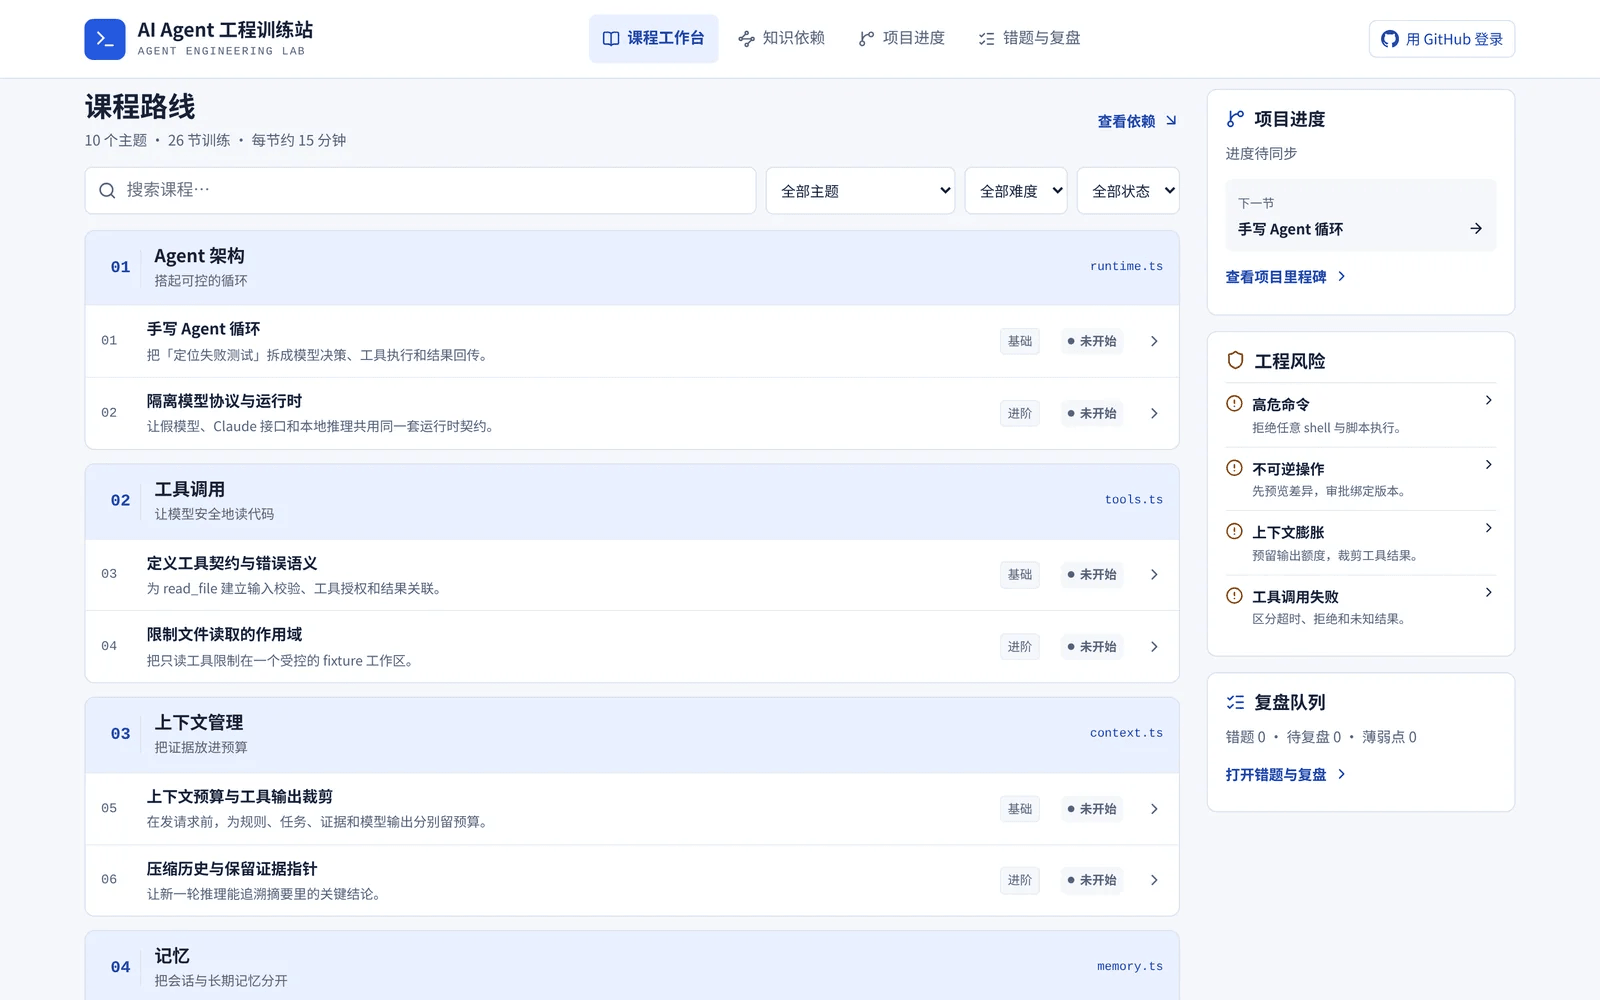
这条路线适合已经懂一点 TypeScript 或 Node.js、想亲手实现运行时的人。它也包含面试追问,要求学习者把机制解释清楚。原文明确说了,它不提供一键生成 Agent 的体验,而且不少课程需要阅读、比较和书面作答。
权限边界为什么不能只靠提示词
作者开篇提出的问题很具体:一条本来应该拒绝的工具调用,会不会被 hook 或提示词重新放行?
提示词可以要求模型守规矩,但真正执行文件读取、补丁写入和命令调用的仍是运行时。如果运行时允许后续环节推翻拒绝结果,规则就缺少稳定的执行位置。
01–16 课都设有「主流产品怎么做」栏目,按主题引用 Claude Code、Pi、OpenCode 和 DeepSeek Super-Agent 的公开文档,并附来源与核查日期。作者写作时,站内标注的核查日期是 2026 年 11 月 10 日。这些是有日期、按需选取的文档对照,每节并不都会引用全部四套系统。
17–21 课把其中一些边界变成独立练习:
- Claude Code 的 deny 和 ask 规则,仍优先于
PreToolUse的 allow 结果。 - Pi 从 JSONL 树重建当前活动分支,compaction 条目只替换模型可见的历史前缀。
- OpenCode 使用最后匹配规则,子 Agent 还有自己的权限表。
- Super-Agent 原型先让事件通过代码级准入规则,再进入 ticket 阶段。
这些说法是作者对课程已有文档引用的转述,原文没有展示一套跨产品实测结果。学习价值在于检查自己的运行时:拒绝能否被绕过、压缩是否破坏记录、子任务是否继承了不该拥有的权限。
22–26 课则单独精读 Super-Agent 架构。这里必须保留作者反复强调的限定:DeepSeek Super-Agent 是研究原型,不能当作正式发布产品。
它把长期存在、负责与人沟通及全局协调的 Router,与按 ticket 隔离的 Worker 分开。Router 使用主会话,不直接执行任务;Worker 有自己的会话、目录和完整工具集。后续课程继续讨论模型之前的准入规则、ticket 阶段与两个会话、执行前登记副作用,以及授权边界。
这一层建立在 DeepSeek Harness 的插件架构上,模型适配器、工具注册表、会话日志和 Agent 循环都可以成为插件,dsh-superagent 则是其插件包。课程还区分公开文章里的设计与原型已经实现的能力,不能把设计描述直接当成现成代码。
浏览器能跑练习,但只有三节
站点目前只有 01、05、09 课提供浏览器内 TypeScript 编辑器,可以免登录点击「Run tests」。其余课程有概念、示例、练习、验收项和面试追问,需要在自己的环境里完成,或通过阅读与作答推进。
作者描述的执行流程是:TypeScript 在浏览器里编译,代码进入仅允许脚本的 iframe,测试在 Web Worker 中运行。iframe 不共享页面 origin,练习代码不能访问站点 API 或公网,单次运行最多约 3 秒,超时由页面中止。作者采用这套设计,是为了让学习者快速开始,同时避免服务器执行用户提交的代码。
这些是原文给出的隔离机制,没有附安全审计或攻击测试报告,不能据此认定它足以承载任意不可信代码。
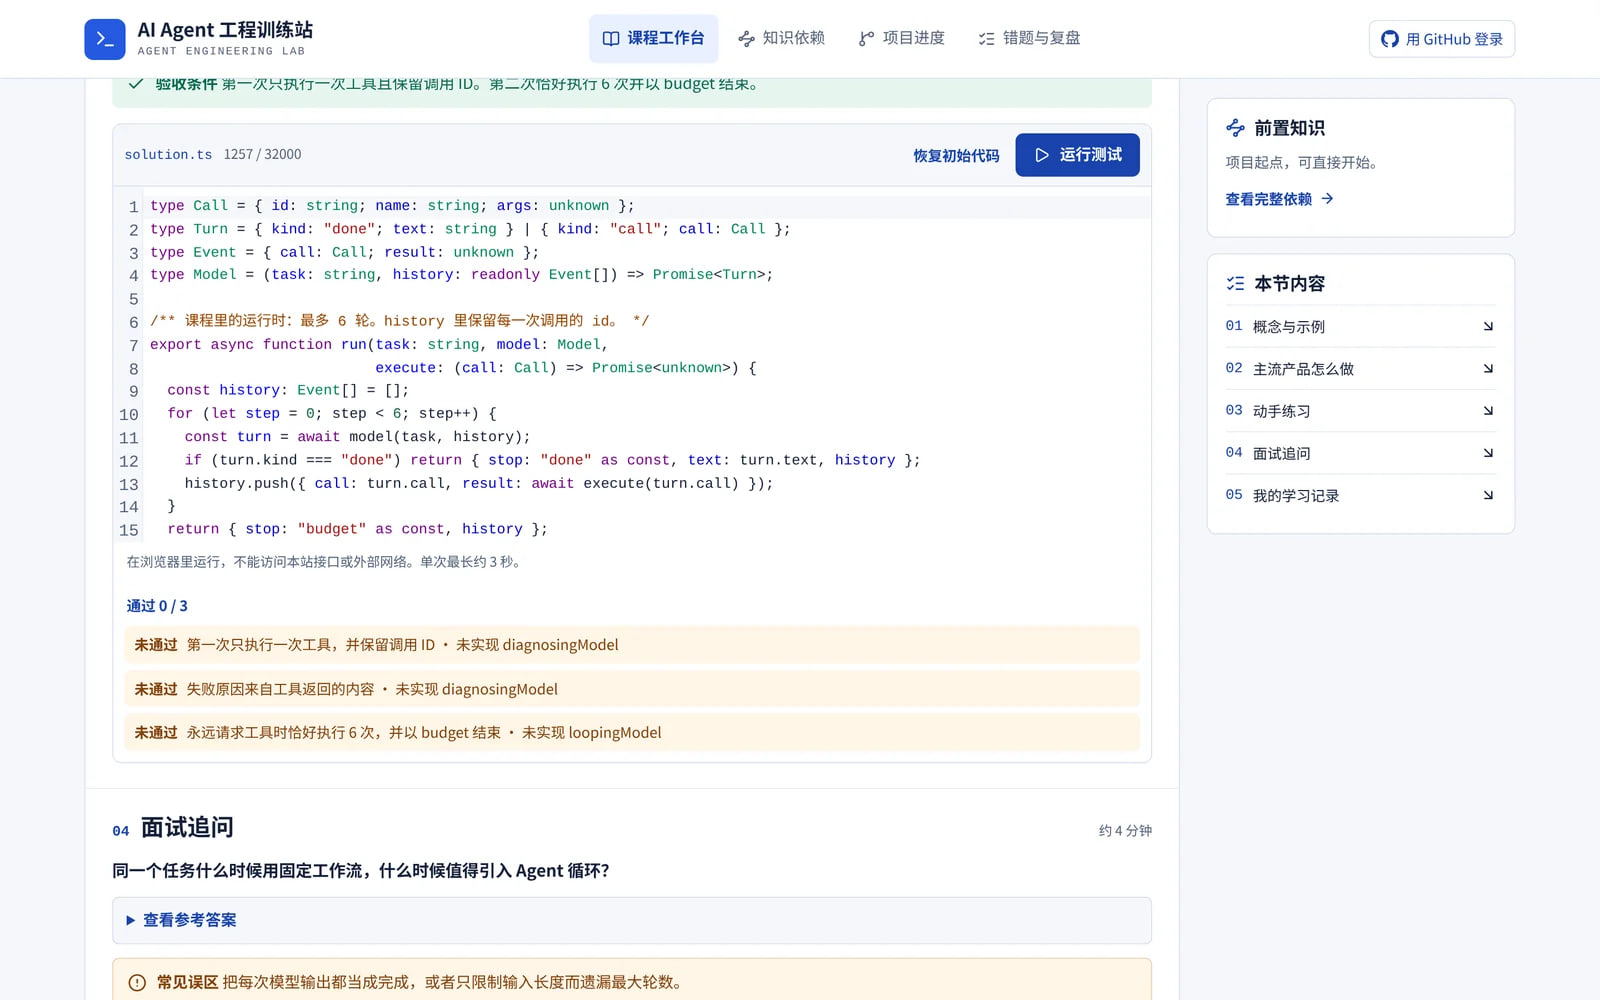
第 01 课模板故意没有实现 fake model,所以第一次测试失败是练习的一部分。补全诊断模型和循环预算后,测试才会通过。对初学者来说,这个起点比较实用:先验证循环逻辑,不必立刻接真实模型。
进度保存也有明确限制。未登录时,结果只留在当前浏览会话,刷新后不会保留;使用 GitHub 登录后,课程状态、练习代码和完成记录才会写入 Cloudflare D1,支持换浏览器继续。
站点使用 Next.js,通过 vinext 运行在 Cloudflare Workers 上,以 Drizzle 访问 Cloudflare D1。界面目前只有中文,/en 不是有效页面,首页也适配了移动端宽度。这些说明了产品的实现方式,但不是课程有效性的证据。
我的判断
我赞同它把工程约束放到学习主线上。对前端和全栈程序员来说,状态机、接口契约、超时取消、版本绑定都不陌生;Agent 的难点,是把这些机制接到模型输出后面,并承认模型可能给错参数、重复操作,或者在执行结果未知时继续行动。
其中最有用的提醒是:审批应绑定具体补丁,重试应先判断副作用状态,历史压缩应保留证据。这些要求能直接转化为验收条件,比「让 Agent 更聪明」更容易检查。
局限也很清楚。每节约 15 分钟是课程安排,原文没有学习时长统计;只有三节能在线运行,其余练习的体验和完成成本没有展开。作者也没有提供与现成 Agent 框架、纯文档自学之间的效果对照。
所以,我会把它看作理解运行时机制的训练材料。如果目标是尽快接入一个现成 Coding Agent,直接使用已有产品通常更贴近需求;如果要自己维护工具、授权和恢复逻辑,这种逐步补齐机制的路线才更对题。至于具体产品规则,使用时仍应核对对应文档,课程里的日期不能替代后续核查。
能拿来做什么
- 如果你正在用 Node.js 写 Agent,先实现一个 fake model 驱动的最小循环,验收工具结果回传和循环预算,再接真实模型接口。
- 如果 Agent 需要读项目文件或生成补丁,把路径范围、参数校验、审批版本分别写成运行时检查,并验证最终写入的补丁就是被审阅的版本。
- 如果已有 Agent 会压缩历史或重试工具,补查证据指针和副作用状态,尤其检查「结果未知」是否被直接当成「执行失败」。
- 如果你想借课程补基础,可以先做 01、05、09 课的浏览器练习,再决定是否在本地继续;需要持久保存代码和进度时,再使用 GitHub 登录。