用 Claude 接行情 API 并交叉验证回测
作者用同一份美股观察名单测试 Claude 的五项功能,并用 EODHD API 核对输出。接入数据源后,首轮 12 项数值全部吻合,生成的回测策略指标也与独立校验一致,未接入数据时 Claude 没有给出数值。
AI 深度解读
同一个问题,没接数据时,Claude 拒绝报出 4 只股票的估值和 RSI。接入 EODHD APIs 后,它给出的 12 个数与作者复核的结果全部对上。接下来,作者又拿同一份 10 只美股科技大盘股的观察名单,测试了固定格式、定时简报和分享页面,并用 Claude Code 单独跑了一次 SPY 回测。
对写代码的人,最有参考价值的是两次对账。一回差在 RSI 用了多长的历史数据,另一回差在回测从哪个收盘价开始买入。模型能取数、跑脚本,怎么算、从哪天算,仍然要在代码里交代清楚。
12 个数都对上了,为什么第一次复核却差了 0.55?
作者问的是 NVDA、PLTR、TSLA、NFLX 截至最近收盘的三个指标:过去盈利口径的市盈率(trailing P/E)、预期盈利口径的市盈率(forward P/E),以及衡量近期涨跌强弱的 14 日 RSI。Claude 没有可用的数据工具时,尝试访问网页失败,最后没有填数字。
接上 Connector 后,Claude 可以通过 MCP 调用 EODHD 的 72 个只读工具,查询价格、基本面、技术指标、财报日历、新闻和宏观数据。Claude Desktop 或 claude.ai 的自定义 Connector 使用 OAuth 端点 https://mcp.eodhd.com/v2/mcp。作者在 Claude Code 给出的接入命令是 claude mcp add --transport http eodhd "https://mcp.eodhd.com/v1/mcp?apikey=YOUR_API_KEY"。同一道题跑了 23 次工具往返,耗时 72 秒,取得了 2026 年 11 月 13 日的收盘数据。
这段 Python 从 REST API 取 RSI,用来复核 Claude 报出的数字。
import os, requests

KEY = os.environ["EODHD_API_KEY"]

def rsi14(ticker):
    # a full year of warm-up: Wilder smoothing needs it
    r = requests.get(f"https://eodhd.com/api/technical/{ticker}.US",
                     params={"api_token": KEY, "fmt": "json",
                             "function": "rsi", "period": 14, "from": "2025-11-01"})
    return round(r.json()[-1]["rsi"], 2)

for t in ["NVDA", "PLTR", "TSLA", "NFLX"]:
    print(t, rsi14(t))
要一起看 period=14 和 from="2025-11-01"。前者指定 RSI 的周期,后者决定拿多长的历史序列来做 Wilder 平滑。这个算法每天会沿用前一天的平滑结果,所以历史起点不同,最后一天也可能算出不同的值。作者起初只取了两个半月的数据,最大偏差是 0.55 点。把预热拉到一年后,四只股票的 RSI 分别是 24.86、39.46、53.54、38.43,连同两组市盈率,12 个数都对到小数点后两位。复核走的是另一条调用路径,数据源仍然是 EODHD。
Skill 把格式定住了,为什么还会漏掉财报?
作者把自己的五项检查写进 SKILL.md。Claude 遇到匹配的任务就加载这份说明,按同一套规则取数、评分和输出。
---
name: stock-checklist
description: Run Kevin's 5-point stock checklist on one US ticker with live EODHD data.
---
Use only the EODHD MCP tools for numbers. Never estimate a figure from memory.

Score each line PASS / WATCH / FAIL:
- Valuation: forward P/E < 25 PASS, 25-40 WATCH, > 40 FAIL
- Quality: profit margin > 20% PASS, 10-20% WATCH, < 10% FAIL
- Growth: revenue growth YoY > 10% PASS, 0-10% WATCH, < 0 FAIL
- Trend: close above 200-day SMA PASS, else FAIL
- Momentum: RSI 14 between 40 and 70 PASS, 30-40 or 70-80 WATCH, otherwise FAIL

Output exactly this template and nothing else: [table + "Score: N/5 PASS" + one risk sentence]
最后一行限定了交付格式,前面五项则决定 Claude 会查什么。作者对 NVDA、MSFT、TSLA、NFLX、AMD 分别做了有无 Skill 的对照,使用同一个模型和 Connector。有 Skill 的 5 次回答都遵循同一格式,25 个核对项里有 24 个精确匹配。唯一的差异是 MSFT 的 200 日均线,Claude 给出 440.70,作者算得 440.49,原文没有交代差异的原因。
11 月 16 日跑分析时,未加载 Skill 的版本查了新闻和日历,提醒 NVDA 将于 11 月 17 日公布财报。Skill 版本漏了这条,因为清单里压根没有财报日期。两组实验并行运行,耗时只能粗略参考。这次对照能看到格式约束的效果,也暴露了一个设计问题:如果风险项不在输入要求里,只给报告留一句「风险提示」并不能保证它会去查。
49 秒出的早报和能分享的页面,各自解决什么?
早报把取数交给 Python,再让 Claude 把脚本输出写成最多 120 个英文词的简报。脚本从 calendar/earnings 查未来 14 天的财报,从 eod/{t}.US 取最近 10 天里的最后两个交易日,用 adjusted_close 算涨跌幅,再从 technical/{t}.US 取 14 日 RSI。作者在 11 月 16 日手动触发一次,49 秒后得到简报,所有数字都与脚本输出一致。NVDA 因 RSI<30 被列出,同时附上次日财报日期。AMD 下跌 8.75%,触发 MOVE>=3% 的提醒。
作者给的定时示例是工作日早上 8 点,cron 表达式为 0 8 * * 1-5。每次执行都从新会话开始,提示词得自带完整要求。按作者的测试环境,桌面应用要保持打开,错过的任务会在下次打开时补跑。中途轮换 API key 也遇到了 401,原因是应用进程沿用启动时的环境变量,重启后才会读取新值。49 秒是一次手动触发的记录,作者没有连续运行几周,遇上数据延迟或缺失会怎么处理还不清楚。
Artifact 解决的是交付给别人看的问题。Claude 用一段 Python 读取保存好的数据,把 10 只股票按 RSI 排序,附上 P/E、利润率、增长率以及 30/70 区间。打开页面就能看见哪只股票跌到了 30 以下。
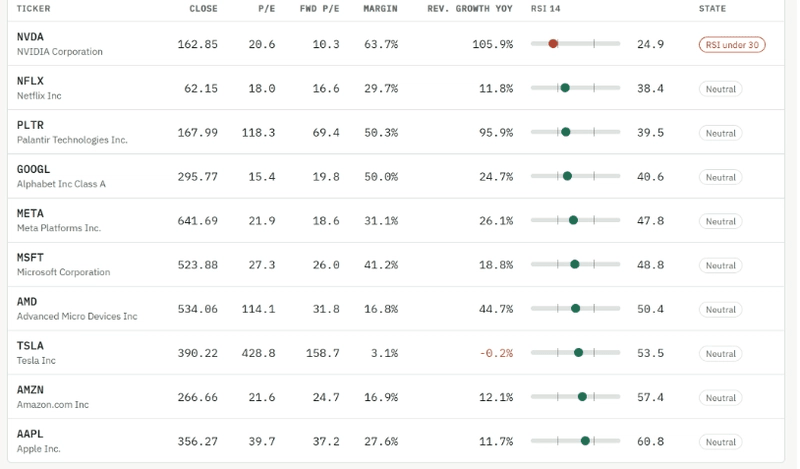
页面存的是某次拉取的快照。作者第一次发布时把偏差尚未修正的 RSI 也带了进去,页面照样生成,后来才更正数据并发布到同一链接。如果要做实时页面,取数和密钥应放在服务端,公开页面只接收要展示的数据。
回测策略对上了,基准收益为什么还能差 0.15 个百分点?
作者让 Claude Code 用 Python 跑 2016-01-04 到 2026-11-13 的 SPY 回测,从 EODHD_API_KEY 读取密钥,且不得打印。规则是前一日复权收盘价高于 200 日简单移动平均线(SMA)时持有 SPY,否则持有收益率为 0% 的现金。基准是买入并持有 SPY,两边都忽略交易成本,比较复合年增长率(CAGR)、最大回撤、交易次数和持仓天数占比。
Claude Code 用了 7 轮、71 秒,写出并跑通约 150 行代码。它把信号后移一天,避免用当天收盘后才知道的信息决定当天仓位,还额外拉取历史数据,让首日就有可用均线。作者独立写了一份脚本,策略各项指标都对上了。在这段样本里,趋势过滤把最大回撤从 -33.7% 收窄至 -19.8%,代价是年化收益少 3.2 到 3.4 个百分点,期间有 16.5% 的日子持有现金。
差在买入持有基准。Claude 的代码相当于按 2015-12-31 的收盘价买入,计入了 2016-01-04 当天的收益,作者则按 2016-01-04 的收盘价买入。仅这一个没写进提示词的选择,就让基准 CAGR 相差 0.15 个百分点。
我的判断
我认同先接数据,再决定哪些步骤交给模型。可复用的是取数、计算、写报告之间的分工。「先装 Connector」是作者按自己场景给的顺序。早报和回测直接走 REST API,如果团队已有 Node 或 Python 数据脚本,可以沿用现有入口。评分阈值和输出字段固定时,脚本也能直接判定 PASS / WATCH / FAIL 并生成表格,Skill 更适合需要通过自然语言触发、还要顺手写点评的场景。作者没有对照这两种做法的维护成本,这部分只能当经验看。
实验在 2026-11-16 运行,使用 Claude Code 2.1.216 和 Claude Opus 4.8。观察名单取的是一个交易日的截面,Skill 每种条件只测 5 只股票,模型成本也是 Claude Code 的估算。按原文列出的数据套餐,免费版每天 20 次调用,只有一年日线且没有基本面数据,复现用到的端点由每月 $99.99 的 All-In-One 套餐覆盖。原文同时附了 KEVIN10 的九折优惠码。判断接入值不值,得按自己的调用量、历史数据需求和现有数据源来算。
能拿来做什么
- 让 Node 或 Python 先取数并生成带
asOf的 JSON,再让 Claude 根据这份输出写简报。把缺数据时如何标记、哪些字段必须出现,也一并写进提示词。 - 给定期分析列出必查字段。如果财报日期会改变风险结论,就把未来 14 天的财报日历加进取数和输出要求,别只留一个开放式的风险栏。
- 用 Claude Code 写回测时,把预热窗口、成交时点、复权口径和基准起点写进任务,并让脚本输出首个信号日、首个持仓日和首笔基准收益,方便逐项对账。