从论文检索到Slack双语推送的自动化流程
实验室用 Python 定时收集论文并把候选与检索日志保存到 Google Drive,再由 ChatGPT 结合研究方向和推荐历史生成带引用的报告。systemd 服务拉取并校验报告后向 Slack 推送英日双语版本,SQLite 分别记录两种语言的发送状态。
AI 深度解读
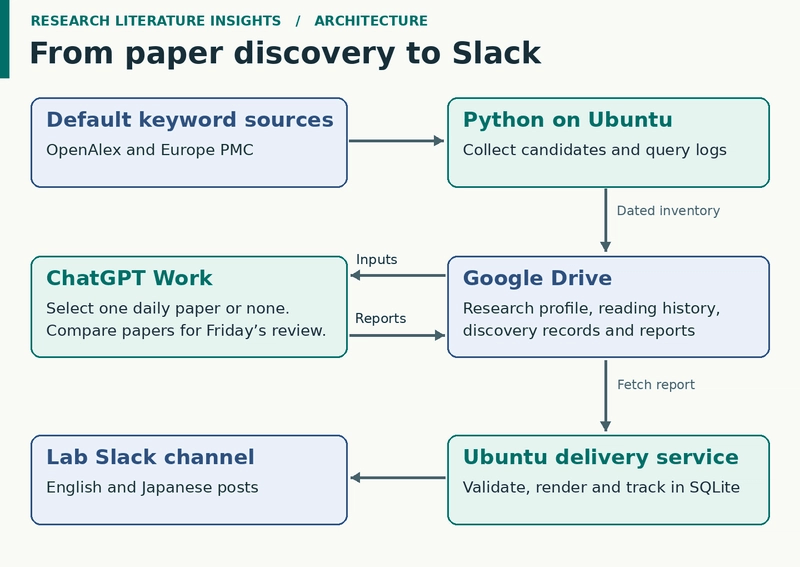
一家神经科学实验室用 Python、ChatGPT Work 和 Slack 做英日双语论文简报。周一到周四每天最多推荐一篇,周五把本周论文放在一起比较。Python 负责检索和筛选,Work 核对原始来源并解释论文为什么值得读,Ubuntu 服务负责把两种语言分别发出去。
这套流程最有参考价值的是两个细节。Python 只把 50 篇摘要交给 Work,但保留了其余候选的追查入口。Slack 投递按语言记录状态,日文请求超时后,重试可以跳过已确认送达的英文。
搜索范围要跟着团队正在做的事走
实验室原来用 4 条关键词查询,能覆盖 fMRI 解码,却漏掉了审美偏好。即便一项研究只让受试者给画作打分,也可能回答实验室关心的问题。ChatGPT 根据实验室公开的研究计划和项目提出 6 个检索方向,团队于 11 月 17 日采用。研究档案优先考虑当前研究重点,也不给各方向规定推荐配额。
Python 在 OpenAlex 和 Europe PMC 上分别执行 9 条查询,还检索 NeuroImage、Human Brain Mapping 和 Nature Neuroscience 这 3 本期刊,从 2 篇种子论文追踪相关研究和引用,并搜索相邻主题。另有 4 条较长的语义查询,用来表达完整的研究问题,比如一个人对画作的偏好能否推广到风景和人脸。
Ubuntu 上的 Python 定时任务把候选和搜索日志存入 Google Drive 的 discovery/YYYY-MM-DD.json。Work 结合研究档案、推荐历史和读书会记录阅读候选,再把附有来源的报告写回 Drive。Ubuntu 上的 systemd 用户服务通过 rclone 取回报告,经校验后用 Slack incoming webhook 投递。
只交 50 篇摘要,排在后面的论文还能找回来吗
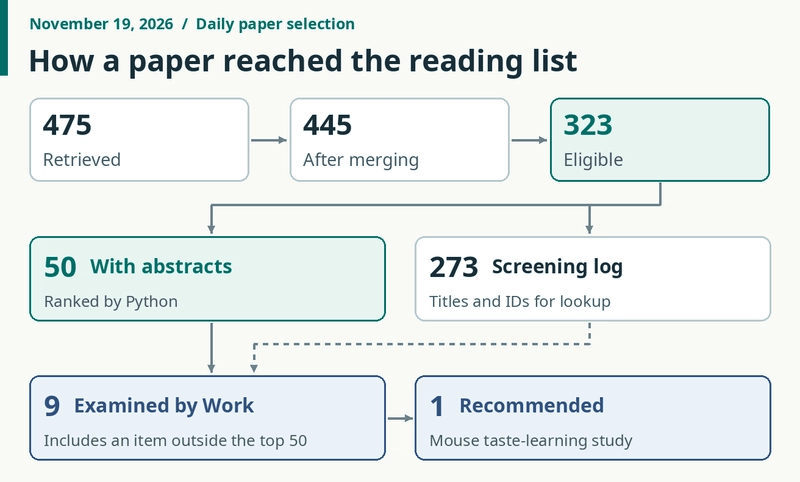
11 月 19 日,作者用真实论文记录跑了一次日报流程,关闭了 Slack 投递。Python 找到 475 条发布日期在 10 月 21 日至 11 月 19 日之间的记录,去重后剩 445 条。入选记录须有摘要,标识符须通过实验室已有资料、推荐记录和发帖记录的查重,标题或摘要还得通过术语检查。
标题命中至少 1 个预设的神经科学或研究主题术语即可通过。加入 taste 和 preference 后,行为研究也能凭标题入选。标题未命中时,摘要须命中至少 2 个不同的神经科学术语。最终有 323 条合格。排除的 122 条中,80 条只卡在术语检查,29 条只缺摘要,11 条两关都没过,另有 2 条已经推荐并推送过。
Python 根据神经科学、研究方法和主题术语的组合把候选分为 A–D 档。同一档内,主题词出现在标题加 12 分,出现在摘要加 2 分。fMRI 同时出现在神经科学和方法词表里,所以标题单凭这个词就能进 A 档。交给 Work 的 50 篇摘要全来自 A 档,另有 69 条 A 档记录排在名额之外。全部 273 条未附摘要的合格记录都在日志里保留了标题、标识符、排名和省略原因,Work 可以按标识符回到公开来源。
推荐理由和证据强度要分开判断
Work 推荐论文前至少要到原始来源核对摘要。它分别判断证据有多强,以及论文能帮实验室回答什么问题、借鉴什么方法、设计什么实验。重复验证或阴性结果也能入选。证据或相关性不足时,日报可以推荐 0 篇。
11 月 19 日,Work 细看了 9 项材料,包括 2 篇全文、6 篇摘要和 1 份数据集说明。那份审美偏好数据集来自前 50 名之外,其未标版本的记录排第 202,Work 沿标识符找到了提交者的说明。最终推荐的是 Python 排第 16 的小鼠味觉学习研究。论文跟踪了小鼠形成和逐渐消退糖精厌恶时的味觉皮层反应。实验室此前曾用人类岛叶活动模式区分基本味觉,Work 给出的阅读理由是,这项研究提供了一个可借鉴的实验思路,观察同一种味道在学习改变其价值前后的反应。
双语投递为什么要分别记状态
Work 和 Ubuntu 各有自己的运行时间。为了避免接收端读到只写了一半的日报,Work 先保存 draft-YYYY-MM-DD,读回草稿,再创建 ready-YYYY-MM-DD。生成正式日报时,Ubuntu 要找到当天各 1 个符合预期文件名的草稿和就绪标记,并检查草稿日期、status="ready" 和 test_only=false。它把 JSON 保存到 Drive 后,再下载回来,与已校验的草稿逐字节比较。周报则由 Work 在保存前校验 JSON,导出后再检查文档。
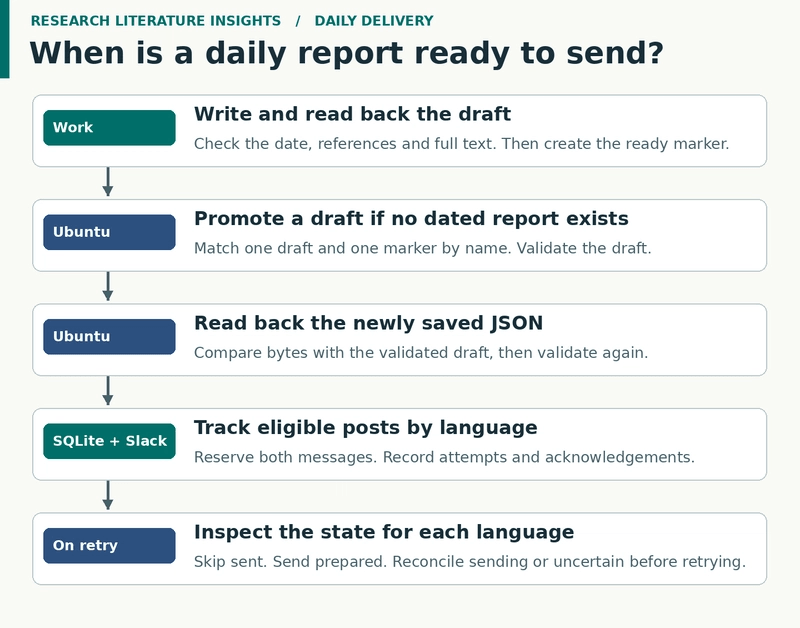
SQLite 为英文、日文分别记录投递状态。Slack 返回 HTTP 200 且响应体为 ok 后,发送器才把该语言标记为已发送。重试会跳过已确认的版本。如果请求超时、无法判断 Slack 是否收到了消息,操作者先去频道核对。两种语言都确认后,论文才写入推送历史。
我的判断
这次实跑证明了排名第 202 的记录可以被重新查阅,也展示了 Work 如何从一篇小鼠研究中提炼出与实验室相关的阅读理由。排序和推荐效果还缺对照数据。作者没有比较只看前 50 篇、让模型看更多摘要、由人直接筛选这几种做法的命中率或耗时,也没有测出相关论文的召回率。整个检索中有 22 条查询的实际返回量少于报告的命中数,清单里的 complete 只记录计划查询是否成功执行。
每天只发一篇的取舍,依赖团队能写清当前研究问题。对只想扫一眼更新的团队,按主题列标题和摘要的周报也能满足需求,人工核对原文的工作可以留给真正想读的人。投递部分也有验证边界。11 月 19 日这次实跑关闭了 Slack 发送,双语重试是作者描述的实现,原文没有给出当天的投递实测结果。
能拿来做什么
- 做前端依赖更新或 Node 技术情报简报时,把团队当前要解决的问题写进筛选档案。每条推荐同时给出原始来源和阅读理由,方便同事判断要不要点开。
- 给模型限制候选数量时,保留落选条目的标题、来源标识、排名和原因。遇到一个主题长期没有入选项,可以回查对应的搜索结果和筛选日志,看看记录在哪一步被丢掉。
- 如果多个定时任务通过共享文件交接,先读回并校验产物,再写同日期的就绪标记。需要向多个语言或渠道投递时,按目标分别保存确认状态,重试时跳过已有成功回执的消息。