用逐次写入记录审查 AI 代码
文章提出记录智能体每次写文件时的模型、理由、内容及相对前一版本的差异,辅助审查跨文件改动。它以 osFoundry 为例,解决人工与多个智能体共用工作区时难以追溯改动来源的问题。
AI 深度解读
Claude Code 或 Codex 一次改动十几个文件,测试全绿,逐行审查却可能花掉一小时。作者提出的办法是:先把 AI 的每次写入、动手前的计划和可回退状态记录下来,再决定哪些代码需要细看。
这套思路值得关注,因为它把「少读代码」变成了有条件的审查策略。不过,原文给出的是 osFoundry 的功能示例,没有提供审查效率或漏检率的对照数据。
先分清哪些改动真是 AI 写的
传统 PR 审查通常围绕 git diff 展开。但在人和多个 agent 共用工作区时,最终差异里会混入人工修复和其他 agent 的修改。git 能展示版本变化,却不能直接替你分清每次 AI 写入的来龙去脉。
作者介绍的 osFoundry 桌面应用,会在 agent 每次保存文件时,把文件内容、所用模型和模型陈述的修改理由存进本地数据库。审查界面只比较这次写入与写入前的版本。
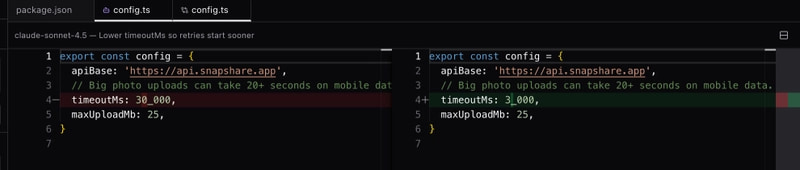
原文的例子很具体:用户要求「让重试更早开始」,AI 把 timeoutMs 从 30,000 改成了 3,000。但上方注释已经说明,大照片上传需要 20+ 秒。缩短超时会让上传提前失败,并没有正确解决重试问题。
测试仍然通过。
审查需要的不只是代码差异,还包括这次修改想解决什么问题。
把请求、理由和单次差异放在一起,更容易看出实现是否偏离意图。但「这种视图能避免漏检」仍是作者根据示例作出的判断,原文没有量化证明。
计划要能约束写入,才有审查价值
第二个办法是把一部分审查提前。代码还没写时,读一份计划,通常比事后理解整片改动更省力。
作者强调,提示词里写「先给计划」并不够。模型读到足够信息后,仍可能直接开始编辑。要让计划成为真正的关口,就得在计划获批前禁用写入工具。
这是原文对 agent 计划模式的要求,不能据此认定所有产品的 plan mode 都有同样的限制。
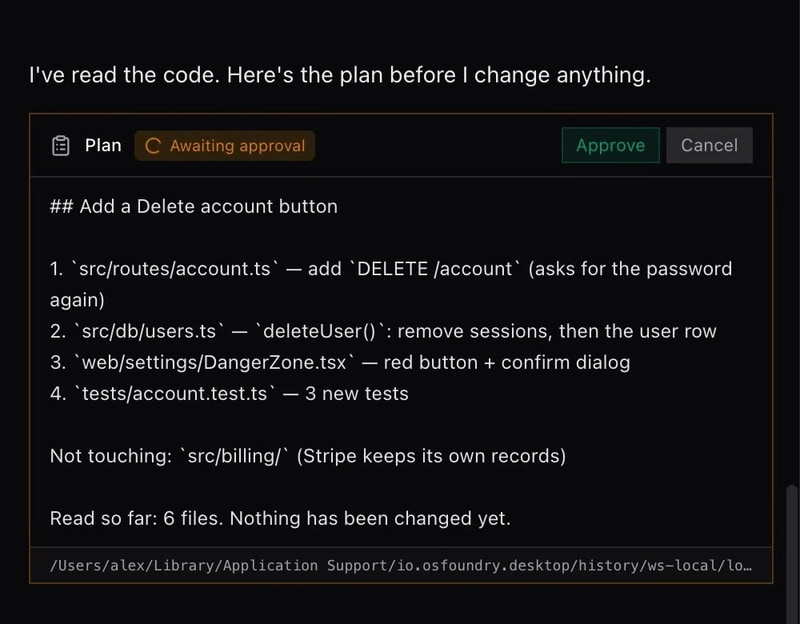
示例计划列出将修改的四个文件,还明确写了「Not touching: src/billing/」。这句话很有用:审查者提前同意修改范围,事后就可以先检查账单目录是否被碰过,再进入具体实现。
范围检查不能替代逻辑检查,但能先拦住一类问题:需求只涉及重试,agent 却顺手改了账单代码。
按轮次回退,让运行验证更有余地
第三个条件是能撤销。作者认为,如果每轮改动都可以单独回退,审查就不必承担「事先挡住所有错误」的全部压力。可以先运行,再重点查看行为异常对应的代码。
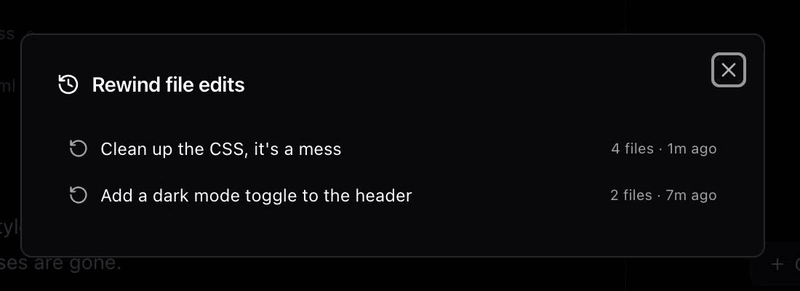
示例界面用每次请求的第一行标识轮次。选中一轮后,它修改过的文件会恢复,新建的文件会删除,人工编辑的文件则保留。
这里要区分文件恢复与业务恢复。原文描述了文件层面的撤销,没有交代数据库迁移、外部请求等副作用如何处理,也没有说明人工和 AI 交叉修改同一文件时的冲突规则。
因此,可回退能降低试运行的成本,却不能自动覆盖运行代码产生的所有影响。
我的判断
我赞同作者把审查拆成三个问题:进来了什么、是否符合约定、能否撤销。相比只看最终 git diff,这种记录方式更适合多人和多个 agent 交替修改的工作区。
但这里有两个前提。第一,记录必须完整,模型提供的理由也只能作为线索,不能当作正确性的证据。第二,回退边界必须清楚,尤其要知道哪些影响超出了文件系统。
常见的独立分支、小 PR 和频繁提交,也能帮助隔离改动、缩小审查范围。逐次写入记录补充的是更细的操作过程;如果团队本来就把任务切得很小,它的额外收益还有待验证。
少读代码应当是证据更充分后的结果。
原文没有给出对照实验,也没有证明这套流程比传统审查更安全。它更适合作为工作流设计经验,而不是取消逐行审查的依据。
能拿来做什么
- 给 Claude Code 或 Codex 分配任务时,要求计划列出预计修改的文件和禁止触碰的目录,并确认所用工具是否真的在批准前阻止写入。
- 遇到上传、超时和重试相关改动时,把用户目标、参数变化和已有注释放在一起检查,并验证真实耗时场景;测试通过不足以证明需求已经实现。
- 人工与 agent 交替修改代码时,保留每轮请求及对应差异;工具没有逐次记录能力,就用更小的任务和提交降低混杂程度。
- 在采用「先运行、再重点审查」前,确认单轮撤销能恢复哪些文件,以及哪些运行副作用需要另行处理。