模型调用先用低档推理,失败再升级
Anthropic 内部编程测试中,先用低推理强度、失败后再用高强度重试的策略,成功率约为 97%,平均每题约 0.17 美元,全程使用高强度则为 95.3% 和 0.29 美元。文章还介绍了提示词缓存、批处理和按任务难度分配模型。
AI 深度解读
AI 账单要降下来,先检查是不是每一步都用了最高档模型、最高推理强度,还反复发送同一份长上下文。作者的核心建议是:先调低 effort,让能自动验收的任务失败后再升级,再考虑缓存、批处理和便宜模型分工。
这份清单的价值,在于把省钱动作排出了先后。但其中的效果数据主要来自 Anthropic 内部测试,免费模型也没有质量和可用性实测。可以借它设计实验,不能直接把节省比例写进团队预算。
先降低推理强度,失败后再升级
AI 费用主要来自输入和输出 token。原文列出的 Anthropic 价格中,强模型每百万输入、输出 token 分别为 4、20 美元,最小模型为 0.10、0.50 美元。除了选哪个模型,模型思考多久、写多少、重复读多少内容,也会改变账单。
effort 控制模型投入多少推理工作。Anthropic 的档位包括 low、medium、high、xhigh、max,影响范围包含思考、工具调用和回答。OpenAI 对应参数是 reasoning.effort,原文列出的范围是 low 到 max;推理 token 按输出收费,但没有给出不同档位的成本降幅。
Anthropic 在 Claude Opus 5.5、SWE-bench Pro 子集及自有基准上的内部测试,给出了这组结果:
| 策略 | 任务解决率 | 每个任务费用 |
|---|---|---|
| low | 87.4% | 0.11 美元 |
| medium | 92.8% | 0.21 美元 |
| high | 95.3% | 0.29 美元 |
| 先 low,失败后 high | 约 97% | 约 0.17 美元 |
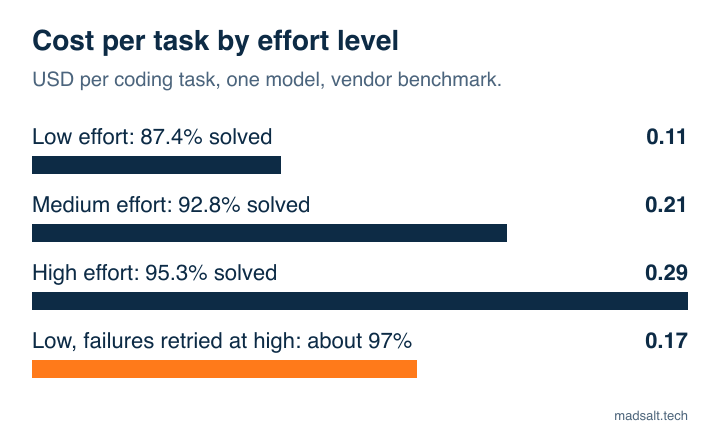
同一指南还称,在长编程任务上,medium 比 high 便宜约 30% 至 52%,low 便宜约三分之二。作者建议从 medium 开始测,再逐步降低,避免模型证据还没收集够就结束任务。
更有用的是重试策略:先让全部任务跑 low,再把约 13% 的失败任务交给 high。厂商将其概括为同等通过水平下约省 40%;表里的最终解决率其实也不完全相同。
失败后升级的前提,是系统能可靠地识别失败。
测试失败、表单校验不通过、必填字段缺失,都能触发重试。代码只是表面合理、实际需求理解错了,就未必能被拦住。判断不出失败,这套策略便缺了关键环节。
长上下文和长回答,也在持续收钱
重复发送的系统指令、文档和工具列表,适合优先检查缓存。原文称,Anthropic 缓存读取价格通常是普通输入的 10%,最新 Opus、Sonnet 为 5%,首次写入则稍贵;OpenAI 的 GPT-6.1 Sol 缓存输入价格为普通输入的 5%。
Anthropic 内部研究代理测试报告了成本降至原来的约 1/4.8 至 1/7.2。这里最具体的教训是一行只有 25 token 的状态信息:因为它放在提示词开头,而且每次变化,导致整个缓存反复重写。稳定内容放前面,变化内容放后面,才有机会复用共同前缀。
再检查每次到底需要读什么。原文没有单列第 7 条标题,但压缩输入是独立的省钱办法:小型分流代理删减输入后,费用再降 21% 至 26%;挂载 500 个工具时,按需加载工具定义节省了 45%。这些仍是厂商测试结果。
长输入还可能跨过价格门槛。原文称,Haiku 5.5 的提示词超过 100,000 token 后,价格变成 5 倍。因此,清理无关历史消息和工具定义,也是在控制计价档位。
输出同样值得收紧。原文列举的价格中,输出单价约为输入的 5 倍。Anthropic 测试里,要求简短回答减少了 39% 的输出 token,最终费用降低约 13%。两者不会同比下降,因为输入等费用依然存在。明确要求「只返回 JSON」或「三句话回答」,比默认生成长篇解释更适合固定接口。
能等的任务则可考虑 batch API:两家厂商都提供 50% 折扣,等待时间可达 24 小时;Anthropic 还允许叠加缓存折扣。它适合隔夜报告、分类、批量提取,交互请求仍要考虑等待体验。
便宜模型和多代理,什么时候才划算
作者自己的做法,是让 Claude 或 Codex 规划和检查,把大量简单工作交给 OpenRouter 免费模型,同时按任务调整 effort。
OpenRouter 用统一 API 接入不同供应商,免费条目带有 :free。原文列出的限制是每分钟 20 次请求;累计购买额度不足 10 美元时,每天 50 次,达到 10 美元后每天 1,000 次,失败请求也占每日额度。
2026 年 11 月的免费列表包括 NVIDIA Nemotron 3 Ultra、Nemotron 3.5 Super VL、Cohere North Mini Code、Google Gemma 4。列表每周变化,部分免费条目会到期,作者也没有测试这些模型的质量或在线稳定性。
数据政策还要分两层看:原文称,OpenRouter 默认不保存提示词,除非用户选择加入;下游供应商另有政策,部分标记为可能用于训练。作者因此把免费模型用于公开或匿名化文本的摘要、分类和初稿,客户资料不放进去。
多代理也有明确的适用边界。Claude 子代理可独立指定模型,Codex 提供 default_subagent_model 和 default_subagent_reasoning_effort。但 Anthropic 测得「强模型协调、中型模型执行」便宜约三分之一、分数相近,前提是工作量超过一个上下文窗口。
如果任务是一条前后依赖的链,或者单个上下文就装得下,该测试中始终是单模型降低 effort 更便宜。拆任务、传上下文、汇总和检查,都有额外成本。
另一个容易漏掉的选择是席位订阅。原文列出 ChatGPT Business 和 Claude Team 标准席位月付每人 25 美元,年付折合每月 20 美元,10 个年付席位一年 2,400 美元。低频使用者可能更适合带消费上限的内部 API 工具;每天使用的人,则需要比较席位实际覆盖的功能和额度。
我的判断
我赞成先调 effort、输入和输出,再考虑复杂分工。对编程任务而言,这几项改动容易局部试验,也更容易定位质量下降的原因。直接搭多代理系统,会把成本问题和编排问题混在一起。
但「便宜一轮」不等于「便宜地完成任务」。应该把失败重试、验收调用和人工返工计入每个合格结果的成本。特别是先 low 后 high,收益取决于验收是否可靠,不能只看模型单次报价。
作者有实际工作经验,但具体节省比例主要来自厂商基准,没有提供自己的完整账单或统一对照实验。免费模型与付费模型之间,也缺少同任务质量、稳定性和返工成本对照。因此,哪些比例能复现,目前只能留待团队自己验证。
原文价格采集于 2026 年 11 月 9 日,还提到两项促销分别在 2026 年 11 月 30 日、12 月 31 日结束,却没交代对应项目。预算应采用实际结算价格,不能把这些数字当作长期承诺。
能拿来做什么
- 对有自动测试的前端或 Node 编程任务,固定模型比较 medium 与 high 的通过率和总费用,再试验失败后升级;把重试和人工修复一起记账。
- 检查 AI 接口的提示词结构,将固定指令、公共文档放在前面,变化状态放到末尾,并记录缓存命中情况。
- 为分类、提取等固定任务约束输出格式,清理无关历史消息和工具定义;允许等待的批量工作,再评估 batch API。
- 用公开或匿名化样本验证便宜模型的摘要、分类能力,记录失败与返工;只有任务确实需要拆分时,再引入强模型协调的多代理方案。