Codex 日志为何造成大量 SSD 写入
文章回顾一例 Codex 日志异常:数据库仅约 1.2 GiB,却持续高速插入和删除记录,报告者的 SSD 在约三周内累计写入约 37 TB。作者同时指出,相关问题已于六月报告、七月关闭,十一月的传播容易掩盖事件时间线。
AI 深度解读
SSD 还剩多少空间,和它每天承受多少写入,是两回事。一份始终只有 1.2 GiB 的 Codex 日志数据库,就被用户指认为机器在 21 天内写入约 37 TB 的主要来源。文件没长大,磁盘却一直在忙。
作者从这起故障出发,做了 macOS 菜单栏工具 Disk-O-Meter。更值得程序员借鉴的,是它背后的排查思路:观察写入增量、追踪责任进程,再用日常基线设置告警。不过,37 TB 来自一名 Linux 重度用户,不能直接套到你的 Mac 上。
日志只有 1.2 GiB,为什么能写出 37 TB
2026 年 6 月,一名 Codex 用户在 openai/codex 仓库报告:~/.codex/logs_2.sqlite 约占 1.2 GiB,保存 506,149 行,但分配新行 ID 的计数器已经超过 55 亿。观察 15 秒,又插入了 36,211 行,总行数却没变,因为旧记录同步被删除。
文件大小描述的是留下多少数据,累计写入描述的是改写过多少数据。
SQLite 使用预写日志(WAL)时,修改先进入 logs_2.sqlite-wal,之后通过 checkpoint 合并到主数据库。数据页因此会经历两轮写入,索引更新、删除旧记录也会修改页面。日志轮转限制了容量,却没有限制写入量。
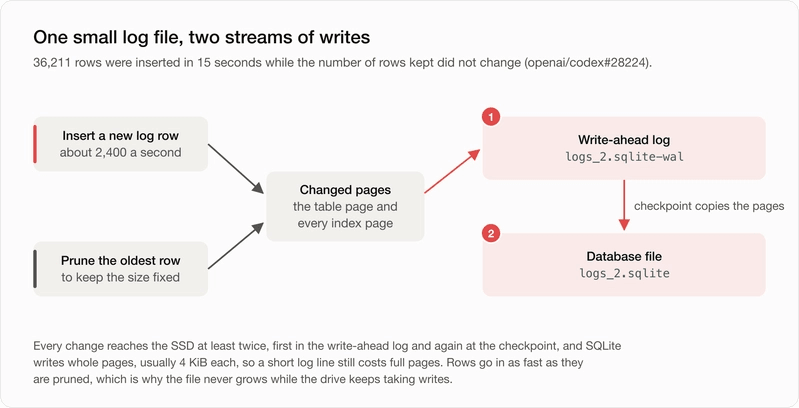
报告指向的关键配置是 Targets::new().with_default(Level::TRACE)。它让写入 SQLite 的日志接收端默认收集所有来源的 TRACE 消息,包括依赖库。这个级别适合临时追查细节,长期打开就可能把内部轮询也逐条落盘。
样本中,打开 ld.so.cache 的一条消息重复出现 128,764 次;数据库保留内容里,TRACE 占了 70.7% 的字节,其余大部分是 INFO,其中不少是镜像记录的遥测信息。问题并非日志保留太久,而是入口一直在接收大量低价值消息。
按 37 TB/21 天外推,一年约为 640 TB。对部分标称 600 TBW 的 1 TB 消费级 SSD,这相当于约 11 个月触及保修耐久量。TBW 是累计主机写入的耐久指标,并不是到点必坏的倒计时;这组推算也只代表那台机器持续保持相同负载的情况。
为什么常用工具没让人提前发现
Finder、系统储存空间页面和 du 都在回答「现在存了多少」。数据库长期稳定在 1.2 GiB,它们就会持续给出看似正常的结果。
Activity Monitor 的 Disk 页能按进程写入量排序,但数字从进程启动开始累计,退出后消失;iostat 能观察吞吐,却需要主动运行;smartctl 能读取硬盘终身累计写入,但单看一个总数,很难知道最近一周是否异常。
这些工具各有用处,缺少的是连续历史和主动提醒。
Disk-O-Meter 每 15 秒读取一次 I/O Registry 中 IOBlockStorageDriver 的 Bytes (Read)、Bytes (Write)。下面这条命令可以直接查看相同的底层计数:
ioreg -c IOBlockStorageDriver -r -k Statistics | grep -E 'Bytes \((Read|Write)\)'
要看的是两次运行之间的差值;这些计数从开机开始累计,重启后归零。
应用把增量归入当天、当小时,并保存计数值和启动会话 ID。同一次开机内退出再启动,可以补上中间的增量;重启或外接盘重新连接时,则识别新的计数周期。Apple silicon 内置 SSD 的多个 NVMe namespace 会合并统计,外接盘通过序列号维持历史。
菜单栏默认显示当天写入,例如 27.9 GB,也可显示最近 15 秒的速率,例如 12.4 MB/s。Usage 页支持按日、自然周、自然月或自定义日期查看;一天内按小时画图,更长周期按天画图。持续整夜写入的进程,会比一个静态文件大小显眼得多。
找到写入进程后,告警才有用
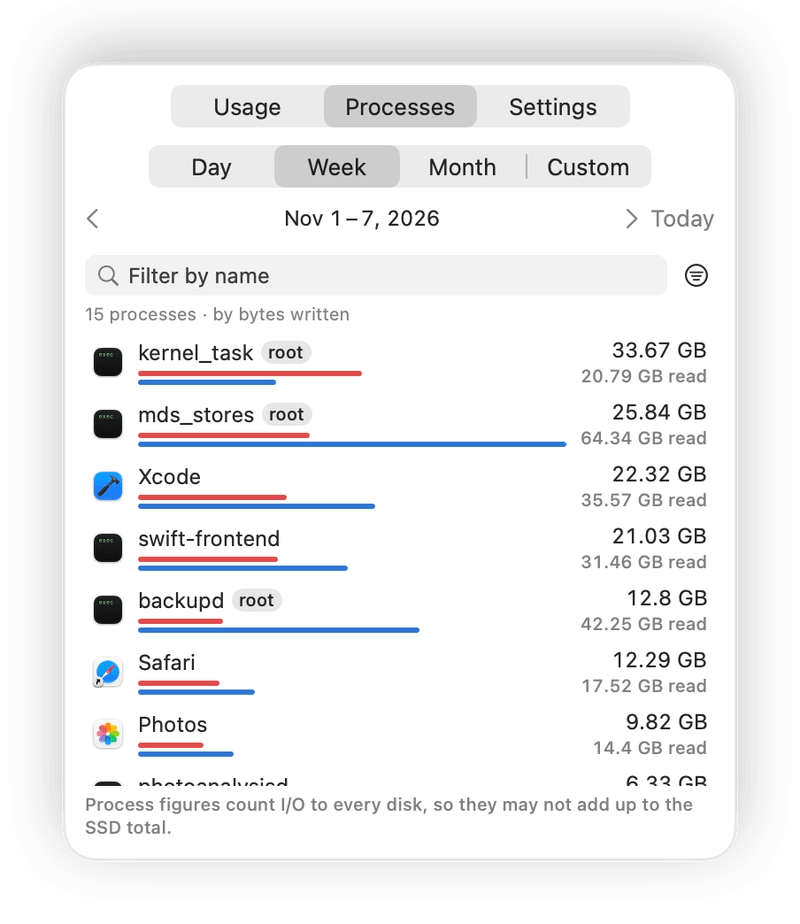
Processes 页同样每 15 秒通过 proc_pid_rusage 读取进程累计 I/O,以 PID 加启动时间区分进程,再把增量按程序名汇总,避免 PID 重用造成混淆。
普通权限可以看到同一用户的进程,因此理论上能发现用户启动的 Codex。这里必须保留作者的限定:工具在修复发布后才开发,作者没有用旧版 Codex 在自己的 Mac 上复现。
对于 mds_stores、backupd、softwareupdated 等 root 守护进程,应用提供可选 helper,经用户批准后由 launchd 运行。作者称,发布版 helper 只接受同一开发者团队签名的客户端请求。
即便如此,进程合计也不等于磁盘总量:部分写入没有明确进程归属,采样间隔内启动并退出的程序会漏掉。应用把差额显示为 Other / unattributed,保留不确定性。
告警最多设置两条,分别指定某块盘在自然日、周或月的写入上限,例如内置盘每天 50 GB、外接备份盘每月 1 TB。每 15 秒检查一次,越限后菜单栏变红,每条规则每个周期通知一次。
37 TB/21 天约为每天 1.76 TB,相当于全天持续约 20 MB/s。按这个平均速度,50 GB 会在午夜后约 40 分钟、图示约 0:41 时用完;即使只有十分之一速度,也会在早上七点前越限。这是算术推演,并非作者实测的告警时间。
作者建议先无告警运行一周,再把阈值设在繁忙日之上。50 GB 是示例,不是所有开发机的健康标准。
这些数字能说明什么,不能说明什么
Disk-O-Meter 统计的是主机写入,即电脑要求 SSD 保存的数据量。SSD 控制器还会因垃圾回收、磨损均衡产生额外物理写入,这叫写入放大。Apple SSD 没有公开这个倍率,应用无法据此算出闪存的实际磨损;Apple 也没有公布其 SSD 的 TBW 评级。
记录本身还有边界:首次启动只建立基线;跨重启且应用未运行的时段无法补齐;崩溃或强制关机最多可能丢失最近五分钟未保存的数据。存活不足 15 秒的进程可能漏采,进程计数又包含外接盘写入,因此不能把它全部归到内置 SSD。应用仅支持 macOS 26 或更高版本。
作者还给出独立核对方法:
brew install smartmontools
smartctl -a disk0 | grep 'Data Units Written'
要看第二行返回的计数增量,每单位为 512,000 字节。用一周增量乘以这个单位,再和应用同期内置盘写入比较;持续明显偏差,可能提示应用未运行期间仍有写入。
我的判断
我认同把日常观察从容量扩展到写入量。对长期运行的 AI 编程工具,日志保留上限只解决空间占用,日志级别和产生速率才决定持续 I/O。这个案例很适合用来检查「默认开启详细诊断」的代价。
但原文没有提供跨机器对照、工具自身开销测试,也没有修复前后的 Mac 实测。案例中的 ld.so.cache 和 inotify 指向 Linux;问题 6 月报告、7 月关闭,不能拿它证明当前 Codex 仍在普遍产生同样写入。
Disk-O-Meter 是 MIT License 的免费工具,提供签名、公证的 DMG 和 ZIP,优势在于省去手工记录。若只是临时排查,Activity Monitor 配合磁盘计数差值也有价值。两者主要差在持续记录和提醒,原文不足以证明其能延长多少 SSD 寿命。
能拿来做什么
- 检查长期运行的 AI 工具和 Node 服务的日志配置,确认 TRACE 是否默认开启、依赖库是否产生重复消息,并观察日志轮转后的实际写入量。
- 遇到日志文件不大但磁盘持续繁忙时,同时采样磁盘总写入和进程累计写入,先按增量定位,再检查 SQLite WAL、索引和清理频率。
- 在正常工作负载下连续记录一周,把安装依赖、构建、备份等繁忙时段纳入基线,再设置高于繁忙日的告警阈值。
- 在支持的 Mac 上,用
smartctl的一周计数差值核对监测结果;先弄清统计遗漏,再讨论耐久风险。