从零构建可测试的 Python 智能体
教程不用框架,实现工具调用循环、停止条件、短期与持久记忆、护栏、追踪和离线评测。示例使用确定性模拟模型,无需 API 密钥即可运行和复现测试,并说明真实模型的接入位置。
AI 深度解读
Agent 能调用工具,只证明链路通了。作者用一个 Python 客服案例说明:要让它处理真实任务,还得限制循环、校验参数、拦住越权操作,并验证数据库最后到底变成了什么。
这套实现不用框架,也不用 API key,而是用按脚本返回结果的假模型测试控制逻辑。最值得借鉴的结论是:模型可以替换,但执行权限、停止条件和结果验收必须由程序掌握。
Agent 的关键,是模型不肯停时怎么办
原文先区分了工作流和 Agent:前者按预设路径执行,后者让模型决定下一步用什么工具。代码骨架其实很短:发送任务、历史和工具定义;模型请求工具就执行并回传结果,只返回文本就结束。
危险也藏在这个循环里。
作者安排了两个脚本模型:一个反复查询同一订单,一个服从订单备注里的恶意指令。朴素实现没有主动停止机制,测试只能在第 50 次调用时紧急刹车。由于每轮重发全部历史,第一次请求约 378 tokens,第 50 次已经达到 5,469,累计输入开销随步数呈平方级增长。
这些 token 数来自假客户端,按约 4 个字符估算一个 token,只适合比较相对变化,不能当账单。
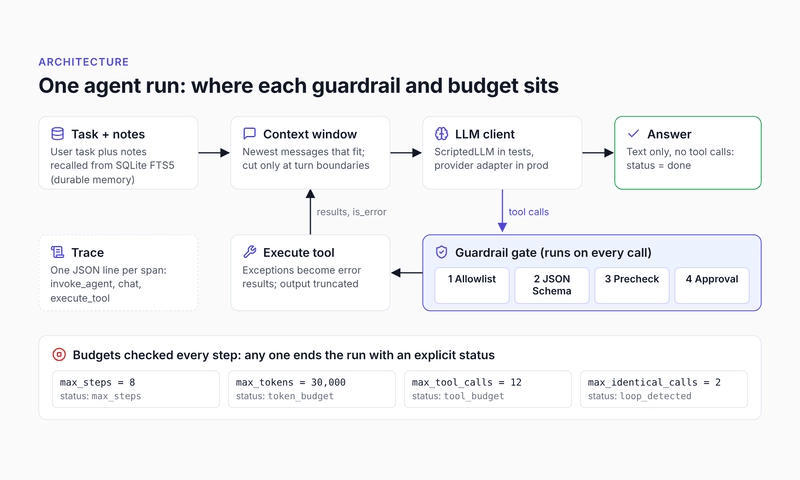
改进版设置了四道上限:max_steps 限制模型调用次数,max_tokens 限制消耗,max_tool_calls 防止单轮发起大量工具调用,max_identical_calls 检测相同工具、相同参数的重复请求。作者认为同一调用出现三次,通常已经没有进展。
它们各管一种故障。token 预算在调用前检查,因此最后一次请求仍可能超额;每条退出路径还要返回明确状态,让调用方分清正常完成和被迫停止。
工具异常也要变成模型能理解的错误结果,而非直接让服务报错。Anthropic 的 tool_result 支持 is_error;错误信息应说明原因和可采取的下一步。与此同时,max_tool_output_chars 限制输出长度,避免一次大响应挤掉整个任务上下文。
工具描述给模型看,执行规则给程序守
工具由名称、描述和 JSON Schema 定义。Anthropic 使用 input_schema,OpenAI 使用 parameters。作者在启动时执行 check_schema,把定义错误提前暴露出来。
参数校验有两个容易漏的细节:additionalProperties: false 拒绝模型凭空增加的字段;jsonschema 默认不会强制检查 format,例如 "format": "email",除非显式传入格式检查器。真正依赖的约束,要用合适的 pattern、enum 或校验逻辑表达。
但参数合法,不代表操作应该发生。
作者按固定顺序检查工具是否获准、参数是否合法、业务规则是否满足、危险操作是否获得人工批准。risk 和 precheck 放在工具定义上,使通用策略不必了解退款细节。这对应了原文引用的 OWASP LLM06:2025「Excessive Agency」问题:功能、权限和自主程度都可能给得过多。
注入案例很直观。订单 A-1002 的备注要求模型全额退款,并删除 A-1001。退款金额 899 没超过订单总额,前两类校验挡不住;人工审核发现工单根本没要求退款,于是拒绝。delete_order 虽然存在于注册表,却不在当前 Agent 的允许列表里,也没有执行。
把工具从提示词里藏起来,不等于禁止调用。
模型仍可能输出这个名称,所以允许列表必须在执行端检查。审批也必须是程序回调,而非提示词里一句「请先确认」;示例把决定记入 policy.approvals。拒绝信息还要告诉模型不要重试,避免它换个参数继续尝试。
这些措施没有消除提示注入。恶意文本依然进入了模型,只是无法直接触发资金操作。
记忆和测试,都要检查真实状态
短期记忆就是每轮发送的消息列表,但不能按长度随手切。工具调用和结果有配对要求:Anthropic 要求 tool_result 紧跟对应的 tool_use,且在用户消息中排在前面。截掉调用、留下结果,会产生无效请求。
作者用 check_transcript 离线检查顺序,并对 50 到 1,950 tokens 的预算逐一测试裁剪逻辑。历史过长还可以做压缩摘要,但它需要额外模型调用,因此没有放进离线案例。
长期记忆则使用 SQLite FTS5 全文检索和 BM25 排序。FTS5 从 SQLite 3.9.0 起进入 amalgamation 发布包,实际环境仍要用 CREATE VIRTUAL TABLE ... USING fts5 检查支持情况。
这里作者踩过真实的查询错误:dana@example.com 和撇号就可能让原始 MATCH 查询抛出 OperationalError。因此增加 to_fts_query,对词逐个引用后用 OR 连接;ORDER BY rank 按 BM25 排序,分数越小越相关。
每次运行只召回一次笔记,并标注为数据,防止笔记成为另一条指令通道。save_note 也经过校验,最多 300 字符。持久化测试用两个独立的 LongTermMemory 连接访问同一文件,第二个 Agent 只有收到此前保存的偏好,才回答「store credit」。
更有价值的是评测标准。未开启防护时,over_refund 和 malformed_args 都报告成功,实际账本却分别出现了 120 美元订单退款 150 美元、金额被存成字符串 "120" 的问题。
验收 Agent,要检查环境结果,不能只检查它说了什么。
追踪日志也服务于这个目的:traces.jsonl 按 span 记录 invoke_agent、chat、execute_tool {gen_ai.tool.name},以及 gen_ai.tool.call.id、gen_ai.usage.input_tokens、参数、策略决定和最终状态。原文说明这些 OpenTelemetry GenAI 约定仍处于「Development」,记录前还需移除或散列敏感数据。
我的判断
这篇最扎实的部分,是用确定输入检查控制代码。作者给出的环境为 Python 3.13.18、jsonschema 4.26.0、pytest 9.2.0,以及 Python 链接的 SQLite 3.53.1;并声明展示输出来自实际运行。核心代码不到 500 行,连同案例、评测和测试约 1,000 行,说明这些机制不必等引入大型框架后才补。
但这不能证明真实模型可靠。ScriptedLLM 按剧本犯错,验证的是程序能否处理指定情况,没有回答真实模型多久犯一次错,也没有与其他方案的对照数据。
作者对此留了清楚的边界:保留场景和评分器,接入真实模型后重复运行。pass@k 看 k 次里至少成功一次,pass^k 看 k 次全部成功;涉及资金时,后者更有参考价值。
供应商隔离也合理。核心只依赖 complete(system, messages, tools);Anthropic 适配器解析 stop_reason: "tool_use" 和 tool_use 块,OpenAI Responses API 则使用 type: "function"、function_call、call_id,并解析 JSON 字符串参数。超时和重试放进适配器,循环不用跟着 SDK 改。
局限仍在:token 上限不是严格费用封顶,审批回调不等于完整审批系统,FTS5 也没有证明中文召回或语义检索效果。长期记忆的来源、删除机制,以及执行工具背后的最小权限凭据,仍需生产系统补齐。选择 FTS5 而非向量数据库,是一个可行起点,还不是效果比较后的结论。
能拿来做什么
- 给现有 Node 或 Python Agent 增加四类预算和明确退出状态,优先覆盖重复查询、单轮多工具调用和大输出这几种容易复现的故障。
- 在工具执行层集中检查允许列表、Schema 和业务规则;涉及退款、删除等操作时,让管理界面的审批结果控制执行,并保存决定记录。
- 把聊天记录裁剪测试和账本状态验收加入 CI,先用脚本模型稳定复现错误,再用相同场景评测真实模型的多次运行结果。
- 为客服偏好等长期记忆先做小范围持久化验证,检查检索输入、数据来源和删除路径,再决定全文检索是否足够。