从零搭建智能体软件交付流水线
作者报告四人工程团队在 11 天内合并的 675 个 PR 中,有 332 个由其智能体流水线发起。指南覆盖代码库准备、自验证、编码前规划、逐步自动化、沙箱隔离和基于证据的代码审查。
AI 深度解读
4 人工程团队在 11 天内合并了 675 个 PR,其中 332 个由 Agent 发起。Traycer 作者想说明的,不是 AI 已经能接管开发,而是:把任务入口、验证、评审和后续反馈连起来,Agent 才能持续交付,而不是留下更多待处理的代码。
这套「软件工厂」最值得程序员借鉴的,是如何让自动化交出证据、承担收尾,并把人的注意力留给关键决策。不过,PR 数量距离生产率仍有一段距离,作者的成绩单也需要拆开看。
软件工厂先修代码库,再增加 Agent
原文区分了三种东西:AFK agent 是离开电脑后继续运行的单个 Agent;software factory 是带触发器、检查关卡和反馈循环的 Agent 系统;dark factory 则连人读写代码都省了。
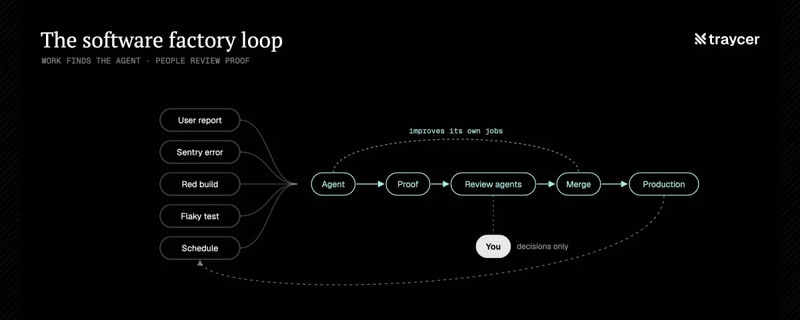
作者选择保留人的判断。整个团队共用自动化配置、仓库权限、密钥管理、沙箱和模型选择,任务自动进入,Agent 完成实现与验证,人决定关键事项。
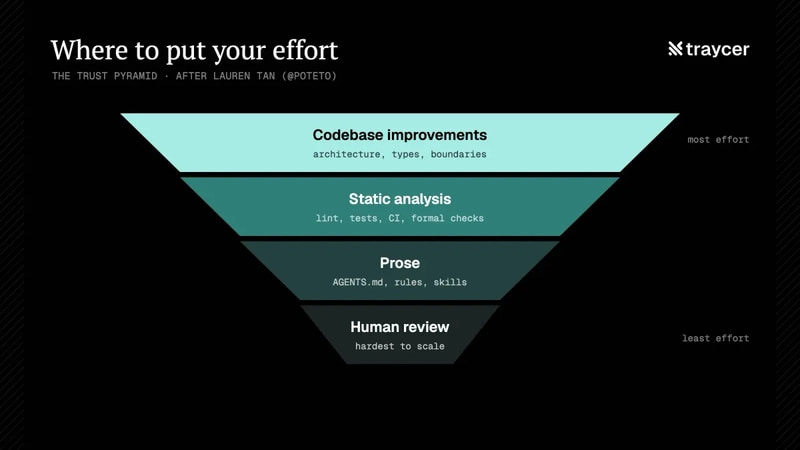
但自动化之前,代码库要先变得不容易被写坏。作者引用 Lauren Tan 的「信任金字塔」,把投入顺序排成:架构与类型约束,静态分析与测试,文字规则,人工评审。
这个顺序很实际。Agent 会模仿已有实现,也会选最短路径。如果错误用法在类型、模块边界或 lint 层就走不通,就不必反复提醒它「不要这样写」。AGENTS.md 和 skills 留给无法用工具强制表达的约定。
他们还建议维护 feature maps,记录各功能应该怎样工作,让模糊报障有可查的行为依据。作者团队把每项任务的指令存成仓库内的 skills,修改工厂规则也要走 PR。
先让错误难以发生,再讨论让 Agent 跑得更快。
原因是「理解债」:代码增长的速度超过团队理解它的速度。测试能通过,不代表代码仍然容易修改;如果每次合并都欠下一点理解,自动化会把这笔债一起放大。
Agent 交付的应该是证据,而不只是 diff
作者要求 Agent 像用户一样运行自己的成果。UI 提供操作录像,CLI 提供真实命令与输出,复杂状态机则考虑形式化验证,也就是用明确的状态与规则检查可能发生的执行路径。
他们在 Traycer 同步代码上使用 TLA+,用一个小型双机器模型探索编辑、删除、崩溃的交错,再把模型发现的失败场景拿到真实代码中重放。作者称,这找出了已经经过 6 轮评审的代码里,内容消失和已删除文件重新出现的问题。
这不等于整套系统已经被数学证明正确。模型覆盖了什么、与实现对应到什么程度,原文没有展开。但它提供了一个方向:并发问题不能只靠多读几遍代码。
日常修复则有两条硬要求:修改前在真实构建中复现;提交一个在旧代码上会失败的测试。作者用「测试证明测试,录像证明产品」强调实际运行的重要性。严格说,录像也只证明录下来的那条路径,不能替代其他检查。
编码前的对齐同样是在降低评审成本。原文推荐用 /grill-me 或 /grill-with-docs 追问需求,通过 /to-prd 明确目标,再用 /to-tickets 拆小任务。高风险工作还要检查产品行为、系统架构、类型和函数签名,优先做一条能实际操作的端到端路径。
作者认为 30 分钟规划能省下数小时评审,但没有给对照实验,应当视为经验判断。
进入评审后,他们安排多个专业 reviewer,并设置「盲审」:只看原始问题和 diff,不看实现 Agent 的推理,减少被同一套解释带偏的机会。发布提案则把 179 个 PR 归到 19 个领域,列出 5 个高风险领域、QA 结果和未覆盖项,附上 2 分钟讲解录像,供人用约 5 分钟作出决策。
证据的价值,也包括坦白哪里没验证。
自动化最难的部分,是收尾和权限
作者建议从一个触发器、一项任务开始,比如每天分诊 1 个 issue,再逐步扩到 2、5、10 个。首批任务应满足一个条件:做对了有价值,做错了丢弃输出的成本也低。
他们第 1 天接入 Sentry 错误和不稳定测试,第 2 天增加用户报告、主分支失败和工厂维护,到第 4 天再接入供应商更新、发布与基础设施告警。
无人值守也要求隔离。原文提到 Sandcastle,通过一次 run() 在 Docker、Podman 或云端 microVM 中启动独立分支上的 Agent。作者团队称 Agent 只持有只读 token;Slack、Discord 消息及获准的用户回复,由另一个持有发送密钥的网关处理,检查规则、每日预算和静默时段。具体读写凭据如何分配,原文没有完整说明。
他们尝试过用 LLM 过滤消息,结果 40 条本应发送的消息被悄悄拦下,包含审批请求和发布更新。另一个任务在 3 天内起草了 45 条消息,其中 36 条只是「无需操作」,幸好没有发出。这两次经历说明:通知也是系统行为,需要确定的边界。
PR 打开后,原 Agent 还要继续响应评审、修复检查、处理 rebase。他们每 15 分钟检查一次未关闭的工厂 PR;如果人必须在两个 Agent 之间传话,就把它当作流程缺陷。
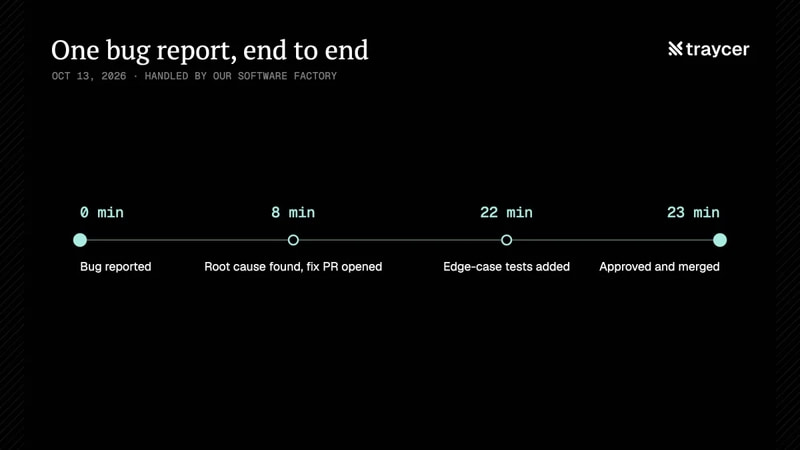
一个实际案例是西班牙语 Windows 用户无法安装 Traycer。Agent 将凌晨 4:24 的报告关联到 200 多条非英语 Windows 的 Sentry 错误,定位到只识别英文错误消息的检查:8 分钟打开 PR,22 分钟补齐边界测试,23 分钟通过自动评审并合并。
但他们没有 Windows 机器完成端到端安装,PR 明确写出了缺口。另一个长选项被截断的问题修好后,系统回到原 Discord 线程,告知用户修复将在下一版本发布。修复合并与用户收到答复,是两件都要完成的事。
我的判断
我赞成把验证、收尾和权限管理放在模型选择前面。这比给每个人配置一套提示词,更接近团队能够维护的工程系统。产品、文案、认证、计费、发布、公开回复和不可逆操作,作者仍交给人决定,也符合这些任务的实际风险。
但 49% 的合并 PR 由工厂发起,不等于团队生产率提高了 49%。
作者的 11 天成绩包括:工厂 PR 合并率 92%,另有 28 个关闭未合并;从打开到合并的中位时间为 1.6 小时;332 个已合并 PR 中,有 43 个用于改进工厂自身。这说明系统承担了相当数量的工作,却没有交代任务规模、人工介入时长、缺陷率,以及没有工厂时的交付基线。
原文引用 Ben Holmes 的每 PR 成本下降 67%,主要来自用历史任务比较模型选择。这是另一团队的经验,不能直接套到 Traycer,也不能据此估算自己团队的收益。
与常见的 CI 自动修复、依赖更新机器人相比,工厂扩展了任务识别和跨步骤处理能力,也增加了编排成本。如果问题能用确定脚本解决,脚本仍然更容易解释和维护。Agent 更适合那些需要读上下文、定位原因、提出补丁的环节。
每周复盘会话、给低分任务找共因,再修改 skills 或代码库,是原文另一项有价值的做法。不过,自动改进仍要经过评审,否则工厂也可能持续优化一个错误目标。
能拿来做什么
- 给前端 bug 修复约定最小证据包:修改前的复现、旧代码会失败的测试、修改后的操作录像,并列出未验证的浏览器或设备。
- 从一个低风险入口试运行,例如每天处理 1 个 Sentry 问题;先观察定位、验证和人工评审成本,再扩大范围。
- 在 Node 或全栈仓库中,把能执行的要求写进类型、lint 和 CI,把无法强制检查的约定留给 AGENTS.md;仓库里的任务 skills 同样走 PR。
- 让同一个 Agent 跟进 PR 到合并,并按周检查退回原因、周期和人工介入情况;同类问题反复出现时,优先修规则和代码边界。