用 n8n 自动采集动态网页并发送日报
作者用 n8n 的 Browser Use 节点读取前一天的 Product Hunt 榜单,将前五名写入 Google Sheets 并邮件发送摘要。通过 JSON Schema 约束输出后,实测单次耗时 22 至 82 秒,智能体费用为 0.0046 至 0.0124 美元,浏览器时长和代理流量另计。
AI 深度解读
用 n8n 给 Product Hunt 做日报,卡住流程的往往是第一步。HTTP Request 能拿到服务器返回的 HTML,却不会执行页面里的 JavaScript,榜单数据可能根本没进响应。作者换用 Browser Use,让云端浏览器打开页面,再把读到的前 5 名交给 Google Sheets 和 Gmail。
他们在 2026 年 11 月 17 日和 18 日共跑了 5 次。最有参考价值的是两次失败:一次读到了缺失票数,一次返回空榜单。把「今天」改成太平洋时区里已经结束的一天,再校验返回值,才有了一条能用于日报的流程。
哪一段值得交给浏览器 Agent
网页数据在初始 HTML 里时,HTTP Request 加 HTML Extract 就能完成采集。数据要等脚本执行后才出现,就得让浏览器把页面跑起来。自托管 Puppeteer 或 Playwright 也能做到,具体点哪里、读哪个元素由代码决定,团队要维护浏览器运行环境和选择器。Browser Use 把这部分交给云端 Agent,工作流只需给出入口和目标,由它决定是否要滚动或点击。
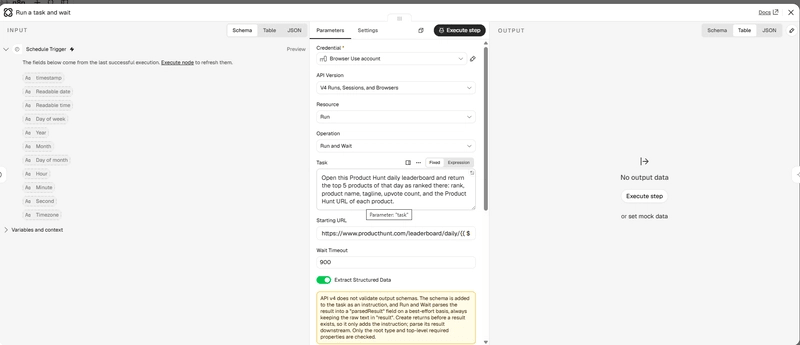
作者在 n8n Cloud 的节点面板里安装了带认证标记的 Browser Use,当时显示的版本是 1.2.1。自托管 n8n 从 Settings → Community Nodes 安装 n8n-nodes-browser-use-cloud,旧的第三方包叫 n8n-nodes-browser-use。作者数到 35 个操作,分为 Run、Session、Browser 和 Task 四组,Task 组保留了旧版 v2 API。这个日报只用 Run 组里的 Run a task and wait,对应 API Version 的 V4 Runs, Sessions, and Browsers 和 Operation 的 Run and Wait。接入时填入 Browser Use Cloud 的 API key,Base URL 沿用默认值。
日报为什么要读已经结束的一天
作者用 Schedule Trigger 设定 Days、每 1 天触发一次,邮件安排在下午 6 点。发信时间只决定什么时候收到日报,榜单属于哪一天则由 Starting URL 决定。下面这个 n8n 表达式会把执行时间换算成 Product Hunt 使用的时区,然后直接打开前一天的榜单。
https://www.producthunt.com/leaderboard/daily/{{ $now.setZone('America/Los_Angeles').minus({ days: 1 }).toFormat('yyyy/M/d') }}
这一行里的 setZone('America/Los_Angeles') 放在 minus({ days: 1 }) 前面,减去的是站点时区中的一天。作者还在 Run Options 里把 Max Cost USD 设为 0.25,给单次 Agent 运行加上成本上限。
一次标记为 09:17 的运行发生在旧金山 01:17。当天刚开始,页面上的票数仍是横线。Agent 把票数填成 -1,附注说明名次取自首页的展示顺序。约一个半小时后,另一次运行没能确定任务里的「今天」对应哪一天,最终返回 {"launches":[]}。改用明确日期的已结束榜单后,接下来两次都拿到了完整的前 5 名,分别用时 22 和 27 秒。
JSON 能解析,为什么还要在写表前加 IF
作者打开 Extract Structured Data,选择 Custom JSON Schema。下面这份 schema 规定了日报交给后续节点的数据形状。
{
  "type": "object",
  "properties": {
    "launches": {
      "type": "array",
      "items": {
        "type": "object",
        "properties": {
          "rank": { "type": "integer" },
          "name": { "type": "string" },
          "tagline": { "type": "string" },
          "upvotes": { "type": "integer" },
          "url": { "type": "string" }
        },
        "required": ["rank", "name", "tagline", "upvotes", "url"]
      }
    }
  },
  "required": ["launches"]
}
看 upvotes 那一行,-1 也是整数,单凭字段类型就会放过第一次失败。更进一步,作者用的 n8n 节点在 v4 模式下会把 schema 附加到任务描述里,再尽力把模型答案解析为 parsedResult,原文保留在 result。直接调用 v4 API 时,outputSchema 则是请求的独立字段,结构化答案从 output 读取。原文的 Python 示例先 POST /runs,再每隔 8 秒查询 GET /runs/{id}/status,等到 completed、failed 或 cancelled 后,通过 GET /runs/{id} 取结果。作者说 v4 没有 webhook,节点替调用方做了这段轮询。
作者在 Split Out 前加了一个 IF,用 {{ $json.parsedResult.launches.length }} 检查条数等于 5,用 {{ $json.parsedResult.launches.every(l => l.upvotes >= 0) }} 检查票数均非负。失败分支发一封带 eventsUrl 的提醒,方便回看 Agent 当时读到了什么。实际照抄这两个表达式时,还要先处理 parsedResult 缺失或 launches 类型不对的情况,否则校验表达式本身就可能出错。
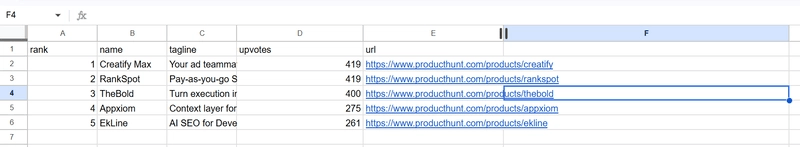
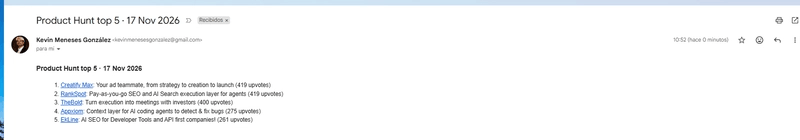
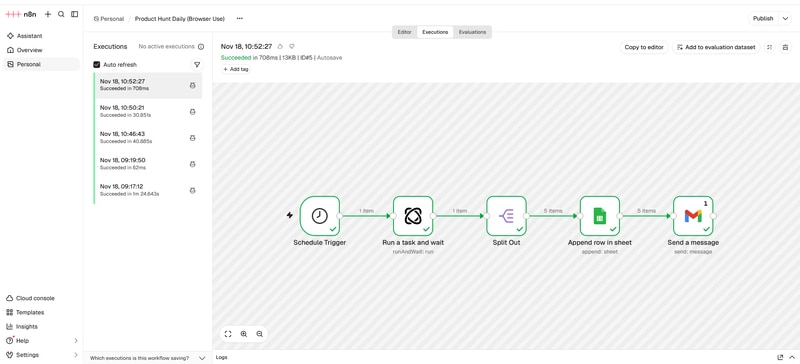
通过检查后,Split Out 按 parsedResult.launches 拆出 5 个条目,Google Sheets 用 Append row in sheet 和 Map Automatically 逐行写入。Gmail 的主题要切到 Expression 模式,作者第一封邮件就在 Fixed 模式下把 {{ }} 原样发了出去。还要打开 Execute Once,让 Gmail 把 5 个条目拼为一封摘要。Append n8n Attribution 控制邮件页脚。发布工作流后,这条链路才会按计划运行。
五次运行测出了哪些成本
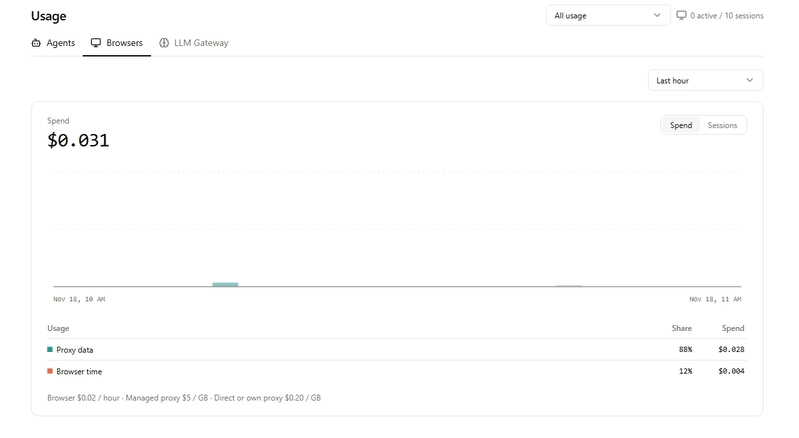
作者直接调 API 跑了 2 次,通过 n8n 跑了 3 次。文中给出的 Agent 耗时范围是 22–82 秒,单次 totalCostUsd 为 $0.0046–$0.0124。这个字段对应事件日志里的模型调用费用。浏览器时长与代理流量另计,测试那一小时合计 $0.031,其中 88% 是代理流量,12% 是浏览器时长。作者假设每天花掉整个测试小时的浏览器与流量费用,再加一次最贵的 Agent 运行,估算月费约 $1.30。
我的判断
这篇最值得借鉴的是把业务规则留在工作流里。榜单是哪一天,由表达式决定。结果能不能写入,由校验决定。Agent 负责读页面,出了问题可以结合 status、stepCount、durationSeconds、sessionId 和 eventsUrl 查执行记录。对于按天归档的数据,这些规则比把任务描述再写长几行更容易排查。
五次运行足以说明作者把这条链路跑通了。文章没有给出同页 Playwright 对照、独立核对榜单的结果,或更长周期的成功率。对页面结构稳定、要精确复现每一步的任务,Playwright 仍有明确优势。对已经能用 HTTP Request 拿到所需数据的页面,直接请求也少一段模型调用和等待。「内容重的页面主要花钱在代理流量上」是作者结合这次账单给出的经验判断,$1.30 也是按假设算出的月费。换成需要登录或翻页的任务,样本里的耗时和成本能提供的参考就有限了。
能拿来做什么
- 给 n8n 里的定时采集先确定站点时区,把日期算进
Starting URL。日报如果依赖最终票数,就读已经结算的榜单。 - 用 n8n 或 Node 消费 Agent 输出时,先验证数组是否存在,再验证条数以及票数是否为非负整数。失败时保留
result和eventsUrl,避免空结果被当成正常日报。 - 做「多行写表、一封邮件」的流程时,用同一批数据检查写表和发信的执行次数。Gmail 用
Execute Once聚合发送,主题和正文中的动态表达式也要用实际执行结果核对。 - 想从 Node 服务复用这条链路,可以沿用
POST /runs和状态轮询的接口顺序。分别记录模型、浏览器和代理费用,再按实际的分页与等待时间设置Max Cost USD和Wait Timeout。