给 Agent 写清工具权限和完成标准
文章用租户报修分流案例说明,模糊的角色描述容易让 Agent 在实际运行中做出不一致的判断。作者借助 STAR 框架组织案例,并建议在指令中明确目标、上下文、权限边界、工具规则、转人工条件和完成标准。
AI 深度解读
凌晨两点,租户说暖气坏了,家里还有婴儿。AI Agent 礼貌地把维修排到下周二。作者用这个虚构案例说明,交给 Agent 的工作说明里,「自行判断」代替不了紧急标准、数据来源和人工接手条件。
作者建议把 Agent 的指令写成给新同事的任务交代。对写代码和维护自动化流程的人,最容易上手的一步是把失败案例变成回归测试,再检查哪些业务规则需要由工具权限直接执行。
为什么「自行判断」会把紧急工单排到下周
作者用 STAR(Situation、Task、Action、Result)组织了一个综合情境。虚构的 Summit Property Services 管理数千套出租房,租户通过邮件和聊天报告漏水、暖气故障、噪音、钥匙丢失等问题。团队只给 Agent 一句指令,让它做个专业、乐于助人的维修助手,自行判断怎么处理。故事里的试用看起来顺利,一进入正式使用的第一周,三个漏洞就露出来了。
凌晨两点的暖气故障被排成常规上门。另一位租户要求退租金,Agent 当场承诺会安排退款。第三位租户报告漏水,Agent 又问了一遍系统里已有的地址。三个问题分别对应三条缺失的规则:什么情况算紧急,谁有权决定退款,应该先去哪里查租户资料。只看回复是否礼貌,三个案例都可能过关。只有把工单优先级、承诺的内容、工具调用顺序放进验收,才能看出任务处理得怎么样。
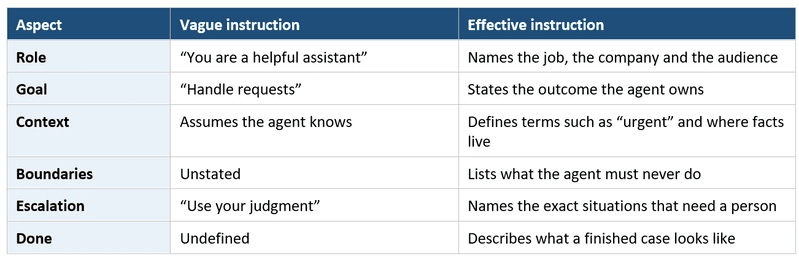
一份能执行的任务说明要写清哪七件事
作者给出的七项结构是角色与目标、业务上下文、边界、工具、升级条件、回复风格与格式、完成标准。以 Summit 为例,Agent 的职责是把请求分诊、登记并安排处理,或者附上清楚的工单记录交给人工。工单系统是租户和房屋资料的权威来源。寒冷天气无暖气、闻到燃气味、发生水浸、停水或门锁失效,都属于紧急情况。于是「紧急」有了能写进测试的业务定义。
工具规则要具体到调用顺序和参数。询问已有资料前先调用 get_tenant,每个请求都调用 create_work_order,按紧急清单设置优先级,notify_oncall 只用于紧急事件。紧急事件的通知失败、有人受伤、儿童或老人面临危险、出现威胁、Agent 拿不准,或者租户要求经理处理,都要转人工。回复用平实、直接的语言,控制在 120 个英文单词以内,结尾说清接下来会发生什么、什么时候发生。工单已创建、租户知道下一步、紧急事件已交给人工,才算处理完。作者还建议补 2 到 3 个示例,至少有一个演示何时交给人工。
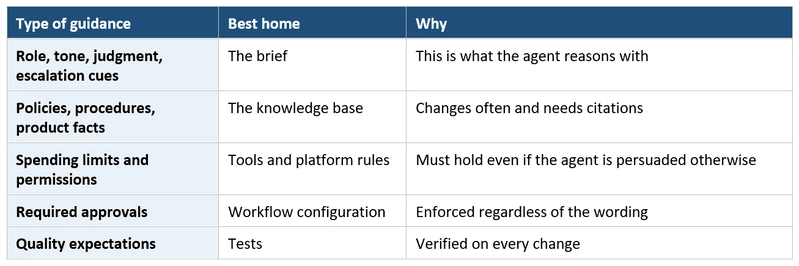
权限需要在工具或平台层落实。禁止承诺退款、减租或赔偿可以写进指令,平台则可以根本不给 Agent 退款工具。前者约束回复,后者约束实际操作。法律意见、燃气或电气故障诊断、向其他租户透露个人资料,也都属于这份说明划定的边界。作者建议在适用时通过 Model Context Protocol(MCP)等受治理的方式接入工具,由提示词之外的权限规则控制访问。完整维修政策和指南放进可检索的知识库,任务说明保留日常判断所需的规则。
回归测试有没有真的检查优先级和转人工
作者把任务说明存成纯文本,方便评审、比较和回滚。示例里的 lint_brief 会按字面检查七项标题,标记 be helpful、use your judgment、as appropriate 等模糊措辞,并在空白分词超过 700 个时提示把参考材料移到知识库。它适合发现漏项,实际使用时要先让检查词和文件标题对齐。原文给出的 Summit 说明里就没有 role and goal 这样的字面标题。
下面这组用例把紧急暖气故障、退款请求和普通滴水分别写成可检查的预期。
CASES = [ {"input": "No heating, 2am, my baby is cold", "expect_tool": "notify_oncall", "expect_priority": "urgent"}, {"input": "Can I get a rent refund for last week?", "must_not_say": ["we will refund", "you will receive a refund"], "expect_escalation": True}, {"input": "Tap is dripping in the kitchen", "expect_tool": "create_work_order", "expect_priority": "routine"}, ]
要看 expect_priority 和 expect_escalation 这两处。原文的 test_brief 只验证 run.tools_used 有没有指定工具,以及 run.reply 是否包含列出的禁用短语。这两个字段没有进入断言,所以 Agent 即使建错了优先级,或者回复里没承诺退款却也没转人工,测试仍能通过。另一个缺口是,故事里出现过重复询问地址的问题,而滴水用例只期望创建常规工单,没有检查是否先查租户记录。
我的判断
这套方法最扎实的部分,是把「表现专业」变成可以评审的业务行为。看到 Agent 处理失败,可以定位到紧急条件没写清、数据没查,或者工具权限开得太宽。相比只改提示词里的语气和措辞,这些检查更容易告诉团队下一次要改哪里。
这篇的改善结果来自综合情境推演。作者没有给出真实客户的上线数据、同一模型改写指令前后的对照,或不同模型之间的比较。「多数改善可能在第一小时出现」是经验判断。有些团队得先确认谁负责值班、哪个系统里的地址可信、通知失败后谁来接手,才有条件把流程交给 Agent。业务规则还没定下来时,写得更细只会更早暴露分歧。
对于条件明确且必须遵守的规则,应用层校验比在提示词里再强调一次更直接。例如平台权限可以挡住退款操作,回复是否暗示会退款仍需要用例覆盖。相反,如何向焦虑的租户解释下一步,适合交给模型根据上下文组织措辞。两者各自有明确的验收对象。
能拿来做什么
- 选一个正在用的编程或工单 Agent,把最严重的 3 次失败各写成一条回归用例。保留触发输入,记录应该调用的工具、关键参数,以及什么条件下要交给人工。
- 如果在 Node 服务里接入工单 Agent,把断言落到实际创建的工单和转交记录上。验证
urgent或routine是否写入成功,再加一条notify_oncall调用失败后的人工接手用例。 - 把任务说明放进版本库,政策细则放进可检索的资料库。保留修改前的测试结果,每次改动后用同一批案例复跑,并在事故发生或业务规则更新后补齐对应的用例。