用交互图谱拆解百余种大模型架构
开源课程 LLM Explained 新增架构图谱,对比百余种模型的归一化、位置编码、注意力和前馈网络设计。课程还提供分层讲解、可运行 Python 示例与测验。
AI 深度解读
Llama、DeepSeek、Qwen、Gemma 到底差在哪?只看参数量,很容易把不同模型理解成同一套东西的大小号。LLM Explained 的作者做了一个 Architecture Atlas,把 130 多种模型架构放进统一的图示和表格里,尝试让读者把新模型读成一份「组件差异清单」。
它值得看的地方,是把架构图、参数量、KV cache 和教学解释串了起来。但能算清模型用了哪些零件,不等于能判断它实际跑得多快、代码写得多好。这个边界,也需要一起看。
模型名字不同,究竟换了哪些零件
作者先给出一个学习框架:把模型看成重复堆叠的计算块,每个块主要包含注意力层、前馈层,以及连接它们的残差通路。面对新模型,先沿着同一套骨架找差异。
Atlas 用三个时代展示这套骨架的变化。
2017 年的 Transformer 是编码器与解码器两座塔,通过交叉注意力连接,采用后置归一化和正弦位置编码。2019 年的 GPT 风格结构去掉了编码器和交叉注意力,让提示与回答组成同一个序列,并把归一化移到子层前面。
到了 2023 年之后,作者展示的现代开放模型又换上 RMSNorm、注意力内部的旋转位置编码 RoPE、带 KV cache 的分组查询注意力 GQA,以及 SwiGLU 前馈网络或混合专家 MoE。
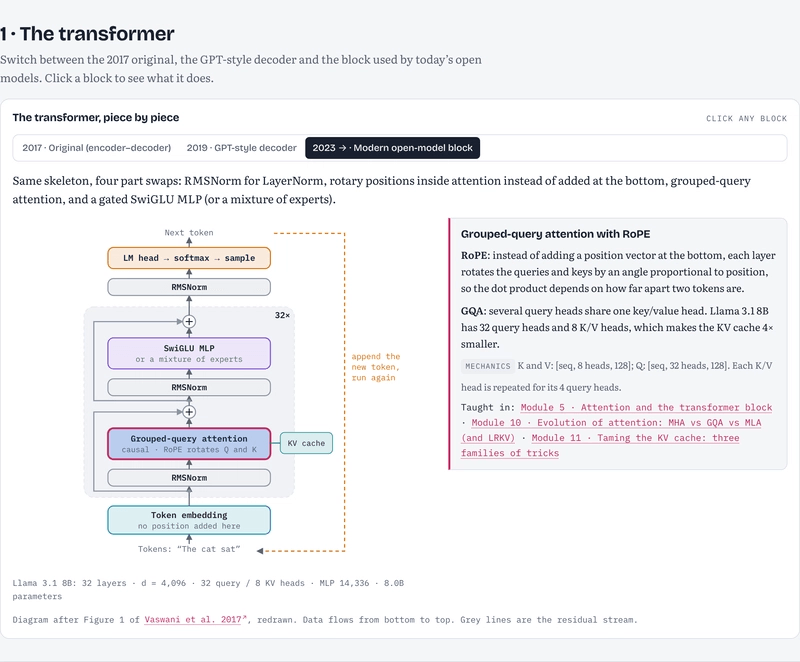
真正需要比较的,是几组具体选择:归一化用 LayerNorm 还是 RMSNorm,位置编码用正弦、可学习编码还是 RoPE,键值表示采用 MHA、GQA 还是 MLA,注意力覆盖全局还是局部窗口,前馈层是稠密网络还是 MoE。
这些名词对应不同的资源安排。例如 KV cache 保存已处理 token 的键值信息,避免生成后续 token 时重复计算;MoE 则让每个 token 只调用部分专家,而不是经过全部专家权重。
先看组件选择,再看模型名字,架构差异就更容易读懂。
不过,这是一张教学用地图。原文后面还收录了线性注意力、状态空间、卷积和循环结构,不能把所有模型都严格归结为「每层都是相同的注意力加前馈网络」。
DeepSeek-V3 的 671B,为什么每个 token 只激活约 37B
Atlas 中最有解释力的例子是 DeepSeek-V3。
它有 671B 总参数,但每个 token 激活的参数约为 37B。作者给出的结构是:256 个路由专家,每个 token 选择其中 8 个,另外还有 1 个共享专家。总参数描述模型拥有多少权重,激活参数描述一次 token 计算会用到多少权重,两者回答的是不同问题。
这也能帮助理解文中提到的「每个 token 激活 3.5% 的 MLP 权重」。这个比例针对的是前馈网络,不能直接当成整个模型的激活比例,更不能直接换算成推理提速比例。
另一个差异来自多头潜在注意力 MLA。原文展示的 DeepSeek-V3 配置,每个 token 缓存一个含 576 个数值的潜在表示,作者将它与保存 128 个头的 K、V 作比较,得到 KV cache 缩小 57 倍的结果。
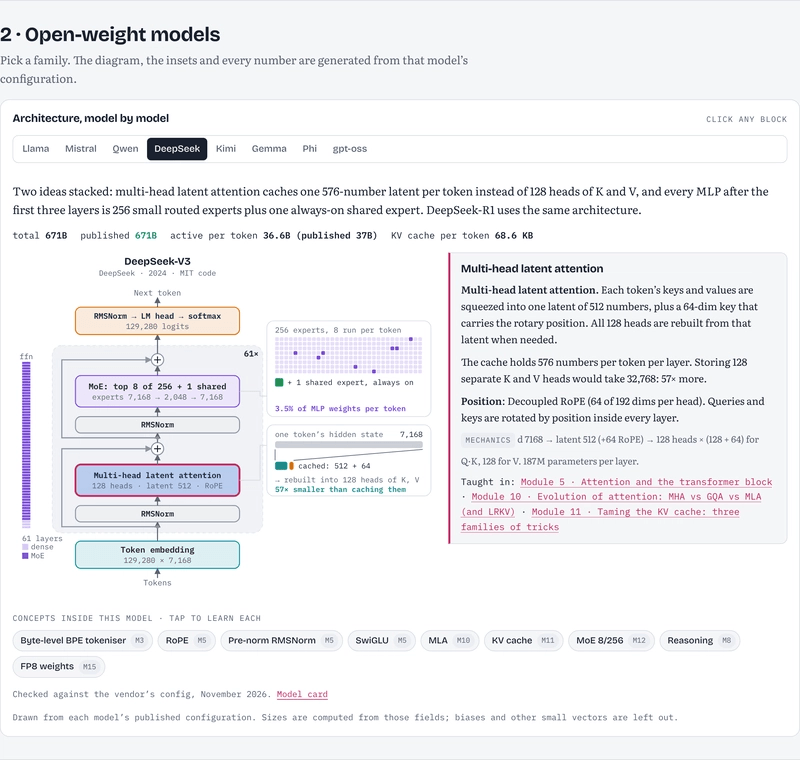
这里的 57 倍指向特定比较口径下的缓存规模,不是整个模型显存缩小 57 倍。模型权重和运行时其他开销,并没有因此消失。
换成 Gemma 3,图里的关注点就变了:局部与全局注意力交错排列,每个子层前后都有归一化,输入输出嵌入共享权重,还支持图像输入。这些结构差异,比「又发布了一个更大的模型」提供的信息更多。
作者称,14 份配置都能复现公布的参数规模,误差在 0.3% 以内;例外是 Kimi K2,因为官方规模只给了取整后的「1T」。模型也会标注核验依据:对照厂商配置或模型卡,或者通过复现公开参数量确认。
这属于配置与计数的核验。原文没有提供模型运行性能的对照实验。
130 多种架构怎样保持可比较、可追溯
Atlas 把内容分成两层:14 个经过人工核验的模型配置,以及另外 120 种开放权重架构组成的可搜索图库。
前一层适合深入看一个模型,后一层适合横向找模式。图库用一格代表一层,以颜色区分全注意力、滑动窗口、潜在或稀疏注意力、线性注意力、状态空间与卷积等结构。模型是不是混合架构,先看层级条带就能形成初步判断。
原文快照包含 57 个稀疏 MoE、29 个稠密模型和 29 个混合模型,另有少量全模态、编码器与解码器、循环模型。RoPE 出现于 104 个模型,GQA 出现于 73 个,MLA 出现于 30 个。
作者还判断,滑动窗口注意力、门控注意力和 Gated DeltaNet 正在快速扩散。但原文没有给出跨时间的统计数据,「传播最快」应当视作作者对快照的观察,不能当成已经证明的增长排名。
图库数据来自 Sebastian Raschka 的 LLM Architecture Gallery 公开快照,采用 Apache 2.0 许可。转换脚本 scripts/build_gallery.py 只保留描述字段,不包含图片和基准分数,图示由站点自行绘制。
工程实现也很适合前端开发者参考。下面这段目录说明,展示了模型配置、计算逻辑和图库数据如何分工:
assets/arch.js      model configs (MODELS), parameter + KV-cache counters,
                    SVG stack renderer, transformerDiagram / modelDiagram /
                    conceptMatrix, and the atlas page
assets/gallery.js   generated by scripts/build_gallery.py, lazy-loaded
                    only when you open the atlas
重点看 assets/gallery.js 这一行:86 KB 的图库文件只在打开 Atlas 时下载。整个站点不依赖框架,也没有构建步骤。
更关键的是,同一份配置包含 layers、d_model、heads、KV heads、experts、窗口模式和词表等信息,同时驱动架构图、计数器、对照矩阵和规格卡。新增一个模型时,补一个配置条目,各种视图就能同步更新。
同一套组件还被复用于 Module 6 的编码器与解码器教学,以及 Module 16 的规格卡、参数计数器和架构差异比较。模型图里的概念入口,则连接 RoPE · M5、MLA · M10、KV cache · M11、MoE · M12 等课程模块。
我的判断
我认同它把「结构解释」和「数字来源」放在一起。单独看一张漂亮架构图,很难知道图有没有画错;让参数量和缓存规模从配置计算出来,至少增加了一道可检查的约束。对学习者来说,也比反复记忆模型名称更有积累价值。
但作者说「计数不匹配,配置就是错的」,表达得过于绝对。按原文描述,Kimi K2 的公布规模就存在取整问题。反过来,即使总参数量对上,也不能证明每个结构字段都正确。计数是核验线索,不能替代逐项检查。
另外,标题使用 open-source,正文更多使用 open-weight。开放权重不应直接等同于满足开源要求;图库虽然列出了 licence 字段,实际使用仍要看具体模型许可。
它更适合与模型卡、论文配合阅读,也不能取代任务评测。原文没有提供教学效果对照,作者认为统一骨架更容易理解,这是有道理的教学经验;「十秒识别架构」也是使用预期,并非学习效果实验。课程规模的表述也略有口径差异:开头写 43 个交互页面,课程图说明写 42 个模块、七个部分,两者如何对应没有交代。
它能帮你判断模型在结构上换了什么,不能直接替你决定该用哪个模型。
能拿来做什么
- 看 AI 编程模型的发布信息时,先记录总参数、每 token 激活参数、注意力类型和 KV cache 设计,再结合实际编程任务评测做选择,避免把 671B 直接理解成每步都计算 671B 权重。
- 给本地推理或 Node 服务做接入调研时,可以用 Atlas 理解缓存差异,再单独验证目标上下文长度和运行环境的占用;不要把「57 倍缓存缩减」直接填进整机容量估算。
- 做前端技术文档或配置展示工具时,可以借鉴「一份配置驱动多种视图」:让表格、图示与计数共享数据,再用已知结果检查配置,减少页面之间互相矛盾。
- 补模型基础时,可以先沿某个熟悉模型定位一个概念,再进入对应课程。与一次背完 MHA、GQA、MLA、MoE 相比,这样更容易把术语和实际结构联系起来。