在 OpenCode 中配置分工、权限和持久记忆
作者展示了一套包含 12 个子代理、123 项技能、16 条命令和 8 个 MCP 服务的 OpenCode 配置。方案按任务难度分配不同成本的模型,通过权限控制工具访问,并用两层文件记忆跨上下文压缩保留信息。
AI 深度解读
AI 编程工具聊得越久,越容易丢掉前面定下来的约定。换个会话,可能还要重新交代仓库怎么跑、哪些文件别碰。作者用 OpenCode 搭了一套个人工作流,把规则、任务分工和项目状态放进文件,再用钩子把上下文压缩前后的工作接起来。
整套配置有 12 个子代理、123 个技能、16 条斜杠命令和 8 个 MCP 服务。对前端和全栈开发者来说,最值得拆开看的是两个问题:批量读代码和高风险改动怎么分工,以及会话中断后,下一轮凭什么知道该从哪里接着做。
为什么先把仓库和规则接进运行时
原文以 OpenCode v2.3.0 的 CLI 和配置结构为准。OpenCode 是代理运行时,负责把模型、工作目录、指令、工具和权限接在一起。模型由提供商或本地环境提供,作者的主会话配置用的是 opencode-go/beam-free。同一套工作流可以从终端、桌面端或网页使用,作者选 CLI,因为项目文件、脚本和 Git 都在手边。
在 macOS 或 Linux 上,原文给出的 v2 安装命令是 curl -fsSL https://opencode.ai/v2/install | bash。已装 Node.js 和 npm 也可以用 npm install -g @opencode/cli。Windows 用对应 x64 或 ARM64 的独立 CLI,把目录加入 PATH。装完用 opencode --version 查版本。下面两行让代理从目标仓库启动。
cd /path/to/your/project
opencode
第一行要指向仓库根目录,因为启动目录决定代理最先接触的项目上下文。也可以直接用 opencode ~/code/my-project。进入界面后用 /connect 连接提供商,再用 /models 选模型。第一次先让代理说明目录结构和主要入口,并要求它保持文件原样。
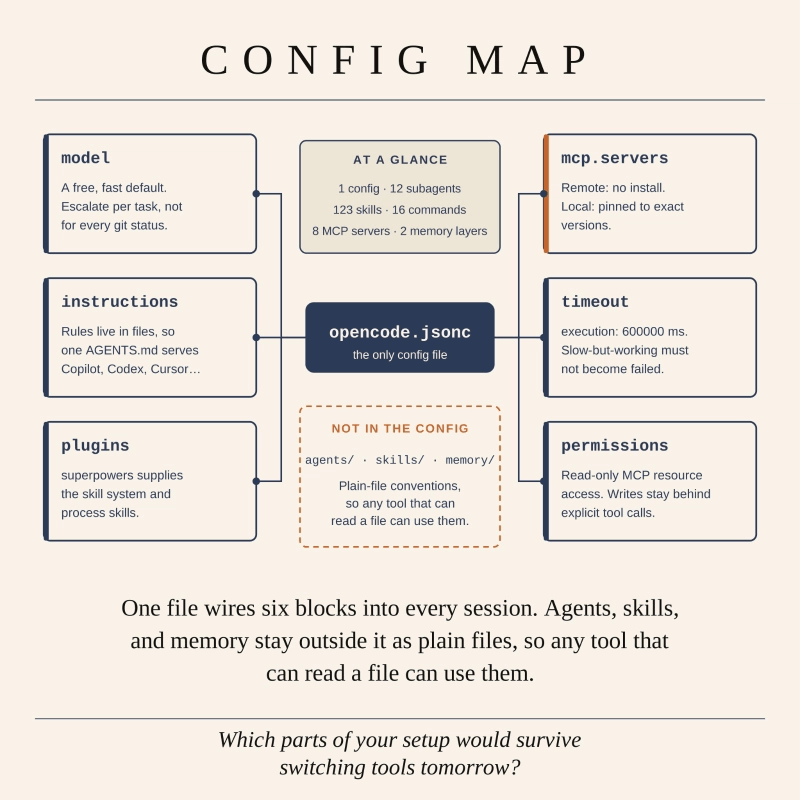
~/.config/opencode/opencode.jsonc 通过 instructions 加载 ~/.agents/rules/CORE.md 和 ~/.agents/AGENTS.md,同时接入 superpowers 插件,开启 formatter、lsp 以及 experimental.todo 和 experimental.background_compaction。子代理、技能、命令和记忆各自存成文件。共享规则能被多个工具读取,具体怎么加载、触发和续接,仍取决于各工具的运行方式。
接入 8 个 MCP 服务后,权限怎么收口
作者先配免安装的远程服务 firecrawl、apify 和 exa,再配本地服务 context7、filesystem、fetch、memory 和 sequential-thinking。工作协议要求遇到库用法问题先用 Context7 查文档。对前端项目,这条规则可以落在一个具体问题上:当代理准备调用某个框架 API 时,先确认仓库所用版本的文档写法。
本地服务固定版本。Context7 用 npx @upstash/context7-mcp@4.5.1,服务收到的 CONTEXT7_API_KEY 通过 {env:CONTEXT7_API} 注入。Filesystem 用 npx -y @modelcontextprotocol/server-filesystem@2.2.0 /path/to/your/projects,目录参数指定可访问范围。Fetch 用 uvx mcp-server-fetch==2026.11.4。另外两个服务分别用 npx -y @modelcontextprotocol/server-memory@2.1.0 和 npx -y @modelcontextprotocol/server-sequential-thinking@2.1.1。
MCP 的 startup、catalog、execution 超时分别设为 30000、30000、600000。示例权限以 resource: "*" 放行 opencode_list_mcp_resources 和 opencode_read_mcp_resource,两条都是资源操作。接入后可以用前者检查资源能否列出。审阅权限时还要单独核对各服务暴露的工具与可访问路径,尤其是 filesystem。
哪些活交给便宜模型,哪些活需要专项复核
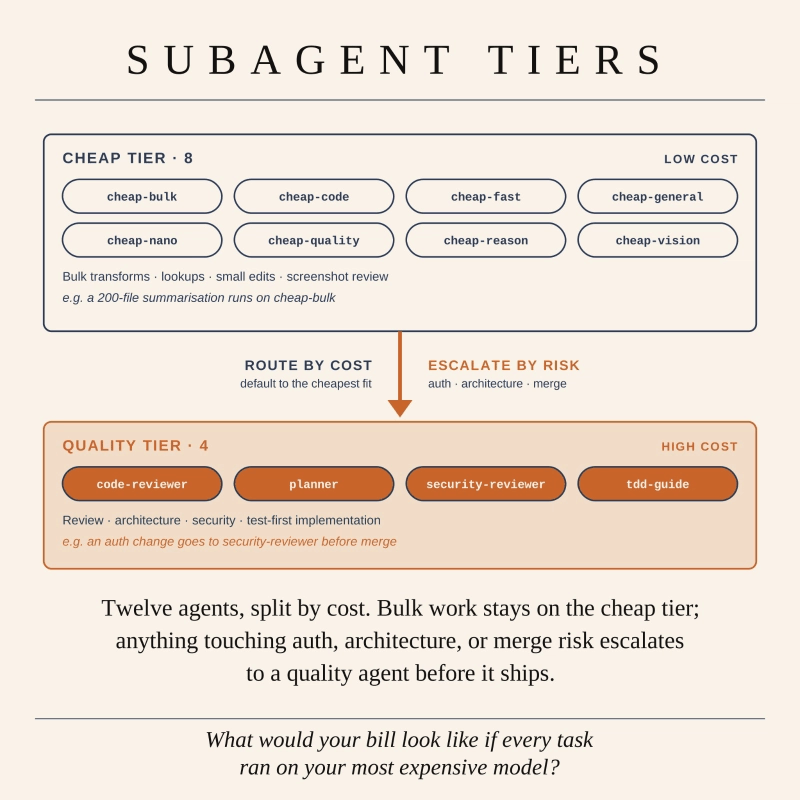
~/.config/opencode/agents/ 下有 8 个低成本子代理和 4 个专项子代理。作者给的例子是把 200 个文件的摘要交给 cheap-bulk,认证改动在合并前交给 security-reviewer。探索过程留在子会话,主会话接收结果,继续处理当前任务。code-reviewer、planner 和 tdd-guide 分别负责代码审查、规划和测试驱动开发。
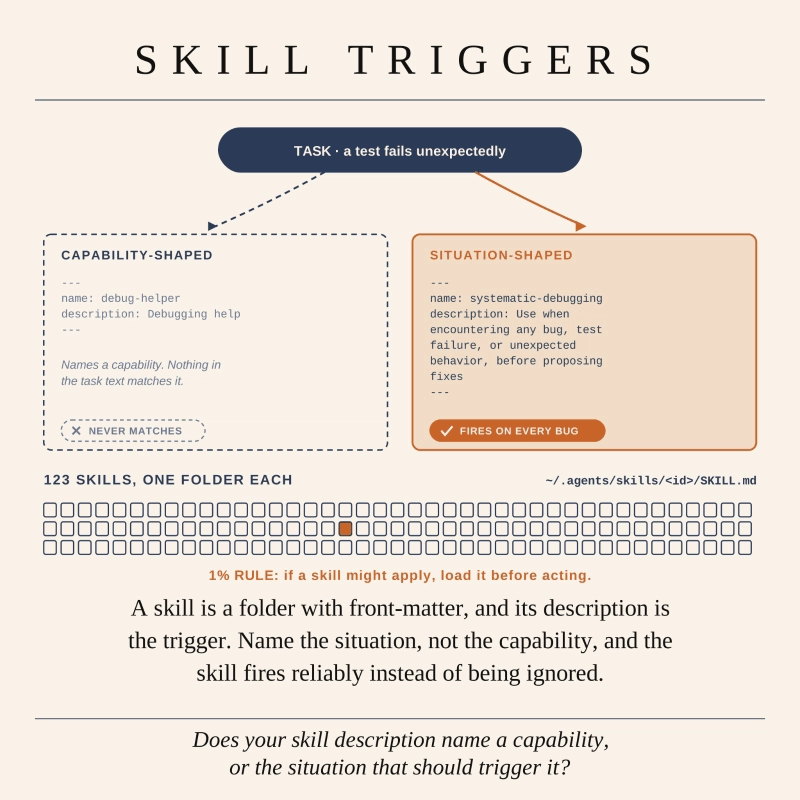
123 个技能放在 ~/.agents/skills/,16 条斜杠命令放在 ~/.config/opencode/commands/。技能靠 SKILL.md 文件头里的 name 和 description 被识别。下面的写法把系统化调试接到一个明确时机上。
---
name: systematic-debugging
description: Use when encountering any bug, test failure, or unexpected behavior, before proposing fixes
---
要看的是 description 那一行。它列出 bug、测试失败和异常行为,还指定在提修复方案前触发,比只写「协助调试」更容易对应到任务。
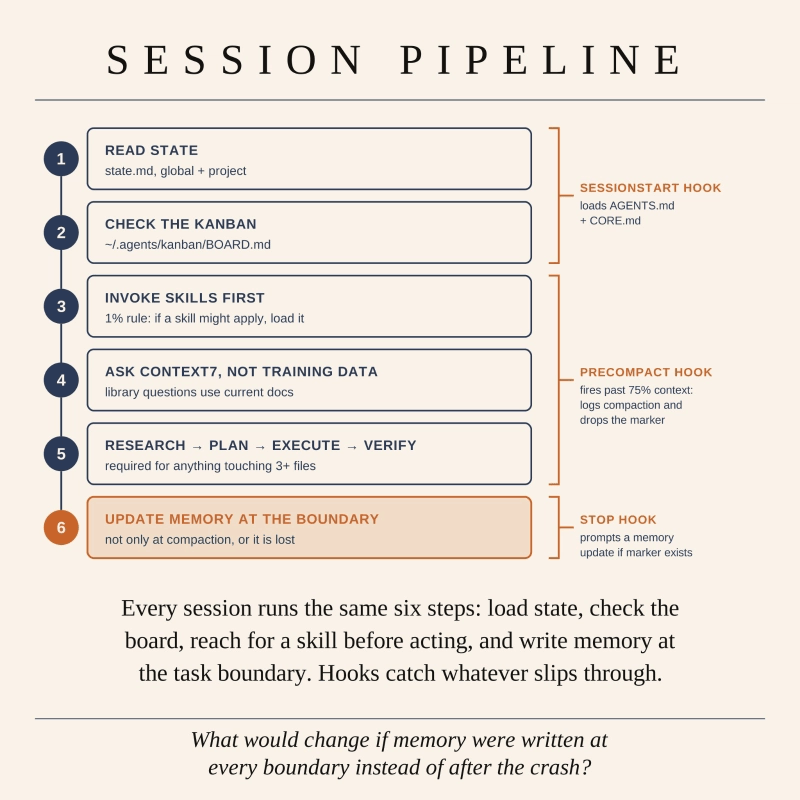
作者让代理开工前先读全局和项目的 state.md,再看 ~/.agents/kanban/BOARD.md。技能哪怕只有 1% 的可能适用也先加载。涉及 3 个及以上文件的变更,依次调研、规划、执行和验证,任务收尾时更新记忆。
上下文超过 75% 后,下一轮怎么接着干
上下文压缩(compaction)会把早先对话浓缩成摘要,一些决定可能就此丢失。作者把 75% 设为阈值,超过就压缩或停下,并把恢复工作交给磁盘上的待办标记。
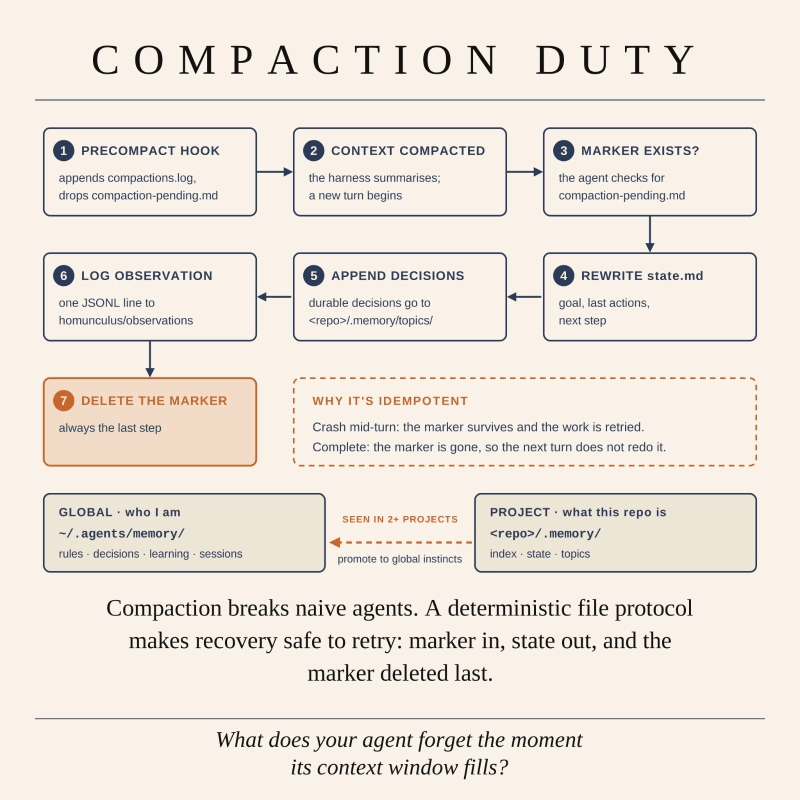
PreCompact 向 compactions.log 追加记录,再创建 compaction-pending.md。压缩后的新一轮检查标记,发现它就更新 state.md、写入需要长期保留的议题决策,并追加一条 JSONL 观察,全部完成后才删标记。SessionStart 和 Stop 分别负责读入和写回状态,让普通的会话切换也能续上。
全局记忆在 ~/.agents/memory/,收录跨项目的决定、经验和按天整理的会话记录。项目记忆在 <repo>/.memory/,用 index.md、state.md 和 topics/<topic>.md 保存仓库自己的状态和决定。同一种做法在 2 个及以上项目里被观察到,才提升到 ~/.agents/homunculus/instincts/global/,成为跨项目经验。
我的判断
这篇给出的是作者的个人配置和验收步骤。它写清了怎么检查一次压缩是否完成交接,也给了模型分流的例子。至于能省多少费用、技能描述能提高多少触发率,以及 75%、1%、3 个文件这些阈值是否适合一般团队,原文没有对照数据,属于经验之谈。
我最愿意保留的是项目级 state.md 和明确的交接时机。只靠会话摘要,团队很难检查某项决定有没有被保留。纯文件直接可读,个人或串行任务用起来也轻。要是多个代理经常同时写入,数据库的事务,或者文件方案里的单一写入者和去重机制,才有机会处理冲突和重复。作者把最后删标记称为幂等,但原文没有给出去重实现。如果上一轮已经追加 JSONL、还没删标记就中断,重试仍可能再写一条。最后删标记保证的是待办还能被发现。
能拿来做什么
- 在前端或 Node.js 仓库先写好
AGENTS.md和项目state.md,记录测试入口、当前改动和待验证项。换一次会话,让代理仅凭文件说明下一步,检查交接是否够用。 - 把经常重复的测试失败排查写成一个
SKILL.md,在description里写明遇到什么情况、应该在哪一步加载,再用一次失败的测试检查触发情况。 - 先用一个低成本子代理整理批量组件或模块清单,把认证相关改动交给专项审查。涉及框架 API 时,让代理先查对应版本的文档,再写改动。
- 手动触发一次上下文压缩,检查日志是否增长、标记是否出现、下一轮是否更新状态并删除标记。再模拟一次写到一半中断,看看重试会不会产生重复记录。