把自托管知识问答接入旧 PHP 系统
作者构建 Mnemosyne RAG 服务,通过现有 CodeIgniter 3 ERP 将企业文档问答接入 Viber。文章覆盖真实文档的检索调优、旧系统集成与踩坑,要求无匹配依据时拒答,并将向量库和嵌入运行在本地。
AI 深度解读
公司手册、报销流程、加班政策都写过,员工却还是每天重复问。作者给一家航运公司做了自托管 RAG 服务 Mnemosyne,再通过现有 PHP ERP 接入 Viber,让员工在聊天窗口里查制度。
这套方案值得看的地方,是它把检索、身份验证、旧系统接入和聊天展示串成了完整流程。作者最明确的经验也很朴素:文档怎么整理,往往比换哪个生成模型更影响回答质量。不过,「只根据文档回答」仍是设计目标,原文没有给出足够数据证明它能始终做到。
旧 ERP 接 AI,为什么可以只接一个 API
作者先定了三个要求:回答必须有公司文档依据;文档、向量和嵌入计算留在自有基础设施;ERP、机器人和未来网页聊天共用后端。
Mnemosyne 用 Docker Compose 运行五个容器,统一由 Node.js 服务处理请求。ChromaDB 保存文本分块和向量,执行余弦相似度检索;Redis 缓存答案,并通过 Bull 执行后台导入;Ollama 使用 nomic-embed-text 生成嵌入,也能运行本地大模型。OpenRouter 是可选的云端生成入口。
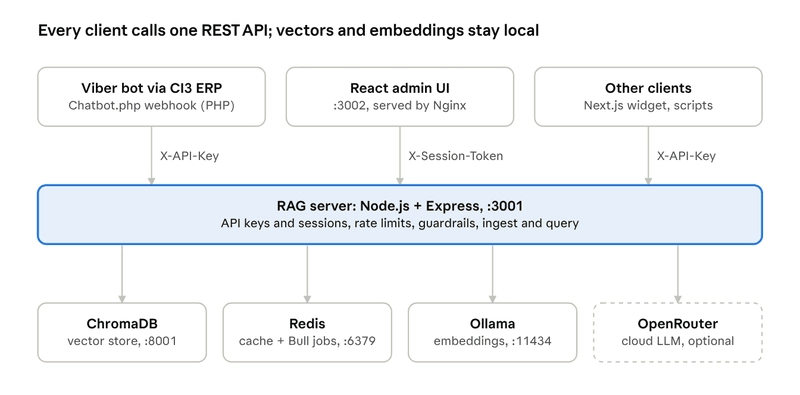
这里的 RAG,可以理解为先找资料,再让模型依据资料组织答案。PHP 不需要理解向量检索,也不用直接管理模型,只负责向服务发 HTTP 请求。
部署时,将 .env.example 复制为 .env,设置 RAG_API_KEY、ADMIN_USERNAME、ADMIN_PASSWORD,再运行 docker compose up -d。首次启动会拉取嵌入模型,管理界面位于 http://localhost:3002。
选择 LLM_ENGINE=local,生成也留在 Ollama;选择 LLM_ENGINE=openrouter,则使用云端模型。管理界面支持运行时切换,无须重新部署。但「自托管」不等于请求全程不出网:选择云端生成时,送入生成步骤的上下文仍会交给云端模型。
检索质量卡住时,先拆文档,再考虑换模型
文件上传后依次经过解析、OCR、分块、嵌入和存储。支持 PDF、DOCX、XLSX、CSV、Markdown、TXT 和图片;提取文本短于 OCR_MIN_TEXT_LENGTH 时,由 Tesseract 接手。
分块使用 CHUNK_SIZE 和 CHUNK_OVERLAP。后者让相邻块保留部分重复内容,减少一句话或一段流程被边界切断的问题。导入通过 Redis 上的 Bull 作业执行,因此一本 200 页手册不会一直占住 API,管理界面通过轮询查询进度。
作者试过三种整理方式:
- 给长 Markdown 手册补标题,结构改善了,但一个分块仍可能混入两种流程。
- 手工准备预分块 JSONL,边界精确,却增加了政策更新时的维护成本。
- 每个章节单独保存为不足 500 词的 Markdown 文件,与其 500 词的分块大小对应,最终采用了这种方式。
作者最有参考价值的经验,是让一个文档单元只回答一类问题。
查询时,问题也用 nomic-embed-text 转成向量。作者将 TOP_K 设为 5,将 MIN_RELEVANCE_SCORE 设为 0.15;低于门槛的分块会被过滤,没有合格结果就返回不知道。
这两个数字是作者的实际配置,不是通用最优值。原文没有提供召回率、误答率或不同阈值的对照结果。
标签则提供另一道约束。上传时标记 HR、Purchasing 等分类,查询时先限定范围,能减少跨手册误匹配。作者还通过会话历史检查失败问题,并表示多数修复落在文档上;这是实践观察,原文没有量化占比。
真正接进聊天工具,要补齐哪些环节
现有 ERP 使用 CodeIgniter 3。作者新增 Chatbot.php,接收 Viber webhook、核对员工身份,再转发问题。机器人 SOFIA 提供公司手册、IT、HR 三个入口,只有手册入口调用 RAG,另外两个直接返回联系人。
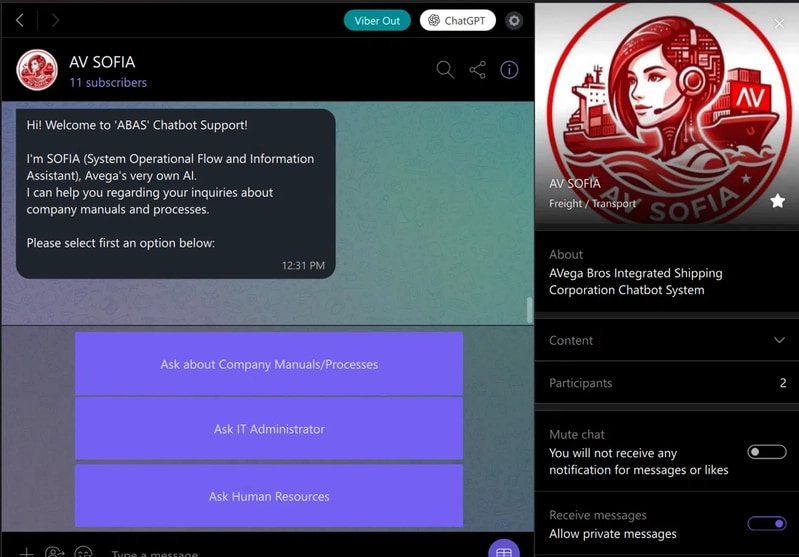
首次使用时,控制器让用户提交员工编号和生日,查询 hr_employees 中的在职记录,再将 Viber ID 绑定到 chatbot_subscriptions。身份查询结果缓存 5 分钟,设置 active = 0 后,撤权也可能需要等待这个窗口。
进入手册查询后,机器人调用 GET /documents/tags 生成分类按钮。选择的标签按用户保存,直到点击 Clear Filter。最近 10 组问答也会随请求发送,用于理解追问。
下面这段是 PHP 对接 RAG 的核心,展示了标签、历史和身份如何通过普通 cURL 一起传递:
$messages = array_reduce($history, function ($acc, $item) {
    $acc[] = ['role' => 'human', 'content' => $item['query']];
    $acc[] = ['role' => 'ai',    'content' => $item['answer']];
    return $acc;
}, []);

$options = ['topK' => $this->rag_top_k, 'sessionId' => $sender_id];
if ($messages) $options['messages'] = $messages;
if ($tag)      $options['tags']     = [$tag];

$payload = json_encode(['query' => $query, 'async' => false, 'options' => $options]);

$ch = curl_init(rtrim($this->rag_base_url, '/') . '/query');
curl_setopt_array($ch, [
    CURLOPT_POST           => true,
    CURLOPT_POSTFIELDS     => $payload,
    CURLOPT_RETURNTRANSFER => true,
    CURLOPT_TIMEOUT        => $this->rag_timeout,
    CURLOPT_HTTPHEADER     => [
        'Content-Type: application/json',
        'X-API-Key: ' . $this->rag_api_key,
        'X-Client: viber-chatbot',
    ],
]);
$raw      = curl_exec($ch);
$httpCode = curl_getinfo($ch, CURLINFO_HTTP_CODE);
重点看 async => false:这里同步等待答案,必须处理生成耗时与 webhook 超时之间的冲突。Mnemosyne 另支持 POST /api/query 返回 jobId,再通过 /api/query/status/:jobId 轮询,但原文没有展示 Viber 改用异步链路后的实现。
Viber 收不到及时的 200 会重试。作者按 message_token 写标记文件去重,清理超过 24 小时,即 86400 秒的记录。旧 ERP 的登录检查、路由和 hooks 也必须避开 webhook,避免提前输出页面,破坏 JSON 响应。
服务端使用 X-API-Key 验证 ERP,使用 X-Session-Token 验证管理界面,并提供输入校验、提示词加固、输出过滤、敏感文档检查、端点限流和 CACHE_TTL 秒缓存。
展示层同样需要适配:429 提示稍后重试,401 引导联系 IT;多个文档参与回答时,最多附上三个来源文件名。_sanitizeForViber 清理 Markdown,并将回复限制在 1000 字符以内。不过它会删除反引号包裹的内容,若以后用于技术问答,可能连代码一起删掉。
我的判断
这套方案最合理的取舍,是复用现有 ERP 的员工数据、Viber 通道和业务入口,把检索生成集中到独立服务。前端或 Node 服务也能复用同一 API,维护边界比较清楚。
但作者关于托管工具无法满足接入需求的说法,只能视为其选型经历。原文没有列出候选产品,不能据此判断托管 RAG 普遍接不了旧 PHP 系统。
相关性门槛能挡住部分无依据回答,不能替代正确性验证。
召回的材料可能相关却过期,也可能只覆盖问题的一半。原文没有说明政策版本、冲突文档和逐条引用如何处理,文件名只能帮助人工回查。员工编号加生日也属于便利验证,作者自己承认,接入工资单等敏感内容前需要可信渠道的一次性验证码。
还有两个实现细节需要打问号。文件去重采用先检查再写入,并不具备原子性,多实例部署也未必共享标记;用「至少两个英文单词或包含 ?」判断问题,也不适合直接照搬到中文输入。
原文提醒不要随意执行 docker compose down,方向上是要求保护数据,但表述不够准确:默认命令通常不会删除命名卷,docker compose down -v 才涉及删除卷。最终仍应检查实际卷配置。WSL2 下作者遇到的 BuildKit 缓存损坏,则是开发环境故障,不能直接归为应用代码问题。
能拿来做什么
- 给旧 PHP、Node 或其他业务系统增加知识问答时,可以先保留现有入口,把检索生成封装成独立 HTTP 服务,统一处理认证、限流和模型配置。
- 整理内部流程库时,可以先试行一主题一文件,补齐标题和标签,再用真实失败问题检查分块效果;不要直接把
TOP_K=5、MIN_RELEVANCE_SCORE=0.15当成标准答案。 - 接聊天 webhook 时,应先确定响应时限、去重方式和后台任务链路。多实例环境需要共享且原子的去重存储,不能直接沿用单机文件方案。
- 给 Next.js 聊天入口接入同一服务时,应由服务端保存 API key,并根据界面选择同步或异步查询;同时保留不知道和来源提示,让用户能识别回答边界。