把业务规则留给代码,让模型只负责解读
作者以易经解读应用为例,将资格检查、起卦逻辑和付费额度决策放在确定性代码中,模型仅根据结构化数据生成解释。完整流程在生成前执行检查,并在生成后验证输出。
AI 深度解读
做 AI 应用,最容易混在一起的是两件事:哪些结果由业务规则决定,哪些内容可以交给模型生成。Quick I Ching 的作者在开发易经解读应用时,选择把模型放到流程后半段,让它解释已经确认的数据,而不参与起卦、扣费和高风险问题的放行。
这篇文章的价值在于划清了一个边界:模型负责表达,应用负责裁决。对正在给产品接入 AI 的程序员来说,这比如何写一段更强的提示词,更值得先想清楚。
模型应该解释结果,还是决定结果
Quick I Ching 把传统起卦方法与 AI 解读结合起来。作者认为,真正的难点不是连接模型,而是把确定性的产品规则与概率性的生成结果分开。
确定性,就是相同条件下,规则应当给出可验证的结果。模型生成则可能受到提示词、上下文和生成过程的影响,不能承担所有业务判断。
作者给出的简化流程如下,它解决的是各个环节由谁负责的问题:
User question
      ↓
Safety / eligibility checks
      ↓
Deterministic casting
      ↓
Structured hexagram data
      ↓
AI interpretation
      ↓
Output validation
      ↓
Successful result
要看清 Structured hexagram data 排在 AI interpretation 前面:模型接手时,卦象状态应当已经由应用确认。
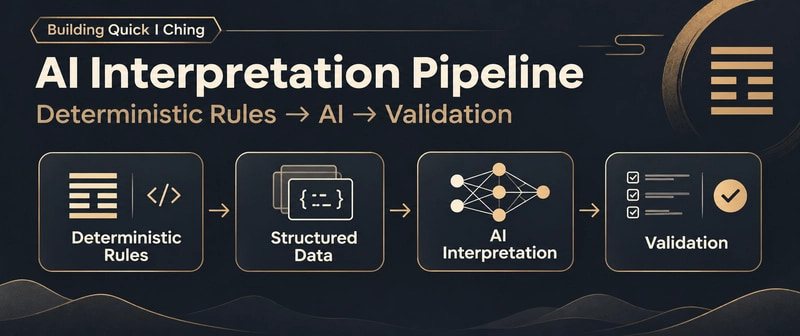
作者没有要求模型同时完成「算出卦象」和「解释卦象」。应用先准备好经过确认的结构化状态及用户提供的上下文,再让模型进行解读。
这能减少一类错误:模型不必从自然语言里重新推导业务状态,也就少了一次推错或补错事实的机会。但它并不能保证解读正确,后面仍然需要检查。
业务事实先由程序确定,再交给模型组织解释。
这里的「事实」指产品内部已经确认的状态,不代表易经解读具有经过验证的预测能力。原文讨论的是软件架构,没有提供这方面的证据。
为什么扣费必须等到生成通过检查
如果调用模型需要花钱,最直接的实现是请求一开始就扣次数,再等待模型返回。作者没有采用这种方式,因为生成可能超时、失败、内容不完整,或者无法通过验证。
他的流程更接近下面这样,解决的是用户何时才应该被扣除额度的问题:
Reserve generation
→ generate
→ validate
→ success: consume credit
→ failure: release it
关键是 success: consume credit:额度先预留,通过验证后才消耗,失败则释放。
这也要求应用明确「成功」的定义。HTTP 响应成功,只能说明请求拿到了响应,不能证明用户拿到了可用结果。作者列出了几类仍需拒绝的输出:
- 必需的章节没有生成完整,或者响应被截断。
- 解读中的结构化事实与已确认的起卦结果冲突。
- 内容出现异常重复,或者前后自相矛盾。
因此,模型输出之后还要经过结构验证和一致性检查,由应用决定接受还是拒绝。作者把质量验证失败视为任务失败,扣费逻辑也就能围绕同一个结果展开。
不过,原文只给了状态流转思路,没有展示额度预留如何落库,也没说明并发请求、重复回调或服务中断时如何处理。要照着落地,这些仍是服务端需要补齐的部分。
高风险问题要在生成之前处理
作者把医疗、法律和投资决策等高风险问题放在解读任务启动前处理。这样,应用可以提前停止流程,不消耗生成额度,也不靠输出末尾的一段免责声明解决产品边界问题。
这里有两个不同的检查位置:前置检查决定「这个请求能不能进入生成」,后置验证决定「这次生成能不能交付」。两者不能互相替代。
但原文没有说明高风险问题如何识别,也没交代使用了关键词、分类模型还是其他机制。因此,可以借鉴的是检查的位置和责任归属,不能直接认定作者已经解决了风险识别的准确性问题。
我的判断
我认同作者对模型权限的限制。提示词可以约束回答方式,但扣费、业务状态和请求资格还需要可追踪、可测试的应用逻辑。把这些判断集中在程序里,维护者更容易知道一次请求为什么成功、为什么失败。
不过,作者说这种边界让系统更容易测试、更少依赖提示词行为,属于生产实践中的经验判断。原文没有提供错误率、成本变化或对照实验,不能据此量化收益。
输出验证也有难易之分。章节缺失、格式错误、明确字段冲突,比较适合写成程序检查;自由文本里的内在矛盾,原文没有给出可靠的检测办法。加上验证环节,不等于已经具备判断全部内容质量的能力。
相比把所有要求塞进提示词,这套分工更容易审计,但也增加了状态管理和验证逻辑。合理的取舍是先把必须准确的业务字段收回程序控制,再逐步补充能够明确判定的检查。
能拿来做什么
- 给现有 AI 功能梳理一次决策权限,把业务结果、请求资格和额度扣减列出来,明确哪些必须由服务端决定。
- 在 Node 服务中先构造经过确认的结构化输入,再调用模型,减少让模型从长文本中重新猜测业务状态的步骤。
- 对按次收费的生成任务,设计预留、成功消耗和失败释放的状态流转,并补齐并发与重复处理规则。
- 把 HTTP 成功和任务成功分开记录,先验证必需章节、内容完整性和关键字段一致性,再决定是否交付和扣费。