财务Agent的记忆何时必须失效
Ledgerwise通过检索供应商历史处理记录辅助解决发票异常,作者称三周发票回放中的自动处理比例达到75%。系统先确定性核对采购单、收货单与发票,再由策略决定历史记忆能否参与决策。
AI 深度解读
给 Agent 加上记忆,能让它从历史审批中学会处理重复问题,也可能让一次误判不断给后续误判提供证据。Ledgerwise 做发票异常处理时,把重点放在了另一个问题上:哪些情况下,即使找到相似先例,也必须交给人。
作者报告,在三周发票回放后,自动处理率从 0% 升到 75%。但更有参考价值的是它如何限制记忆:只采信人工决策、比较具体金额、遇到分歧就暂停自动处理,并把付款决策留在确定性规则里。这套分工,也适合拿来审视日常 AI 工作流。
找到相似先例,为什么还不能自动批准
Ledgerwise 先做确定性的三方匹配,核对采购订单、收货记录和发票,再标记价格偏差、少发货、GST 税率错误、额外附加费等异常。每个异常都有明确量级:价格用百分比,附加费用卢比,缺货用件数。
Hindsight 负责记忆。系统会查询某供应商过去的同类异常如何处理,以及审核人为什么这么处理。决策策略随后判断:这些历史证据是否足够支持自动执行。
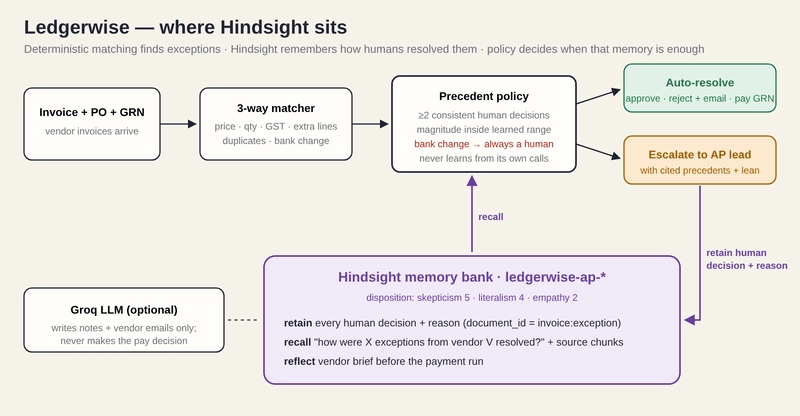
记忆负责提供证据,规则负责限定证据能支持什么动作。
第一条边界直接按异常类型划定。银行账户变更和缺少采购订单,始终需要人工处理:
NEVER_AUTO = {"BANK_CHANGE", "NO_PO"}

if exc.type in NEVER_AUTO:
    precs = self.recall_precedents(vendor, exc)
    return ExceptionDecision(exc.to_dict(), "ESCALATE", False,
        "Guardrail: bank/PO changes always need a human call-back check.",
        [p.to_dict() for p in precs])
要看的是 recall_precedents 这一行:禁止自动执行,并不等于禁止检索。历史仍然可以帮助人判断,只是不参与自动放行。
回放数据里,Meridian Electricals 在第六周提出变更收款银行,此前已有六张正常付款的发票。供应商历史再干净,也不能证明新账户可信,系统因此要求人工通过已存档号码回拨确认。
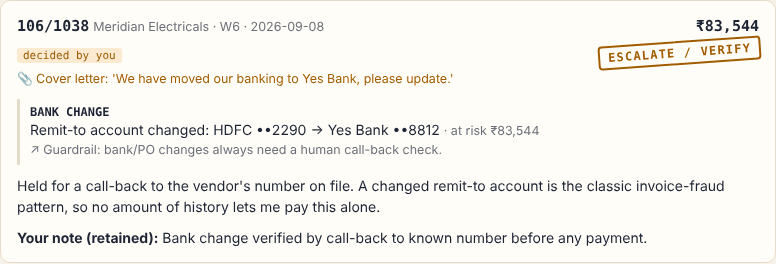
第二条边界是证据来源。自动决策也会留存,标记为 decided_by: Ledgerwise agent (auto),用于审计和生成供应商简报;但计算先例时,只保留 p.is_human 的记录。
否则,一次错误批准会进入记忆,下一次又被检索出来充当依据。作者为此写了测试:即使记忆里有三条 Agent 批准记录,系统仍然必须转人工。
同一种异常,金额不同就该重新判断
语义相似不代表风险相同。对检索系统来说,2.8% 和 4.2% 都可能是「同一供应商的价格偏差」,但业务上不能直接沿用结论。
作者因此把异常量级存进每条记忆,再用数值规则判断:
approved = [p.magnitude for p in precs if p.decision == "APPROVE"]
rejected = [p.magnitude for p in precs if p.decision == "REJECT"]
cap = max(approved) * MAGNITUDE_HEADROOM if approved else None   # +10%
floor = min(rejected) if rejected else None
要看的是 cap:它以人工批准过的最大值为基础,增加 10% 余量。floor 则取历史拒绝记录中的最小值。原文没有给出后续完整判断分支,不能仅凭这几行推断所有边界行为。
这里也有一个措辞上的取舍:作者称系统「不超出人工批准范围外推」,实现却允许 +10% 余量。它实际采用的是带缓冲的经验边界。
两个案例能看出规则的作用。Sharma Logistics 提交 ₹6,800 燃油附加费,历史上虽然都获批准,但批准金额最高只有 ₹2,400。系统于是转人工,并提示「远超已批准范围,倾向拒绝」。审核人的拒绝会被保留,供后续判断使用。
Tata Steel 的案例则相反。人工此前最多批准 +2.8%,新发票是 +3.1%,略高于增加 10% 后的 3.08% 上限。系统转人工,但提示「倾向批准」;审核人确认后,历史批准范围随之扩大。
这种升级处理有价值的地方,是把最接近的先例和倾向一起交给人。作者认为,这能把审核压缩到几秒;原文没有提供系统性的耗时对照。
对少发货、重复发票这类是非型异常,作者采用另一条规则:最近三次人工决策一致,才允许自动处理。一旦有人推翻惯例,就暂停自动执行,等待人工判断重新一致。
不过,原文展示的代码只有 precs[-3:] 和结果集合检查,没有显式确认记录数达到三条。完整实现是否补了数量校验,原文没说清,照搬时必须检查。
LLM 写解释,付款决定交给可复现的策略
Ledgerwise 使用 Groq 上的 openai/gpt-oss-120b,为审核人撰写解释,并生成发给供应商的邮件。它不负责决定付款或拒付。
如果模型响应慢、不可用或输出异常,系统改用普通模板,发票仍能继续流转。作者称,每次决策都能根据先例复现,这也降低了测试难度。
但确定性策略依赖精确的输入,Hindsight 的三个配置和数据选择因此很关键:
- 创建记忆库时设置
skepticism: 5、literalism: 4,目的是减少把一次 3% 偏差获批泛化成「价格偏差都可以接受」的情况。 - 检索使用
include_chunks=True,返回提取事实背后的原始片段,让策略有机会核对具体数字。 - 保存人工理由,而非只记批准或拒绝。例如「HSN 2839 合同税率是 12%,不要支付按 18% 开出的版本」,比一个批准标签更有解释力,也能供 Hindsight 的
reflect生成供应商简报。
这些是作者采用的做法。原文没有给出参数对照实验,也没有展示从原始片段到结构化数值的完整校验过程,不能把配置值当成通用答案。
效果数据来自六家供应商、八周发票的回放。作者称三周后自动处理率达到 75%,第五、第六周降至 60%,对应价格偏差、大额附加费和银行变更等情况被转交人工。
这里的下降符合策略设计,但它仍是回放结果,不能直接等同于真实生产环境的长期表现。
我的判断
我认可这套设计对「记忆」的定位:历史记录是带来源、量级和理由的证据,能否执行还要另行判断。尤其是隔离 Agent 自己产生的先例,能切断一种隐蔽的错误放大路径。
它也说明了规则系统与 LLM 可以怎样分工。边界清楚、结果需要审计的业务,可以用代码决定动作,再让模型处理解释。代价是团队必须持续维护异常分类、阈值和升级策略。
局限同样明确:历史人工决策可能有错,合同也可能变化。最近三次一致,只能证明近期一致;历史最大批准值,也未必仍然适用。
作者提出「56% 自动化率且零错误,比 90% 自动化率但有几次错误更值得」,这是评价标准,不是文中已经证明的实验结果。原文没有报告完整的错误自动决策统计,也没有与纯检索、纯规则或 LLM 决策方案做对照。
这些护栏值得借鉴,效果仍应按自己的业务数据验证。
能拿来做什么
- 给 AI 工作流加入历史记忆前,先列出必须转人工的动作,并把这些限制放进实际执行路径,避免只写在提示词里。
- 用 Node 编排检索和决策时,把操作者、异常类型、具体量级、处理结果和人工理由分别存储,让审计记录与可采信先例能够区分。
- 在审核界面展示最接近的先例、原始理由和转人工原因,让审核人可以快速核对证据,再决定是否放行。
- 评估自动化效果时,同时统计错误自动决策和转人工情况;为「只有 Agent 先例」「人工最近有分歧」「金额超出范围」分别补上策略测试。