
8.0
热点
AI SCORE
开源项目2026-08-22 16:23
AI短视频一键生成开源工具
GitHub Trending#AI视频#开源#自动化
Editor brief · 编辑速览
MoneyPrinterTurbo支持输入主题关键词全自动生成视频脚本、素材匹配、字幕和配乐,可集成Kimi K3、豆包等国产模型驱动文案创作。
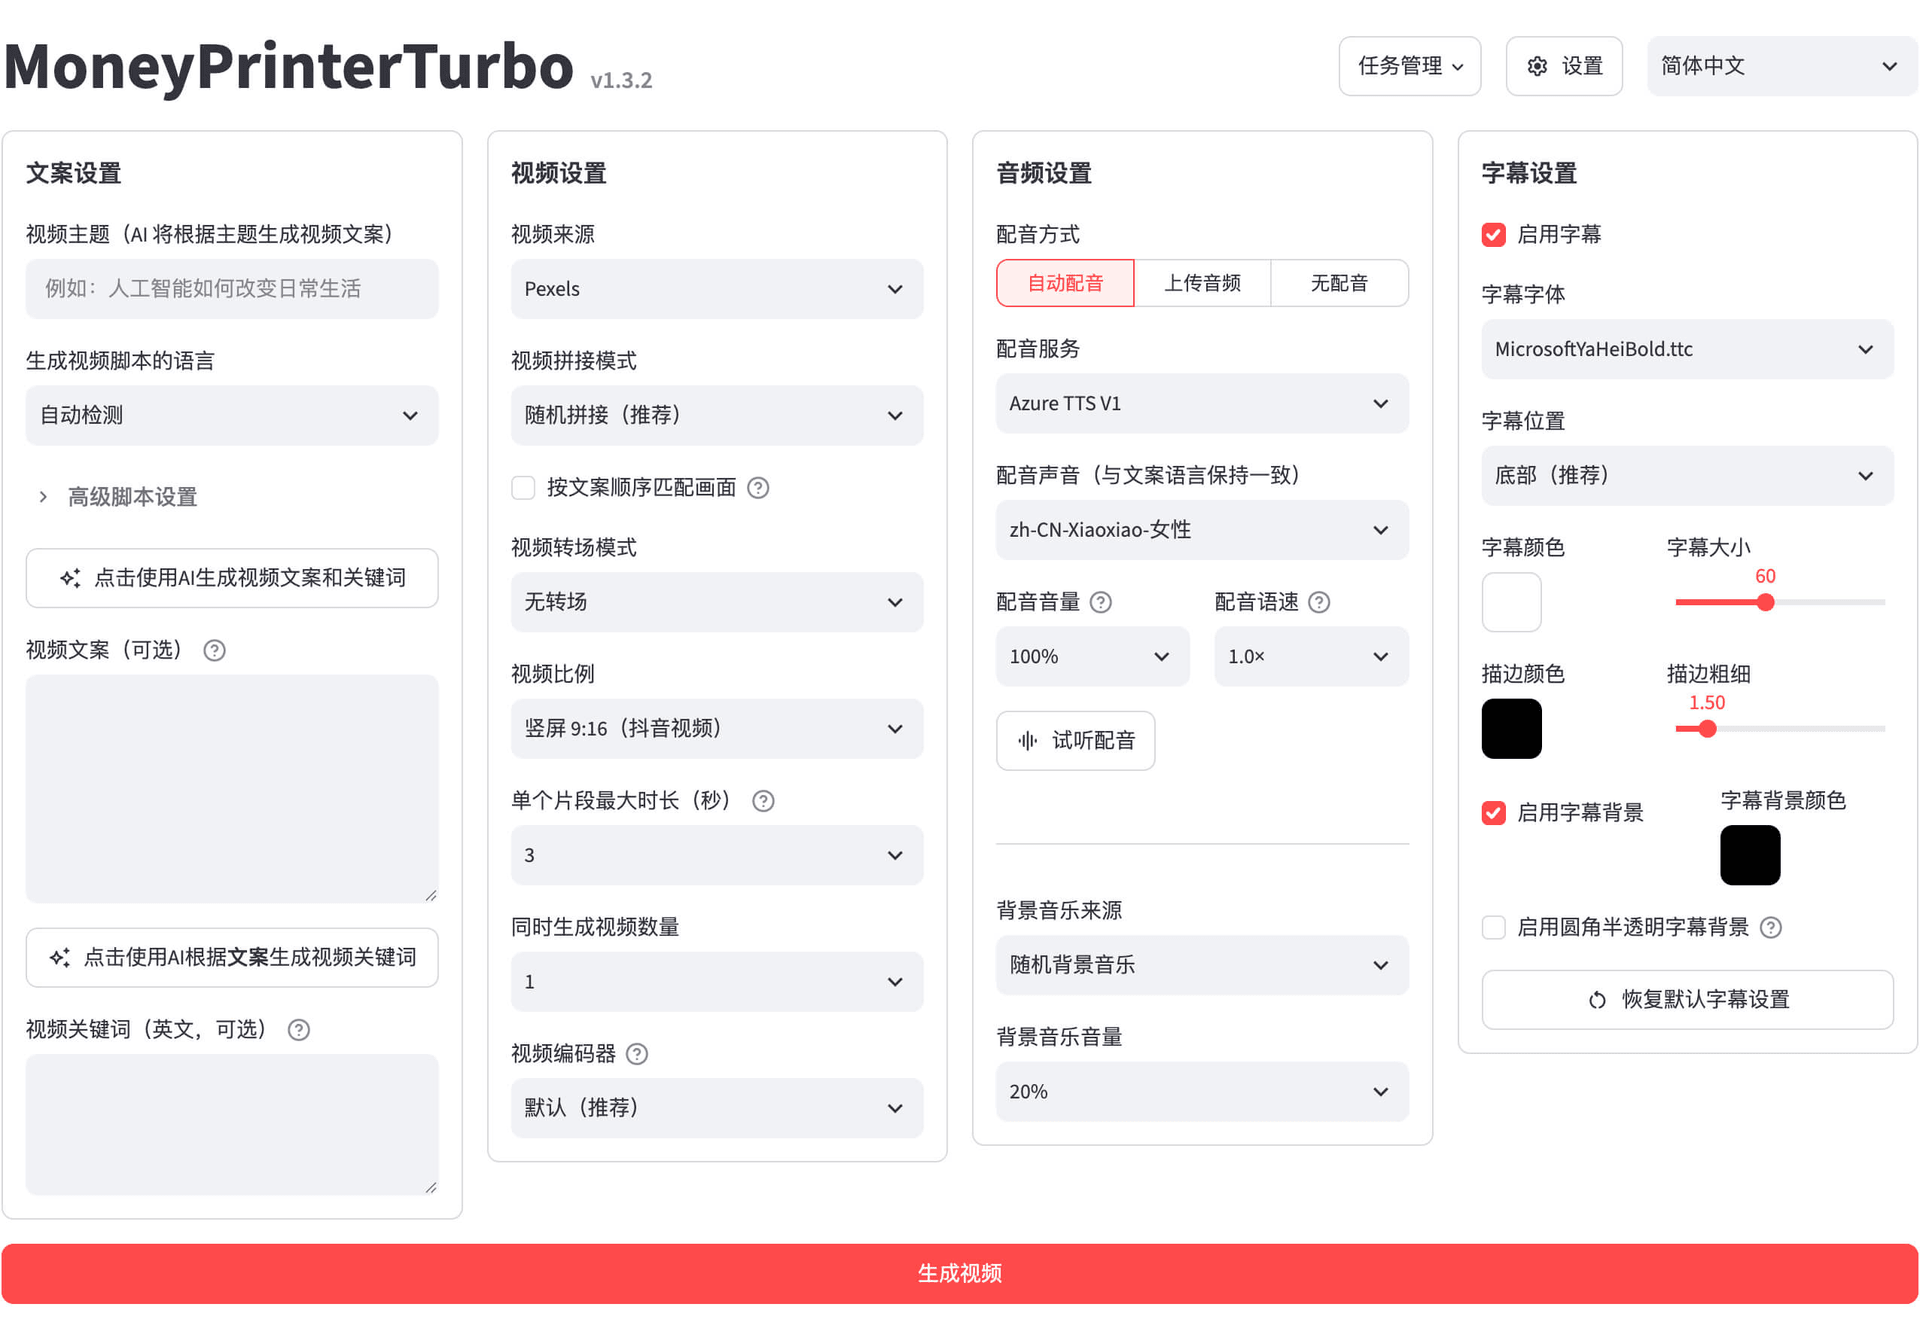
只需提供视频主题或关键词,即可自动生成视频脚本、匹配素材、生成字幕和背景音乐,并合成高清短视频。
简体中文 | English | 日本語 | 版本发布 | 问题反馈
感谢 Kimi 赞助本项目!Kimi K3 是 Moonshot AI 迄今能力最强的模型,也是全球首个开源 3T 级模型,拥有原生视觉能力与 100 万 Token 上下文,在知识工作、推理和长周期任务中展现前沿性能。在 MoneyPrinterTurbo 中,K3 能直接驱动视频创作,不仅撰写视频文案,还会提炼素材搜索关键词、决定成片画面;对内容理解越准确,匹配到的素材就越贴题。
MoneyPrinterTurbo 用户专属优惠:新用户通过专属链接注册,首次成功充值可获充值金额 10% 的 API 额度,最高赠送 ¥1000。活动截至 2026 年 9 月 30 日。前往 Kimi 开放平台(中文站|Global)体验 API。
作者的另一个开源项目:MangoDisk ⭐
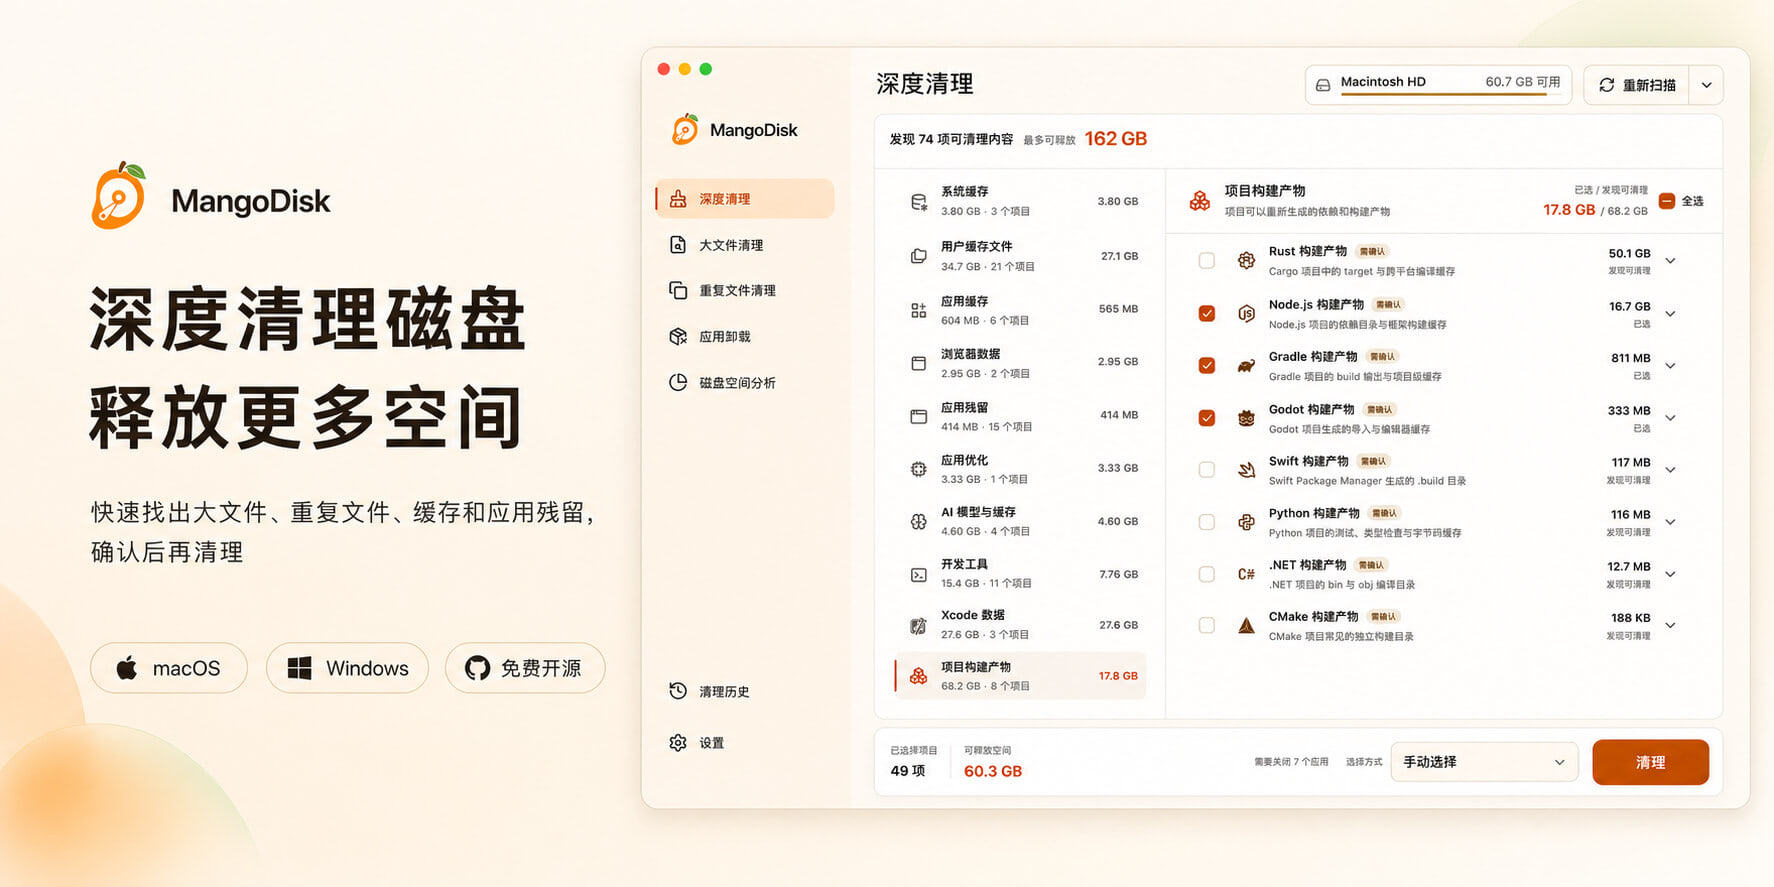
适用于 macOS 和 Windows 的安全优先开源磁盘清理与空间分析工具 查找大文件和重复文件,清理缓存与应用残留,安全释放磁盘空间。
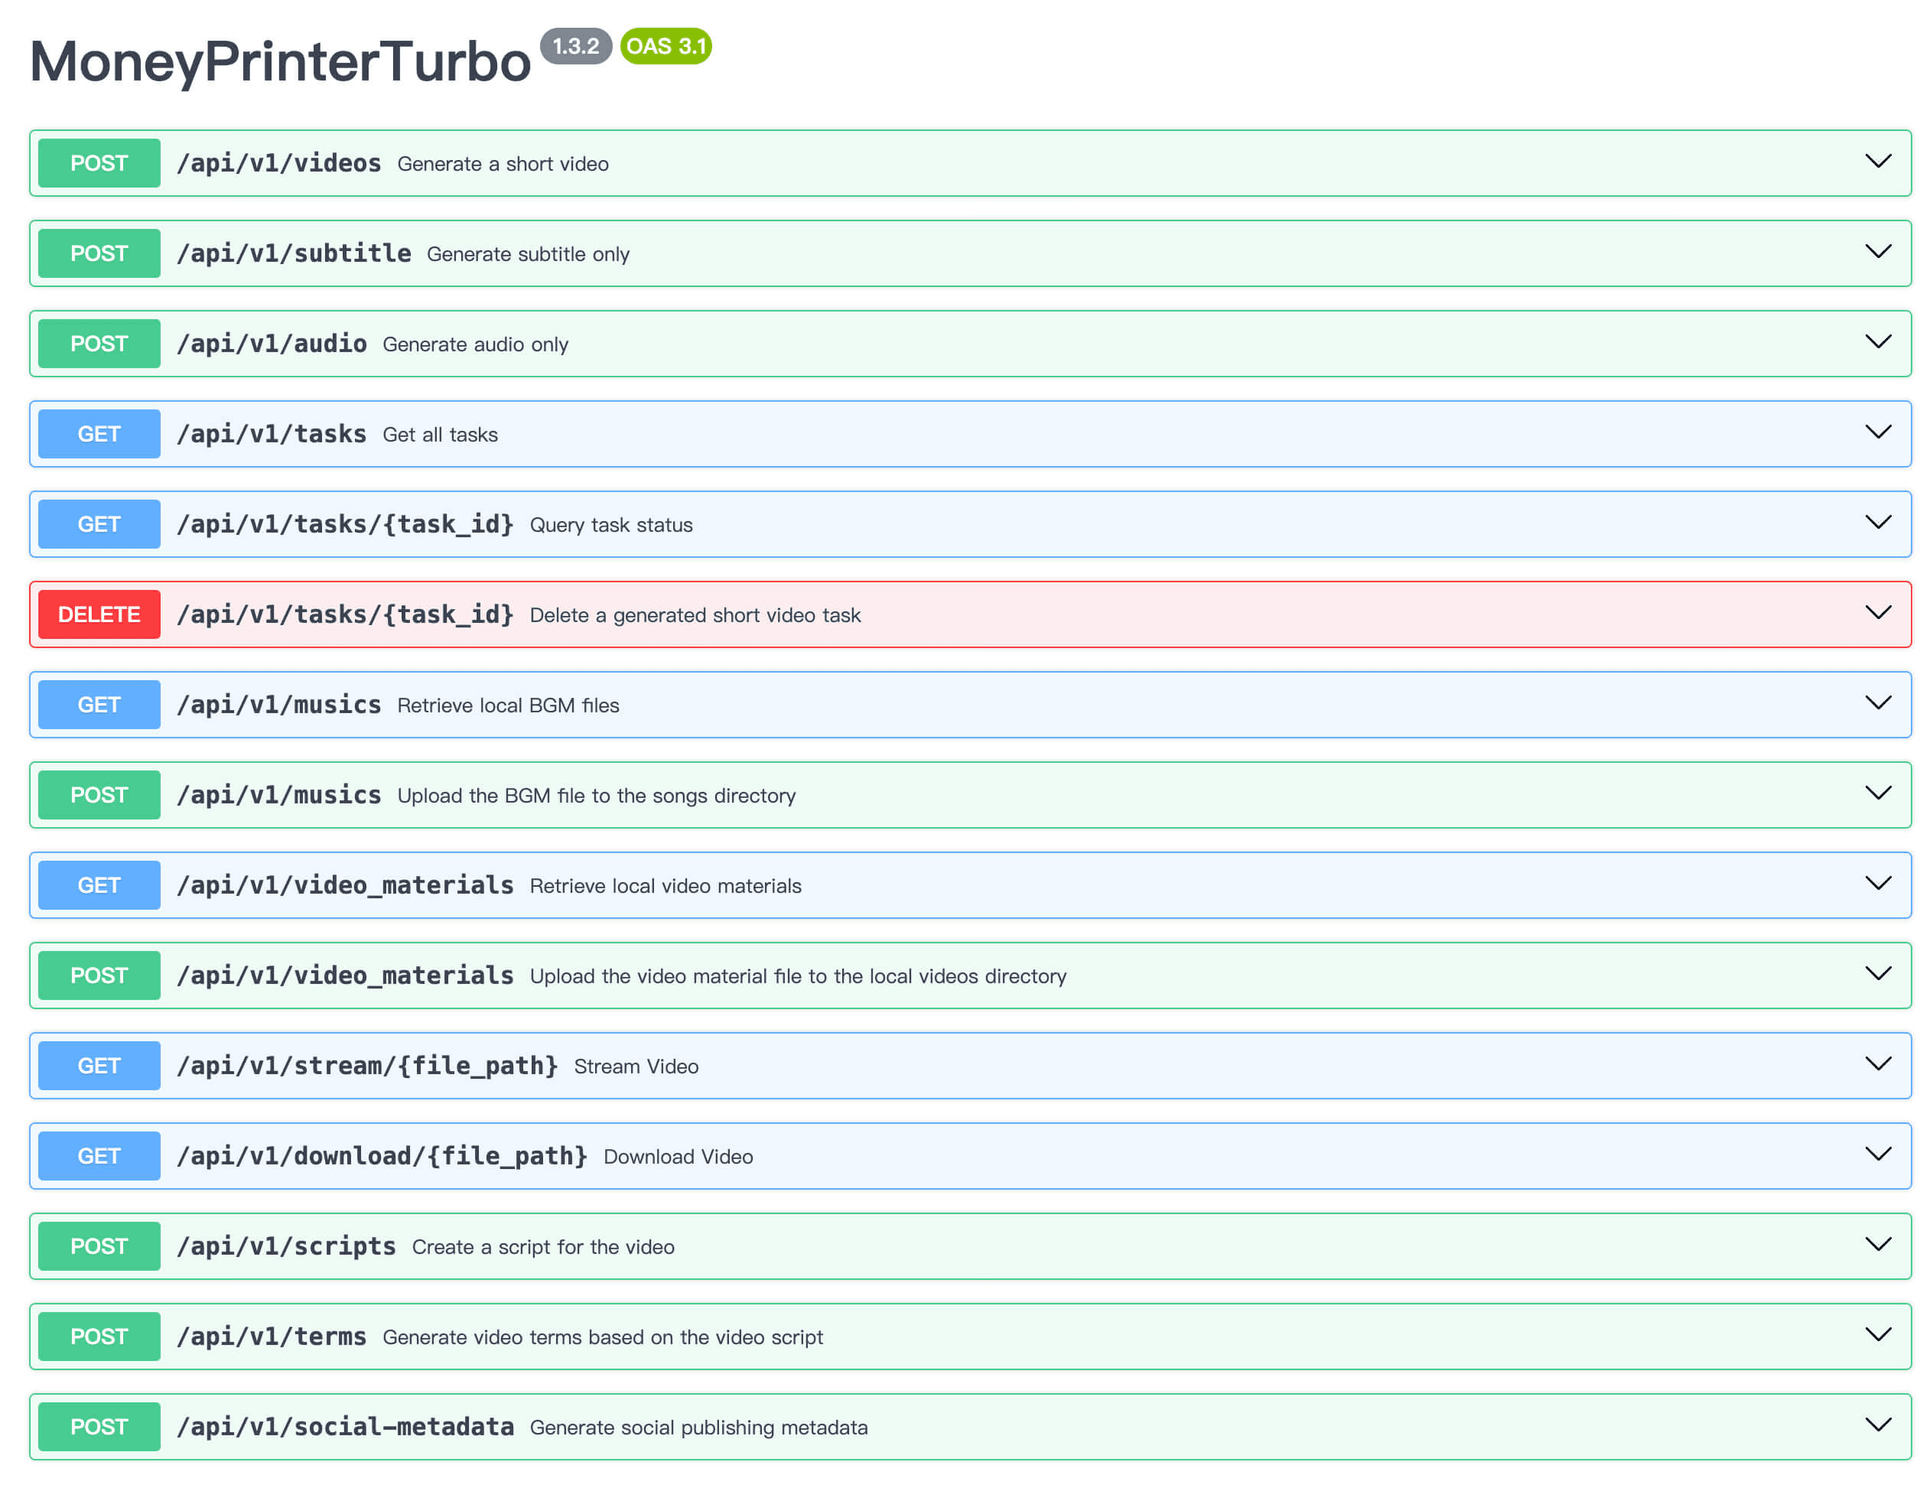
提供 AI Agent、WebUI、API 和 CLI 四种使用方式,代码按控制器、服务和模型等职责分层
支持 AI 自动生成视频脚本,也可以使用自定义脚本
支持多种 高清视频 尺寸 竖屏 9:16,1080x1920 横屏 16:9,1920x1080
支持 批量视频生成,可以一次生成多个视频,然后选择一个最满意的
支持 视频片段时长 设置,方便调节素材切换频率
支持 Edge TTS、Azure Speech、SiliconFlow、Google Gemini、小米 MiMo、ElevenLabs 和 Chatterbox 语音合成,可实时试听
支持 字幕生成,可调整字体、位置、颜色、大小、描边和背景样式
支持 背景音乐,可随机选择或使用指定音乐,并调整音量
支持使用自己的 本地素材,也可从 Pexels、Pixabay 和 Coverr 获取可免费使用的高清素材
支持 AI 生成素材:接入 WaveSpeed AI 文生视频模型(默认 Seedance),按脚本关键词直接生成全新画面,不再受限于库存素材
支持 Kimi / Moonshot AI、OpenAI、Anthropic Claude、Google Gemini、DeepSeek、阿里云通义千问、Microsoft Azure OpenAI、火山引擎方舟、xAI Grok、MiniMax、小米 MiMo 等主流模型服务,并兼容 Cloudflare AI Gateway、魔搭 ModelScope、AIHubMix、AIML API、EvoLink、Ollama、OneAPI、LiteLLM、Groq、Polinations AI 等统一网关、聚合平台和本地运行环境
支持一键 跨平台发布,生成完成后可自动上传至 TikTok、Instagram 和 YouTube Shorts
支持将生成设置导出和导入为预设文件,并在设置弹窗中备份和恢复所有 API Key
以下示例均由 MoneyPrinterTurbo 实际生成。
建议系统:Windows 10、macOS 11.0 或更高版本,以及主流 Linux 发行版
本地部署需要 Python 3.11 或更高版本,推荐使用 Python 3.11
GPU 不是必需项,但如果你希望本地转录、更快的视频处理或更顺畅的批量生成体验,建议使用带显存的独立显卡
如果你主要依赖云端 LLM、云端 TTS 和在线素材源,CPU 与内存比 GPU 更重要
如果你启用 faster-whisper、批量生成或更重的本地处理链路,GPU 会明显提升速度
不想手动安装和配置:直接使用 AI Agent 生成视频
Windows 用户:优先使用一键启动包,适合快速体验
macOS / Linux 用户:优先使用 uv 进行本地部署
想要隔离运行环境:优先使用 Docker 部署
如果你的 AI Agent 支持读取 Skill 文档并操作本地终端,可以直接发送下面这段话。Agent 会自动完成安装、配置和视频生成;只有缺少必要的 API Key 时才会向你询问,完成后会返回生成的视频文件路径。目前支持 macOS 和 Windows。
使用这个 Skill:https://raw.githubusercontent.com/harry0703/MoneyPrinterTurbo/main/docs/skill/SKILL.md
帮我生成一个主题为"人工智能如何改变普通人的日常生活"的视频。
免去本地环境配置,点击直接在 Google Colab 中快速体验 MoneyPrinterTurbo
下载一键启动包,解压直接使用(路径不要有 中文、特殊字符、空格)
GitHub Releases:https://github.com/harry0703/MoneyPrinterTurbo/releases/latest
下载后,建议先双击执行 update.bat 更新到最新代码,然后双击 start.bat 启动
启动后,会自动打开浏览器(如果打开是空白,建议换成 Chrome 或者 Edge 打开)
本地部署需要 Python 3.11 或更高版本
Windows 用户建议避免使用包含中文、特殊字符或空格的项目路径
git clone https://github.com/harry0703/MoneyPrinterTurbo.git
首次启动时,项目会根据 config.example.toml 自动创建 config.toml。大模型 Provider、素材来源和相关 API Key 可以直接在 WebUI 的基础设置中配置。
如果未安装 Docker,请先安装 https://www.docker.com/products/docker-desktop/
https://learn.microsoft.com/zh-cn/windows/wsl/install
https://learn.microsoft.com/zh-cn/windows/wsl/tutorials/wsl-containers
cd MoneyPrinterTurbo
docker compose -f docker-compose.release.yml up
默认推荐使用 docker-compose.release.yml,它会直接拉取 GitHub Container Registry 上的预构建镜像:ghcr.io/harry0703/moneyprinterturbo:latest。 如果你需要本地重新构建镜像,可以继续使用 docker compose up。 首次启动前,请将 config.example.toml 复制为 config.toml,供容器挂载使用。
打开浏览器,访问 http://127.0.0.1:8501
打开浏览器,访问 http://127.0.0.1:8080/docs 或者 http://127.0.0.1:8080/redoc
完整的使用演示:https://v.douyin.com/iFhnwsKY/
如何在 Windows 上部署:https://v.douyin.com/iFyjoW3M
推荐使用 uv 管理 Python 环境和依赖。项目支持 Python 3.11 或更高版本,以下示例使用 Python 3.11。
git clone https://github.com/harry0703/MoneyPrinterTurbo.git
cd MoneyPrinterTurbo
uv python install 3.11
uv sync --frozen
如果你暂时不使用 uv,也可以继续使用 venv + pip
python3.11 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
pyproject.toml 是主依赖定义文件
uv.lock 是锁文件,建议默认执行 uv sync --frozen
requirements.txt 仅保留给旧的 pip 安装方式兼容使用
注意需要到 MoneyPrinterTurbo 项目 根目录 下执行以下命令
.\webui.bat
在 CMD 中也可以执行 webui.bat。 webui.bat 会优先使用项目 .venv 或一键包内置 Python;如果没有找到项目 Python,但已安装 uv,会自动切换为 uv run streamlit。 如需允许局域网内其他设备访问 WebUI,可以先执行 set MPT_WEBUI_HOST=0.0.0.0,再运行 webui.bat。
sh webui.sh
脚本会自动使用项目虚拟环境或 uv,并选择可用的本地端口。如需允许局域网内其他设备访问,可以执行:
MPT_WEBUI_HOST=0.0.0.0 sh webui.sh
启动后,会自动打开浏览器(如果打开是空白,建议换成 Chrome 或者 Edge 打开)
uv run python main.py
如果你已经手动激活了虚拟环境,也可以直接执行:
python main.py
如果你无法使用浏览器或端口转发,可以直接在命令行生成视频。最简单的完整视频生成命令如下:
uv run python cli.py --video-subject "人工智能如何改变日常生活"
如需查看完整命令、参数说明和使用方法,可以执行:
uv run python cli.py --help
默认使用免费的 Edge TTS,在 WebUI 中显示为 Azure TTS V1。项目同时支持 Azure TTS V2、SiliconFlow TTS、Google Gemini TTS、小米 MiMo TTS、ElevenLabs TTS、自托管 Chatterbox TTS,以及无配音模式。
可直接在 WebUI 中选择 Provider 和音色,并按照界面提示填写所需凭据。Edge TTS 不需要 API Key;Azure TTS V2 及其他云端服务需要对应平台的凭据。Edge TTS 音色可查看:音色列表。
edge:使用 TTS 时间戳生成字幕,速度快,不需要 GPU,默认使用该模式。
whisper:使用本地 faster-whisper 转写音频,适用于需要更准确字幕时间轴的场景。首次使用时需要下载模型。
在 config.toml 中修改 subtitle_provider 即可切换模式。Whisper 默认使用约 3 GB 的 large-v3;如需更小、更快的模型,可以使用约 1.6 GB 的 large-v3-turbo:
[app]
subtitle_provider = "whisper"

[whisper]
model_size = "large-v3-turbo"
首次使用 Whisper 时,程序会自动从 Hugging Face 下载模型。如果当前网络无法自动下载,可以从 Hugging Face 手动下载 whisper-large-v3。
下载并解压后,将整个目录放到 .\MoneyPrinterTurbo\models,最终路径应为 .\MoneyPrinterTurbo\models\whisper-large-v3:
MoneyPrinterTurbo
  ├─models
  │   └─whisper-large-v3
  │          config.json
  │          model.bin
  │          preprocessor_config.json
  │          tokenizer.json
  │          vocabulary.json
用于视频的背景音乐,位于项目的 resource/songs 目录下。
当前项目里面放了一些默认的音乐,来自于 YouTube 视频,如有侵权,请删除。
用于视频字幕的渲染,位于项目的 resource/fonts 目录下,你也可以放进去自己的字体。
注册 Upload-Post 账号并获取 API Key,然后在 config.toml 的 [app] 下添加以下配置:
[app]
upload_post_enabled = true
upload_post_api_key = "your-api-key"
upload_post_username = "your-username"
upload_post_platforms = ["tiktok", "instagram", "youtube"]
upload_post_auto_upload = true
upload_post_youtube_privacy_status = "public"
保存配置并重启项目。视频生成完成后,程序会自动发布到已配置的平台。YouTube 可见性可设置为 public、unlisted 或 private。
通常情况下,ffmpeg 会被自动下载,并且会被自动检测到。 但是如果你的环境有问题,无法自动下载,可能会遇到如下错误:
RuntimeError: No ffmpeg exe could be found.
Install ffmpeg on your system, or set the IMAGEIO_FFMPEG_EXE environment variable.
此时你可以从 https://www.gyan.dev/ffmpeg/builds/ 下载ffmpeg,解压后,设置 ffmpeg_path 为你的实际安装路径即可。
[app]
# 请根据你的实际路径设置,注意 Windows 路径分隔符为 \\
ffmpeg_path = "C:\\Users\\harry\\Downloads\\ffmpeg.exe"
这个问题是由于系统打开文件数限制导致的,可以通过修改系统的文件打开数限制来解决。
ulimit -n
ulimit -n 10240
LocalEntryNotFoundError: Cannot find an appropriate cached snapshot folder for the specified revision on the local disk and
outgoing traffic has been disabled.
To enable repo look-ups and downloads online, pass 'local_files_only=False' as input.
An error occurred while synchronizing the model Systran/faster-whisper-large-v3 from the Hugging Face Hub:
An error happened while trying to locate the files on the Hub and we cannot find the appropriate snapshot folder for the
specified revision on the local disk. Please check your internet connection and try again.
Trying to load the model directly from the local cache, if it exists.
解决方法:查看如何从 Hugging Face 手动下载模型
可以提交 issue 或者 pull request。