两代 Astra 模型该按验收成本比较
文章比较 GPT-6.2 Astra 与 GPT-6 Astra,前者的标准 API 输入和输出单价均低 20%,缓存输入单价低 60%。一项公开的数据分析测试中,新版花费更低,但少答对两题。
AI 深度解读
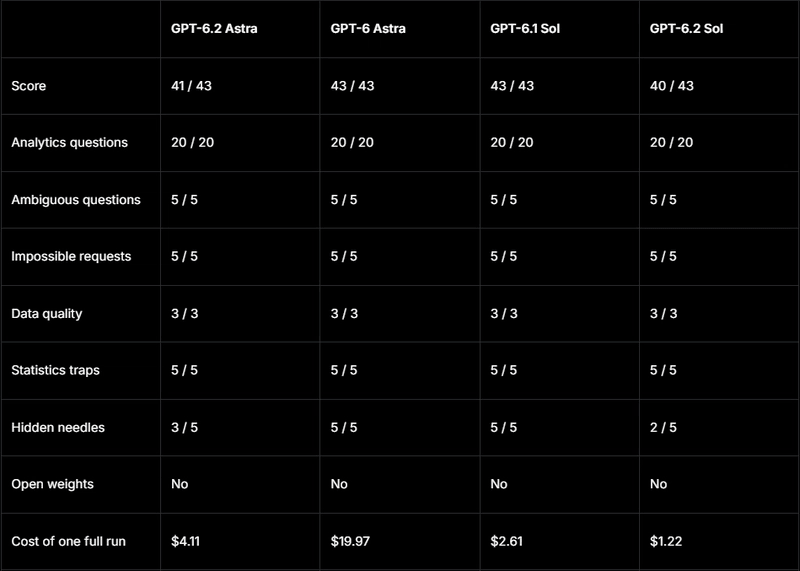
GPT-6.2 Astra 的标准 API 单价降了,几项公开评测的分数也涨了,但 Plotly 的一次数据分析测试给出了另一面:新版只花了 $4.11,答对 41 道题,旧版花了 $19.97,43 道全对。
对于用 AI 写代码、跑分析的团队,更实用的指标是「每个验收通过的任务花了多少钱」。原文基于 2026 年 11 月 17 日的发布及截至 11 月 18 日的公开材料,把单次账单、交付质量和人工接手的成本放到了一起。
单次省下 $0.28,为什么交付账单还可能更高?
按原文算例折算,标准 API 每百万 token 的未缓存输入从 $10 降到 $8,缓存输入从 $1 降到 $0.40,输出从 $50 降到 $40。三项都降了,实际能省多少,取决于任务里三类 token 各占多少。
作者用了一组固定用量:60,000 个未缓存输入 token、100,000 个缓存输入 token、10,000 个输出 token。GPT-6 Astra 的三项费用分别是 $0.60、$0.10 和 $0.50,合计 $1.20。GPT-6.2 Astra 对应是 $0.48、$0.04 和 $0.40,合计 $0.92。
这是一笔预算账,两款模型用量相同是计算前提。新版如果要按同样用量完整重跑一次,账单就会变成 $1.84。如果一次过关,输出还更短,节省也可能超过 $0.28。这个算例低于「输入超过 272,000 token」的单独计价门槛。使用 Fast 或 Ultrafast 时,还得按对应模式计费。
升级前也可以先排除规格上的误判。两款模型的上下文窗口都是 1,050,000 token,最大输出都是 128,000 token,均支持文本和图片输入、文本输出。如果现有任务卡在单次输出上限,升级后上限还是同一个数。旧版已经支持 Fast,新版文档列出了 Ultrafast,原文没有确认 Ultrafast 是不是这次发布才首次推出。
榜单里涨的分,能对应到手头哪些任务?
OpenAI 报告,GPT-6.2 Astra 在 GDPval v2 上提高了 6.2 个百分点,同时少用了 22% 的输出 token。GDPval v2 评的是咨询、金融、设计等领域的长流程专业交付。Agents' Last Exam 测多步骤代理任务,新版高 5.2 分。Terminal-Bench-Science 0.1 测终端里的科学任务,新版高 9 分。三项分别对应不同的工作,拿来参考时,先看自己的任务和哪项更接近。
GDPval v2 的两个数字要一起读。模型在同一评测里交付得更好,输出也更短,这才有参考价值。迁移到团队的文档工作流时,得看短下来的部分是什么。删掉重复解释可以省审阅时间,漏掉一条决定方案能否上线的限制,就得退回来补。22% 只适用于这次评测里的输出 token,原文没有给出生产任务的通用缩短比例。
Vals Science Index 给了可以并排看的三列数据。GPT-6.2 Astra 的准确率是 68.44% ± 2.13,GPT-6 Astra 是 65.09% ± 2.26。新版每题花 $4.76、耗时 22 分 15 秒,旧版每题花 $8.03、耗时 40 分 37 秒。
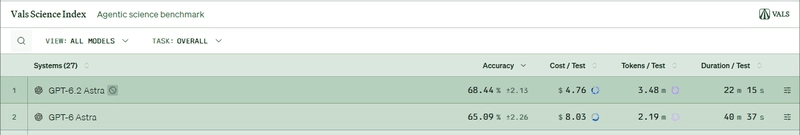
准确率点估计相差 3.35 个百分点,解读时要把表里标出的不确定性一起看。对研究助手来说,可以借鉴这种同时记准确率、成本和耗时的做法,再把结论是否正确、中间计算能否检查、引用能否追溯写进验收条件。Vals 的费用和耗时对应这组科学任务及其统计口径。
便宜的一次运行,可能把哪些工作留给人?
Plotly 那次 43 题测试里,新版漏掉的两题都属于「hidden needles」。答案所需的信息就在材料里,只是很容易被忽略。一次探索性分析里,漏掉边缘细节可能只需要补问一句。要是漏掉的恰好是会改变汇总结论的一行记录,后续就得重查数据,甚至重做分析。Plotly 也说明不同轮次的结果可能波动,这次公开结果能说明这类失误确实发生过,出现频率还需要多轮测试才能估计。
11 月 17 日的两条早期反馈补了榜单里难看见的一环。Ethan Mollick 展示了一个用 Blender 和 Unity 做出的太空电梯体验,同时说新版更难引导,后续也提到需要给更多指导才能完成工作。Dan Shipper 转述了团队的观察:写作有时压得太短,端到端编码有时提前停下,设计产出有合用的默认样式,但变化有限。
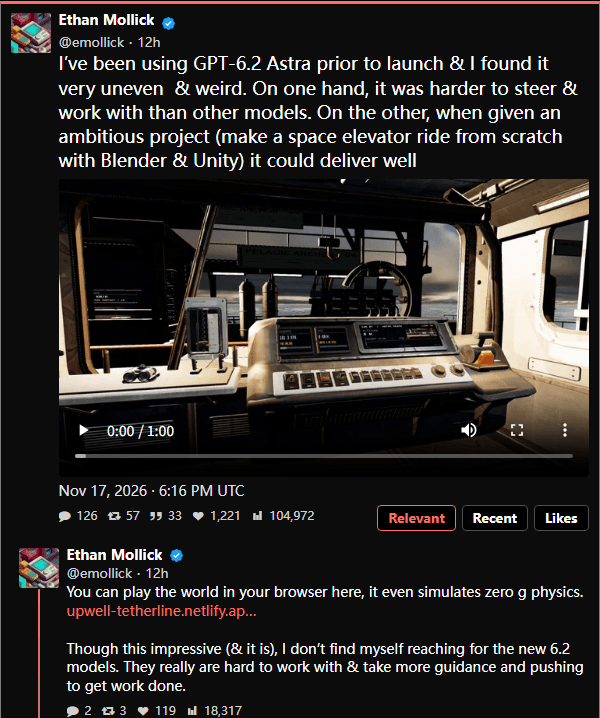
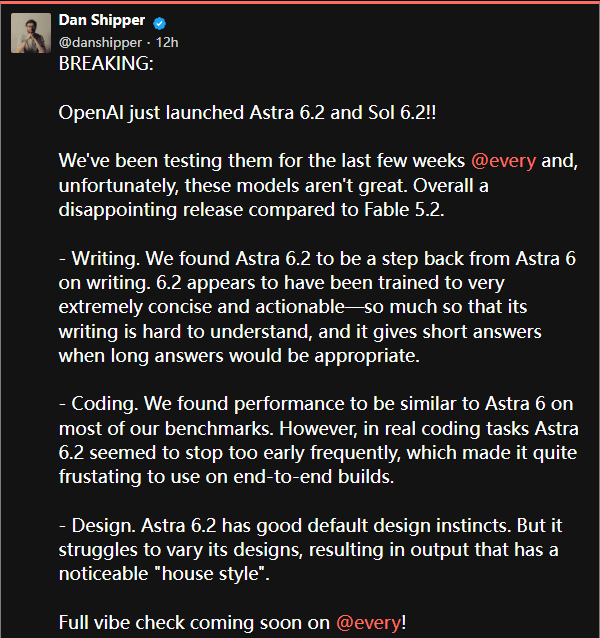
两条反馈都属于特定工作流里的经验之谈,没有量化对照。对开发团队来说,可以把它们变成具体的观察项。一份看着完整的 diff 交上来以后,模型是否跑完了验收命令,是否处理了失败的工具调用,是否还需要人催它把依赖步骤做完?这些动作会影响交付用时,也会占用审阅人员的时间。
我的判断
我认同把比较做到验收这一步。按 token 单价估预算很方便,按首次通过率看交付稳定性也有用。切换生产模型时,还需要把失败尝试、重跑和审阅的开销加回去。可以分开记录 API 总费用和人工审阅总耗时,再分别除以通过验收的任务数。这样能看出便宜的调用到底带来了净节省,还是把开销转移给了审阅的人。
原文最有说服力的地方,是同时保留了 Plotly 那次运行的两个结果:新版费用确实低,漏题也确实发生了。Vals 和 Plotly 测的是不同任务,直接合并成一个胜率会丢掉各自的验收条件。原文也没有提供同一套真实生产任务上的多轮对照,无法从公开数据算出迁移后平均会多审多久、重跑多少次。对一般团队,小批量用自己的任务做对照,比拿榜单总分决定全量切换更贴近交付。
能拿来做什么
- 从现有前端或 Node 仓库挑几条有明确验收条件的任务,让两个版本从同一份代码和提示开始。把改动文件、相关测试和构建结果列入验收,同时记录模型提前停下后需要人工补发几条指令。
- 给常用的数据分析任务加一条容易漏读、但会改变结论的记录,例如按现行业务规则必须排除的一行。验收时检查结论是否正确,并要求输出指出依据在哪一行。
- 用实际请求记录区分未缓存输入、缓存输入和输出,按对应档位结算。把失败任务的调用和重跑一并计入 API 账单,同时记录人工审阅时间,再按验收通过的任务数比较。