OpenAI 发布 GPT-6.2 Astra 与 Sol
据报道,OpenAI 于 11 月 17 日推出 GPT-6.2 Astra 和 Sol,Astra 每百万输入和输出 Token 的标价分别为 8 和 40 美元。发布前流传的部分跑分仍未获证实。
AI 深度解读
GPT-6.2 Astra 和 GPT-6.2 Sol 在 11 月 17 日发布。回头看,泄露截图猜中了型号,传得最广的 89% 跑分却没有公开证据。对写代码的人来说,更实际的变化是 GPT-6.2 Astra 和 Claude Fable 5.2 的输入、输出标价已经相同,真正的价差要看一项工作做成要花多少钱。
原作者用一次发布、几组公开评测和一笔假设账单,讲清了怎么比较模型。最容易带回团队的做法是留一组能自动验收的真实任务,换模型时重跑一遍,同时看通过率和每次成功的成本。
哪些传闻等到了证据?
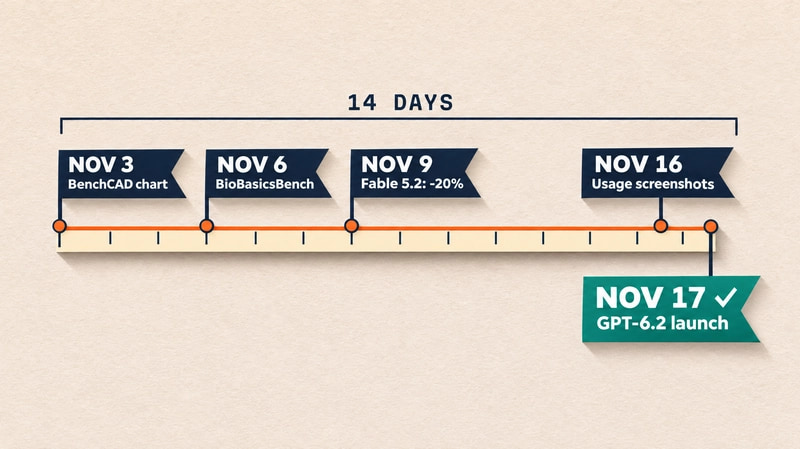
11 月 1 日前后,有用户贴出 Codex 用量页面截图,里面多了 gpt-6.2-astra。11 月 3 日,OpenAI 自己给出了更扎实的线索。BenchCAD 2.0 图表里,一个未命名的内部模型拿到 0.875,当时的 GPT-6 Astra 是 0.594。11 月 16 日汇总的用量截图和云配额条目未经认证,但指向了同一组型号。11 月 17 日,ChatGPT Work、Codex 和 API 上线新模型,API 名称为 gpt-6.2-astra 和 gpt-6.2-sol。
型号猜对了,内部模型的身份仍然空着。正式上线的 GPT-6.2 Astra 在 BenchCAD 2.1 上是 0.825,榜单明确说两个版本的分数无法直接比较。用 0.875 和 0.825 推断模型发布前后退步,缺了同版本测试这个前提。
另一条传闻借用了一个真实数字。11 月 6 日发布的 BioBasicsBench 包含 100 道湿实验数据解读任务,GPT-6 Astra 在 xhigh 推理设置下获得 66.7% 的分数。网传截图把它写成 67%,再附上一行声称 GPT-6.2 Astra 拿到 89%。公开表里只有七个模型,没有 GPT-6.2。Vals AI 的 Science Index 确实把 Astra 排在第一,但那是另一套题。至于来源不明的 Minecraft 风格演示,原作者没有找到可复核的测试条件。
两家旗舰同价,为什么账单还能差三成?
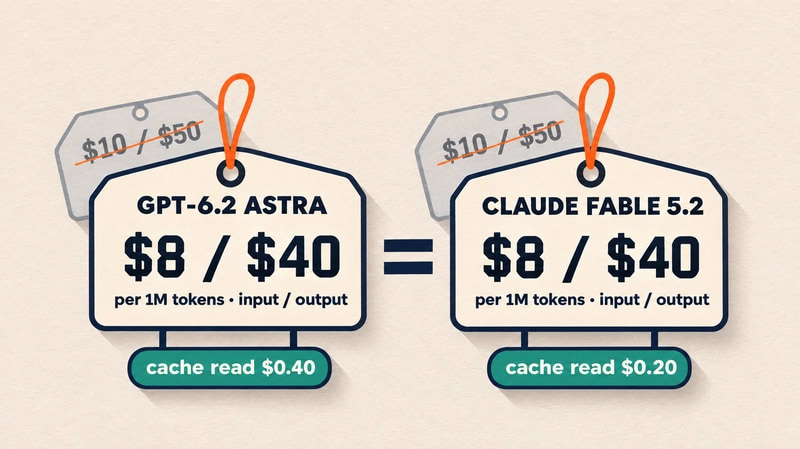
按原文截至 2026 年 11 月 19 日的口径,每百万 token 的价格如下,单位为美元。
| 模型 | 输入 | 缓存读取 | 输出 |
|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $40 |
| Claude Fable 5.2 | $8 | $0.20 | $40 |
| GPT-6 Astra 旧价 | $10 | $1 | $50 |
| Claude Opus 5.5 | $4 | $0.20 | $20 |
| GPT-6.2 Sol 和 Claude Sonnet 5.5 | $2 | $0.10 | $10 |
11 月 9 日,Anthropic 把 Fable 从 $10 / $50 下调 20%。11 月 17 日,OpenAI 跟进同幅降价,缓存读取单价也从 $1 降到 $0.40,降幅 60%。此前有人期待 Astra 做到 $6 / $30、缓存折扣至少 95%。这个愿望只实现了一半,$0.40 相对 $8 刚好便宜 95%,上一代的折扣是 90%。
缓存读取便宜,实际省多少还要算写入。Fable 5.2 的缓存写入按每百万 token 收费,保留 5 分钟是 $10,保留 1 小时是 $16。上下文也有单独的口径。原文援引 Anthropic 文档称,Fable 5.2 的 900K 和 9K token 请求按同一档单价计费。GPT-6.2 Astra 延续 272K 门槛、跨过后整笔请求按更高费率计费,则来自第三方整理,原文未给出官方确认。
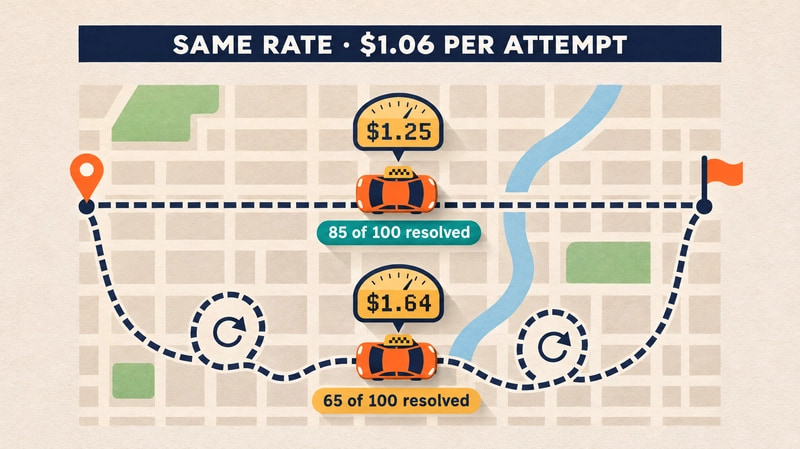
原作者假设处理一张客服工单要调用模型 10 次,每次发送 40,000 个输入 token,其中 90% 命中缓存,再生成 1,500 个输出 token。合起来是 360,000 个缓存输入、40,000 个新输入和 15,000 个输出。按标价算,新 Astra 花 $1.06,旧 Astra 花 $1.51,Fable 5.2 花 $0.99。若把 Fable 的新输入写进 5 分钟缓存,示例账单还要加 $0.08。
把成功率放进去,差距立刻更大。每次尝试都花 $1.06,100 次里做成 85 次和做成 65 次,平均每次成功分别花 $1.25 和 $1.64,后者高约 31%。如果输出增加 60%,从 15,000 涨到 24,000 token,单次尝试就会升到 $1.42,贵约 34%。
每项成功任务的成本等于平均尝试成本除以成功率。
实际评测里也能看出用量差异。OpenAI 的 BioBasicsBench 表中,同一推理设置下 GPT-5.2 每题输出 27,620 token,得分 31.2%,GPT-6 Astra 用 4,704 token 拿到 66.7%。Vals AI 则报告,新 Astra 在其指数里平均每项任务花 $10.68,旧 Astra 花 $21.28。新 Astra 平均输出 91,000 token,在该指数前十名中用量最低。这些结果各有自己的任务集,客服工单那笔账则是用标价推算的例子。
怎么把换模型变成一次可重复的测试?
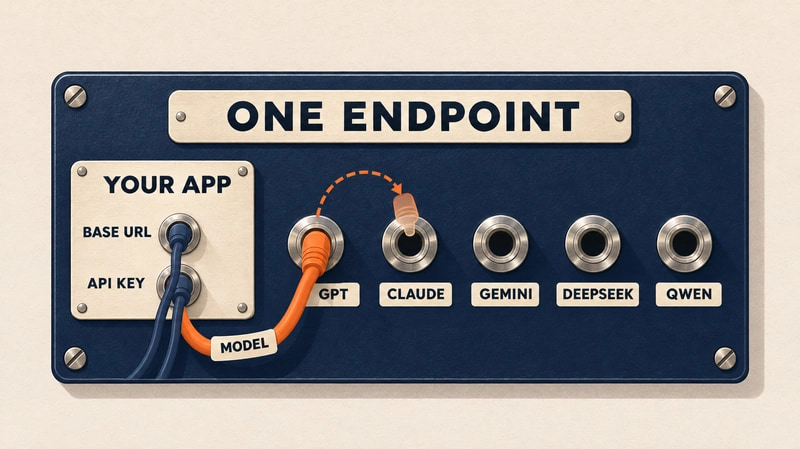
原作者建议把模型名、base URL 和 API key 放进配置,将提示词、工具调用和输出处理的差异集中起来。然后拿 20 到 50 个真实任务,每个任务写一个自动检查。脚本通过 client.chat.completions.create 调用同一个 OpenAI 兼容端点,RUNS = 3,每个案例跑三次。示例从 .env 读取 RELAYROUTER_API_KEY 和 RELAYROUTER_BASE_URL,模型名用的是端点实际接受的 gpt-6.2-astra 和 claude-fable-5-2。
下面这段把每次请求的用量累加起来,再按通过次数摊出成本。
usage = reply.usage
cost += (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1e6
passed += bool(check(reply.choices[0].message.content or ""))
attempts += 1
per_pass = cost / passed if passed else float("inf")
第二行只按输入和输出两档计价,前面算过的缓存写入、缓存命中和长上下文费率都没进来。最后一行应在循环结束后执行,分母为零时用 float("inf") 表示没有成功样本。原文贴出的完整片段还用到了 os.environ 和 os.getenv,但缺少 import os。示例用子串匹配判断金额和情感分类,本来要求只输出一个数字或单词,这种检查连带解释的回答也可能放过。
我的判断
这篇最有用的地方是把「哪个模型最好」落到了团队能重跑的任务上。Artificial Analysis 综合指数里,Astra 拿到 62,高于 Claude Opus 5.5 的 59,低于 Fable 5.2 的 65。Epoch AI 给 Astra 和 Fable 5.2 都打了 174,真实研究任务上却发现 Astra 更弱。BenchCAD 2.1 的自定义运行框架榜上,三者分别是 0.825、0.653 和 0.835,而且各用各家的运行框架。对前端和全栈团队来说,更直接的是 Artificial Analysis 的编程代理指数里,新 Astra 和上一代持平。
OpenAI 报告称,Astra 在 Agents’ Last Exam 上领先 Fable 5.2 约 5.5 分,成本约为对方的 5%,在 Harvey LAB-AA 上的通过率超过两倍,成本约为六分之一。这是厂商在两套特定评测里的报告。Vals AI 把 Astra 排在综合第七,两项法律测试分别排第 11 和第 30。Artificial Analysis 的高难事实题也显示,在最高推理力度下,Astra 和 Sol 分别有 59% 和 55% 的时候选择猜答。这些比例只适用于那组难题,无法拿来估算日常编码中的出错率。
「一个下午接完」是作者的经验判断。原文给了示例脚本,没有提供作者在自家生产任务上的对照结果,也没有测量网关和直连的迁移成本。直连各厂商 SDK,能按各自接口记录用量和工具行为。走网关,接入代码可以少一些,但模型别名、费率和数据处理多了一层。原文的 RelayRouter 段落含推荐返利,是否选它,得看团队实际使用的端点和账单。
能拿来做什么
- 从编程代理处理过的真实需求里选 20 到 50 个案例。前端改动用组件测试或关键交互验收,Node 接口变更用契约测试校验响应。每个案例跑三次,保留失败结果。
- 给每次运行记录模型、端点、输入输出量、可见的缓存用量、重试次数和最终结果。把失败与重试产生的费用也加进总成本,再除以做成的任务数。
- 在 Node 服务里把模型名、base URL 和密钥放进配置,把工具参数和输出校验放在同一处维护。切换前,用生产实际会调用的端点重跑案例,账单按该端点的费率核算。