GPT-6.2 Astra具身任务表现显著提升
据标题介绍,GPT-6.2 Astra在16项具身任务中的成功率较前代翻倍,并声称首次完成某项可变形物体操控任务。素材未提供任务定义、测试条件或接入方式。
AI 深度解读
通用大模型能不能直接指挥机器人,关键不只是理解指令,还要在抓偏、滑落、物体变形后继续完成任务。量子位转述的 XDOF 测试显示,GPT-6.2 Astra 在 16 项真实机器人任务上的平均成功率,从 GPT-6 Astra 的 19.6% 升至 41.2%。
这次结果值得看,因为进步涉及打结、展开 T恤等复杂操作。但成功率翻倍,还不足以证明通用模型已经能替代专用机器人策略。评测口径、控制延迟和缺少的对照,决定了这组成绩该怎么理解。
41.2% 测的是什么,翻倍又说明了什么
XDOF 使用 Ember-0 基准,让双臂机器人完成 16 项任务,覆盖空间推理、抓取、双臂协作、工具使用、精细操作和柔性物体处理。
按原文描述,评测使用六台 YAM 工作站并行运行,每项任务重复 30 次,单日可完成 480 场实测,并由人工标注子步骤、抓取失误与碰撞。重复测试能帮助观察稳定性,但原文没有展开硬件偏差与随机扰动的具体处理方法。
41.2% 是 16 项共享任务成功率的等权平均,相比两个月前的 19.6%,增加了 21.6 个百分点,超过原来的两倍。
平均成功率翻倍是明显进步,但不等于每项任务都翻倍。
原文给出的具体例子是「用夹子夹起面包」,成功率从 10% 升至 90%。此外,GPT-6.2 Astra 完成了此前未被模型攻克的打结和展开 T恤任务。此前累计 143 次有效的 T恤展开测试均未成功,不过原文没有给出新版在这两项任务上的具体成功率,不能把「首次完成」理解为「稳定掌握」。
为什么展开一件 T恤,比抓起杯子难得多
杯子、箱子的形状相对固定,机器人可以围绕较稳定的抓取点和运动轨迹学习操作。衣服和绳子不同:每拉一次,下一步面对的形状就变了。
展开 T恤时,机器人需要持续从腕部和顶部摄像头画面中识别衣角、褶皱和整体状态,再决定两只机械臂怎么配合。抓错一个位置,可能让衣角滑落;拉错一次,可能把之前的进展全部抵消。
这类任务同时考验形变控制、双臂协调、精细操作(Dexterity)和长程规划(Long horizon)。长程规划可以理解为:不能只看眼前这一抓是否成功,还得考虑它会不会妨碍后面的动作。
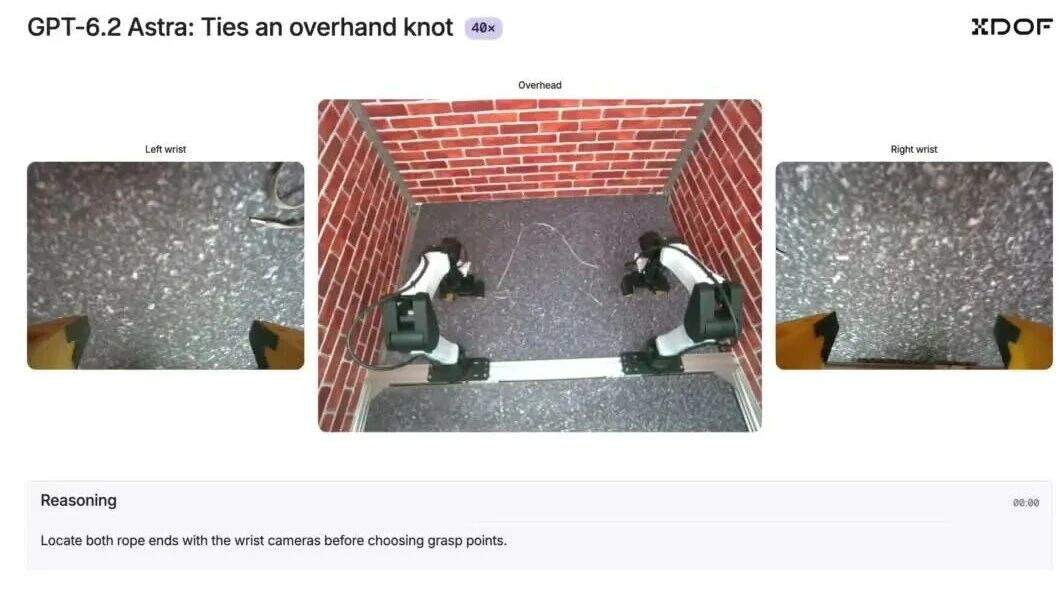
硬件条件进一步放大了难度。原文称,这套系统没有触觉反馈,模型以动作块(Action chunk)输出操作,每个动作块之间存在十余秒到二十余秒的推理等待,期间无法实时微调。
原文另给出平均预测延迟:GPT-6 Astra 为 15 秒,GPT-6.2 Astra 降至 10.1 秒。这与前述动作块等待时间是否采用同一统计口径,文章没有解释。可以确认的是,速度有所改善,但十秒左右的决策等待,距离连续接触控制需要的快速响应仍有距离。
我的判断
我认可这组测试的价值:它把模型放进真实物理环境,用重复试验检查能否完成任务,比展示一次成功视频更有说服力。夹面包从 10% 到 90%,也是比「机器人更聪明了」更具体的证据。
但原文把 Diffusion Policy、ACT、RT-2 等路线放在一起讨论示教数据需求,没有提供它们与 GPT-6.2 Astra 在同一硬件、相同数据和时间预算下的完整对照。因此,不能据此判断通用模型已经全面优于专用策略,也不能推断新版不需要任务适配或示教数据。
同样,RoboColosseum 的 SO-101 Elo 排名第一,是原文转述的另一组结果。文章未交代参赛范围、对局数量和完整协议,它不能直接补足 Ember-0 的对照证据。
这次更有依据的结论是复杂操作能力取得进展,距离稳定部署还有明显差距。
XDOF 认为 Ember-0 可能很快被模型能力饱和,这属于他们对趋势的判断。仅凭当前 41.2% 的平均成功率,还不能确认何时会发生。
能拿来做什么
- 评估日常 AI 编程工具时,可以借鉴「完整任务成功率」的思路:既看中间步骤是否合理,也看最终代码能否运行、需求是否完成,以及失败后能否恢复。
- 比较模型版本时,对同一组任务重复测试,并同时记录成功率与耗时。单次演示和平均分都可能掩盖某类任务持续失败的问题。
- 阅读机器人或 Agent 榜单时,先确认分数是单项成绩、等权平均还是 Elo 排名,再检查硬件、输入条件和测试协议是否一致,避免把不同口径的数字直接比较。