Gemini 4 Neon 发布,提速并降低价格
Google DeepMind 发布 Gemini 4 Neon,据报道其速度接近 Carbon 的两倍,且价格显著更低。多数基准成绩也超过 Carbon,但摘要未提供具体价格、测试条件或编程表现。
AI 深度解读
Gemini 4 Neon 的卖点很直接:按原文给出的评测,它比几周前的旗舰 Carbon 更快,多数项目得分更高,常规价格还更低。但读这条消息,不能只看「新品超过旗舰」。推理档位、促销价格和编程工具环境,都在影响结果。对程序员更有用的,是看懂这些成绩和成本究竟怎么来的。
更快更聪明,为什么还排在 Carbon 下面?
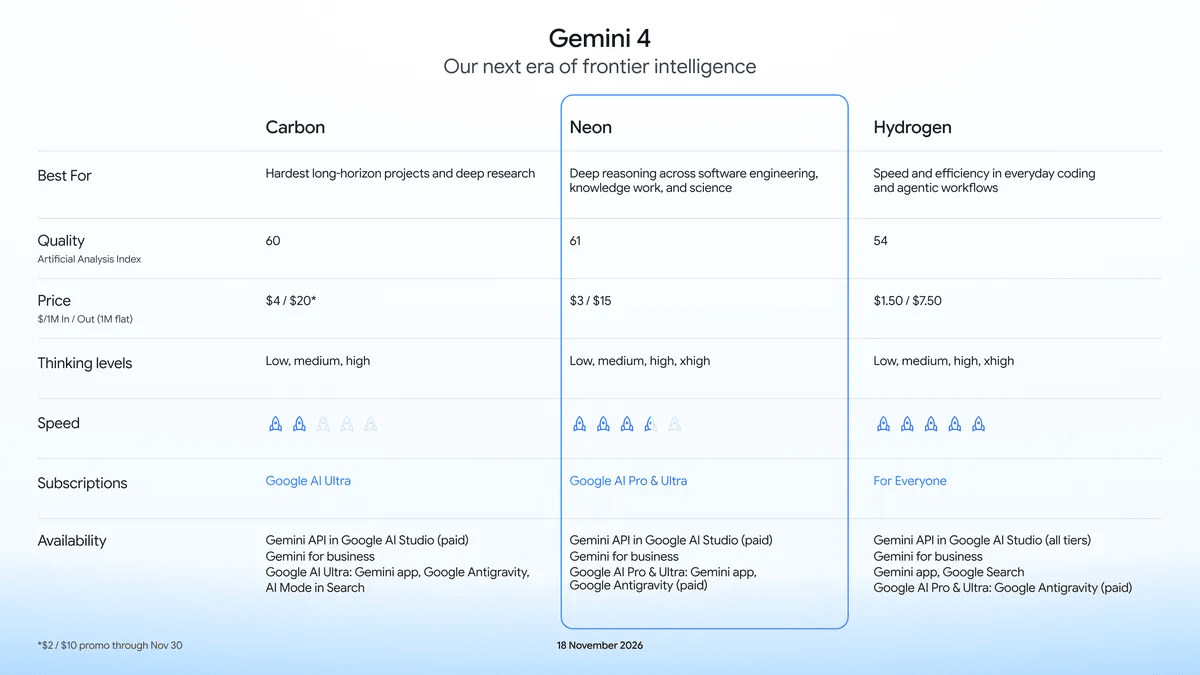
Google DeepMind 在七周内发布了四款模型,Neon 是其中最新一款。它支持文本、图片、音频和视频,提供 100 万 token 上下文窗口,产品定位介于 Hydrogen 与 Carbon 之间。
定位归定位,成绩却出现了倒挂。在 Artificial Analysis 的 Intelligence Index 上,Neon 以最高推理档位 xhigh 拿到 61 分,略高于 Carbon 的 60 分,排名第三。前两名是 GPT-6.2 Astra 和 Claude Fable 5.2。
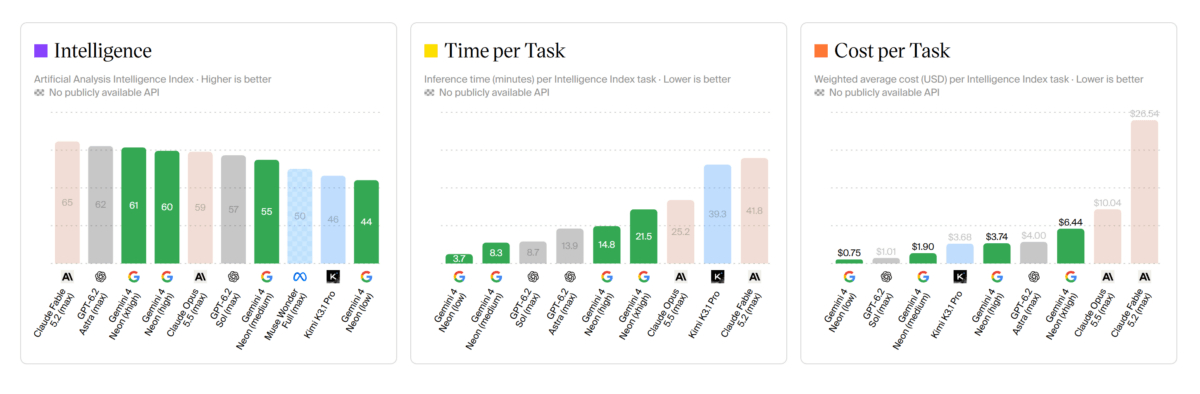
这里要分清两张成绩单:第三方榜单包含领先模型,Google 自己的对比表却只选了 Claude Opus 5.5 和 GPT-6.2 Sol,没有列入上述前两名。
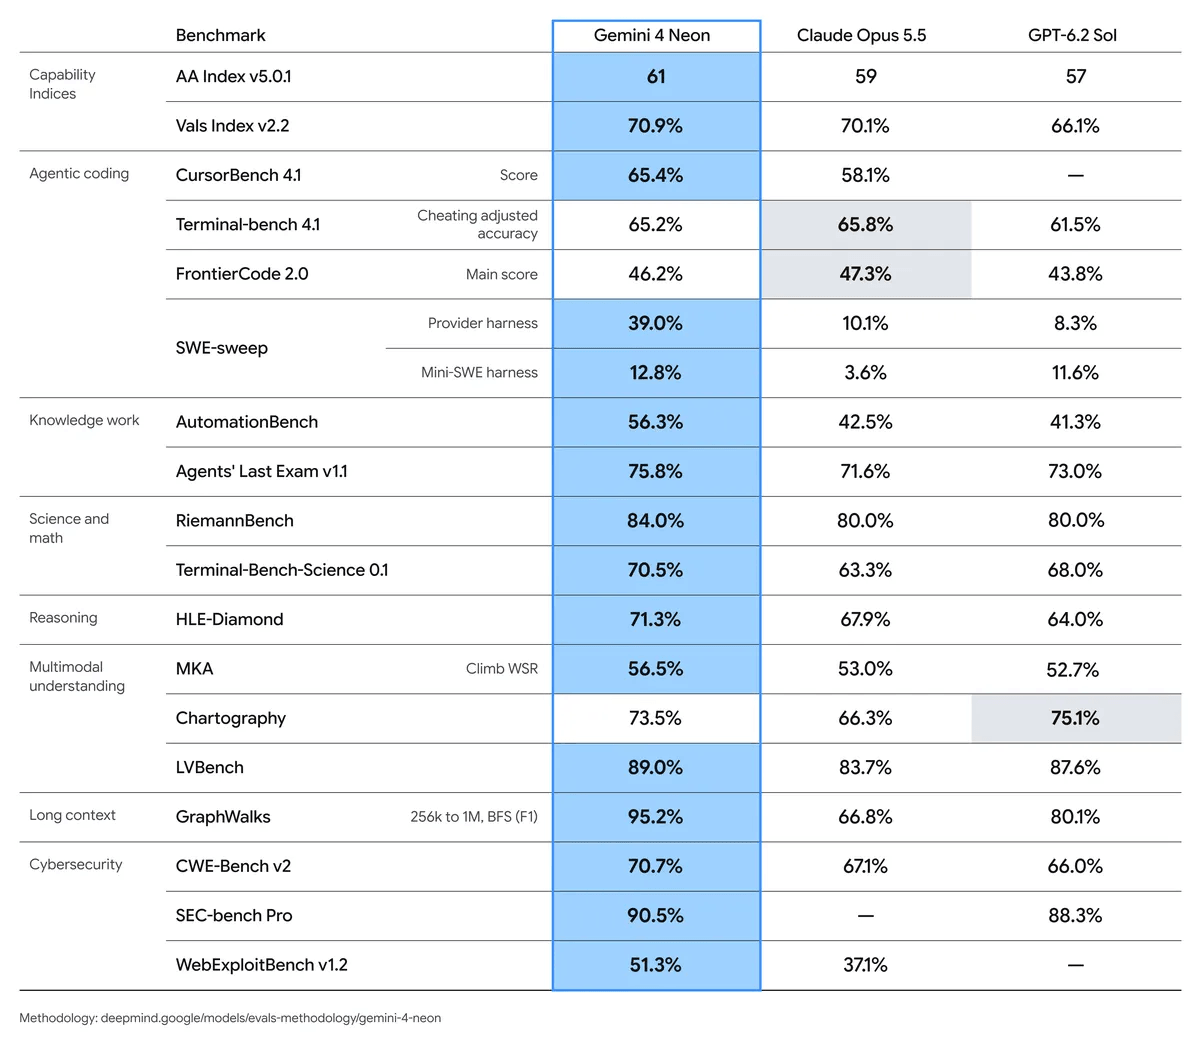
因此,「超过 Carbon」有数据支持,「超过所有竞争对手」则不成立。61 对 60 也只是综合指数上的小幅领先,不能直接推导为每种业务都更好。
便宜来自单价,省钱还得看促销
通过 Google AI Studio 和 Gemini for Business,Neon 每百万输入 token 收费 3 美元,缓存输入为 0.15 美元,每百万输出 token 为 15 美元。Carbon 常规输入、输出价格分别是 4 美元和 20 美元,Neon 比它低 25%。
但 Carbon 的促销价持续到 11 月底。按原文计算,Neon 反而比这个促销价高 50%。准备迁移的人,应该比较账单上的实际价格。
Neon 的成本优势来自更低的常规单价,并非更节省 token。
Artificial Analysis 测得,xhigh 下 Neon 的每任务成本为 6.44 美元,Carbon 按未打折价格计算为 7.76 美元,前者低约 17%。Neon 每任务使用的输出 token 却多约 15%,抵消了部分单价优势。
更值得试的是 high:它能达到 Carbon 的智能指数成绩,同时把每任务成本减半。最高档位并不自动等于最佳选择。
速度提升也有两层数据。Neon 每秒约生成 110 tokens,Carbon 为 57 tokens;整套基准处理时间则从约 36 分钟降至约 21 分钟。生成速度接近翻倍,完整任务耗时并没有减半,实际工作流仍有其他耗时环节。
编程成绩突出,但工具环境也是成绩的一部分
在 Google Antigravity 内运行时,Neon 的 xhigh 在 Coding Agent Index 拿到 59 分,超过 Carbon 的 55 分,也高于 Claude Fable 5.2 和 Claude Opus 5.5 各自的 58 分。
平均编程任务成本分别为:Neon 6.86 美元、Opus 12.61 美元、Fable 15.47 美元。这组结果支持它在该测试中的性价比优势,但不能直接当作你项目里的任务报价。
另一个细节更关键:据 Google 报告,Antigravity 环境让 Neon 在 SWE-sweep 中的命中率提升至原来的三倍,达到 39.0%。
编程 Agent 的表现,需要把模型和运行环境一起评估。
原文没有交代这次环境增益如何拆分。把同一个模型换进另一套编辑器、终端工具或仓库流程,未必还能复现这个数字。
视觉任务同样有亮点,也有反常结果。文档测试 GDP.pdf 中,Neon 的 high 达到最高分 33.4%,领先 Carbon 五个百分点;升到 xhigh 后却降至 28.0%。AA-Briefcase 的演示文稿质量评测中,它以 1771 Elo 领先 Opus 5.5。
Google 自有评测还列出了 Vals Index 部分类别领先、AutomationBench 56.3%、RiemannBench 84.0%。通过 Fairwind Program 提供的网络安全变体,在 SEC-bench Pro 和 WebExploitBench v1.2 分别取得 90.5% 和 51.26%,据称价格为竞争模型的一半。简短的 Model Card 还称,模型在 Gray-Swan 基准中拦截了 100% 的间接提示注入攻击。
这些数字分别对应不同任务和评测范围,不能合并理解为通用可靠性。
我的判断
Neon 最有价值的信号,是推理档位可以成为成本优化的直接旋钮。high 达到 Carbon 的综合成绩、文档测试还超过 xhigh,足以支持「先试合适档位,再考虑拉满」这个选择。
但原文没有提供普通前端仓库、Node 服务或日常修复任务的对照数据,也没有完整展开编程环境和安全测试条件。把榜单优势外推成团队生产力提升,目前证据不足。
与继续使用促销中的 Carbon 相比,Neon 未必立即省钱;与更换整个 Agent 工具相比,只替换模型又未必保留成绩。100 万 token 的窗口是容量描述,Gray-Swan 的 100% 是特定测试结果,两者都需要在实际任务中验证。
能拿来做什么
- 如果正在使用 Carbon,先用自己的输入、缓存和输出用量,分别计算促销期及促销结束后的费用,再决定迁移时间。
- 做 AI 编程对比时,固定仓库、任务和工具权限,分别测试 Neon 的
high、xhigh,记录完成情况、总耗时和实际费用。 - 处理 PDF、截图或演示文稿时,保留一组已知答案的样本,检查
high是否已经足够,尤其验证更高档位有没有改善结果。 - 让 Agent 读取外部文档或网页时,继续保留权限边界和执行确认,不把单项提示注入测试的满分当作撤掉防护的依据。