Gemini 4 Hydrogen性能与成本如何取舍
Google 推出替代 Flash 系列的 Gemini 4 Hydrogen,报道指其部分基准表现超过更昂贵的 Argon,在 Artificial Analysis 智能指数上接近 Claude Sonnet 5.5。其单任务成本约为 GPT-6.1 Sol 的 2.5 倍,智能体编程表现仍有差距。
AI 深度解读
Gemini 4 Hydrogen 把 Google 的模型分工搅乱了:它面向日常编程和 Agent 工作流,综合榜单却超过了体量更大的 Argon。后者发布还不到四周,就面临定位被替代的问题。
但「综合分更高」并不等于「写代码全面更强」。原文真正有用的信息,是独立评测揭示的取舍:Hydrogen 的知识工作表现、幻觉控制和价格值得关注,终端任务却仍有短板;四档推理强度,也需要按任务选择。
超过 Argon,究竟超过了什么
Google 原先把 Gemini 4 Carbon 和 Gemini 4 Argon 定位为处理困难问题、进行长程推理的前沿模型。Hydrogen 则强调速度和成本,准备接替 Gemini 3.8 Flash。
在 Artificial Analysis Intelligence Index 上,Hydrogen 默认 high 档拿到 51 分,高于 Argon 的 50 分;升到 xhigh 后达到 54 分。原文配图中,Claude Sonnet 5.5 和 GPT-6.1 Sol 在各自最高推理档位均为 55 分。
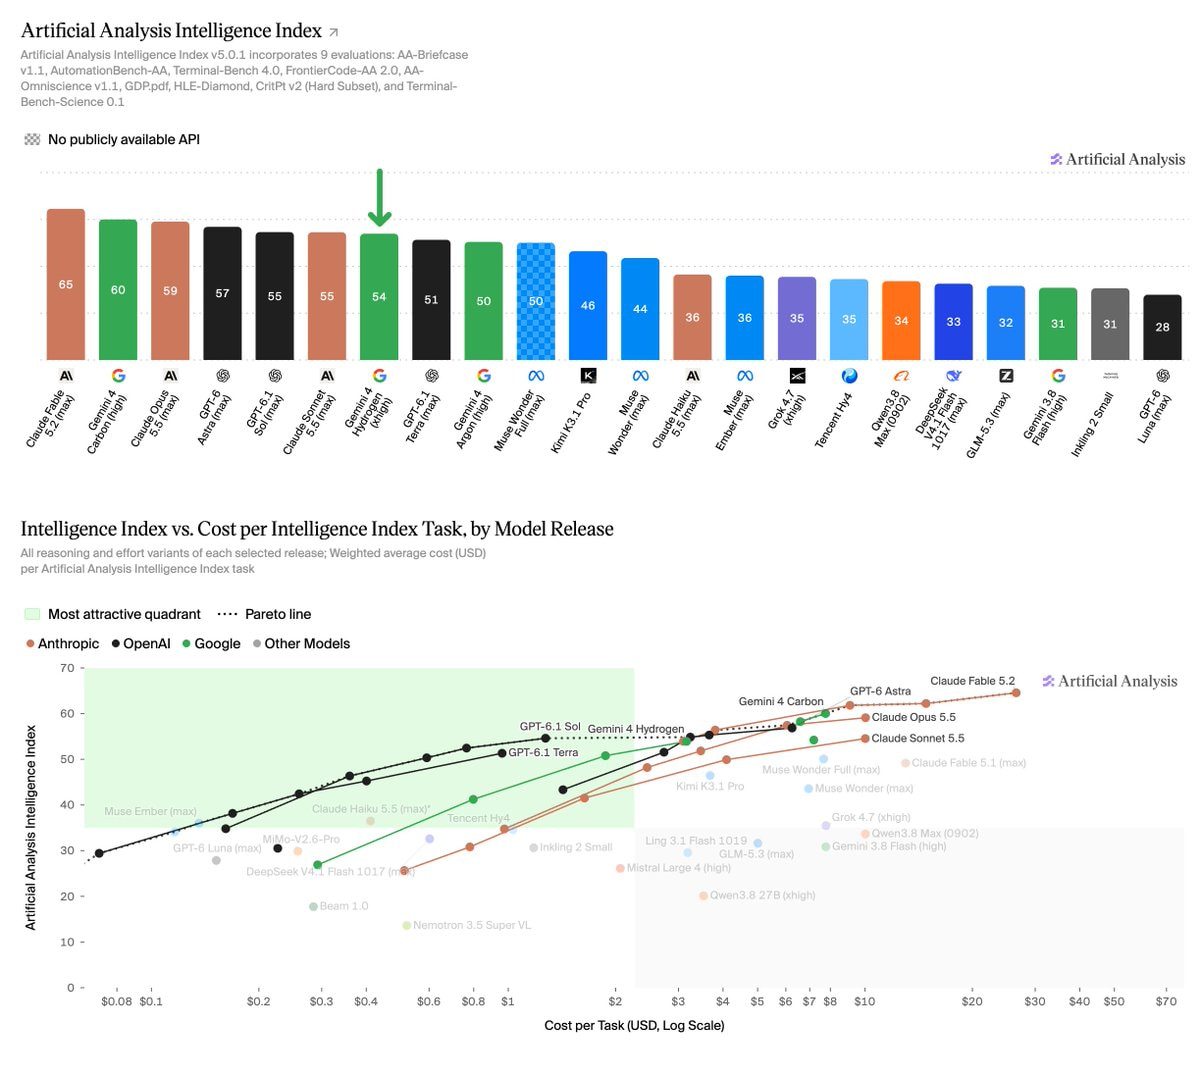
这让产品定位有些尴尬:Google 在两天前发布 Carbon 时,还推荐用 Argon 完成日常编程,现在 Hydrogen 又提供了更高的综合分数和更低的价格。不过,原文没有列出 Argon 的具体价格,无法据此核算节省比例。
综合榜单超过 Argon,是重新评估选型的理由,还不足以证明所有编程任务都该迁移。
原文另一处把 GPT-6.1 Sol 的 xhigh 成绩写为 52 分,与前面的最高档 55 分没有解释清楚口径差异。这两组数字应分别看,不能拼成一张条件统一的排行榜。
四档推理,买的是多少能力和成本
Hydrogen 提供 low、medium、high 和新增的 xhigh,默认是 high;Argon 只有 medium 和 high。
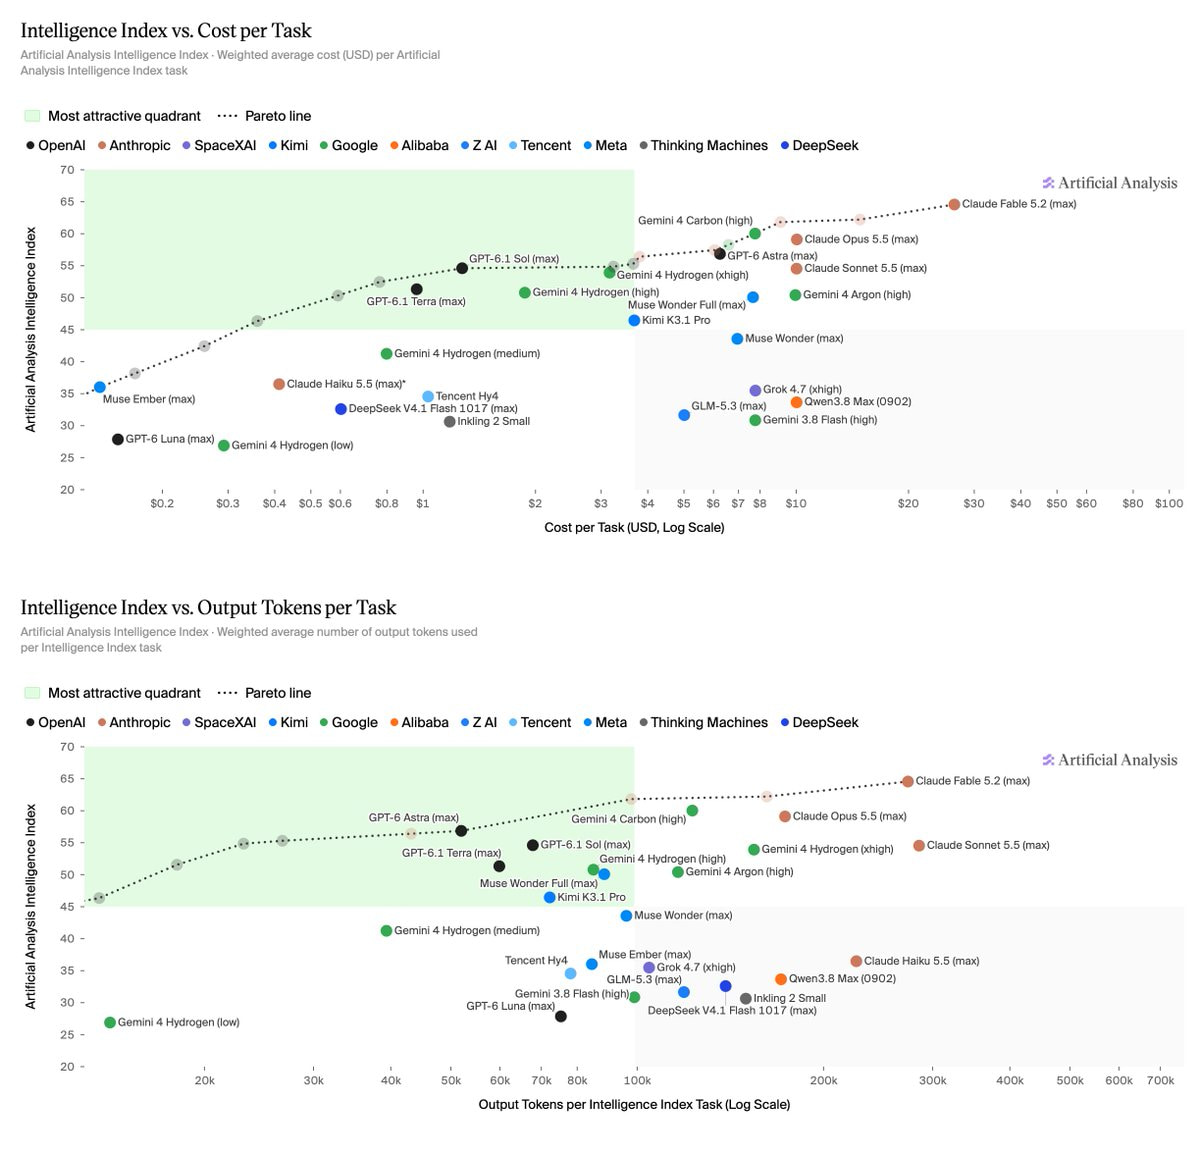
Artificial Analysis 给出的分档结果,比单看最高分更有参考价值:
- low 为 27 分,平均每任务成本 $0.29。
- medium 为 41 分,平均每任务成本 $0.80。
- high 为 51 分,平均每任务成本 $1.87。
- xhigh 为 54 分,平均每任务成本 $3.16。
从 high 升到 xhigh,只增加 3 分,输出 token 却接近翻倍。推理档位不是免费的质量开关,更多推理过程会增加实际支出。
API 标价是每百万输入 token $1.50、每百万输出 token $7.50,缓存命中价格为 $0.075。原文没有进一步交代缓存价格的计量口径。它还支持一百万 token 输入上下文,以及最多一百万 token 输出;容量上限不能直接代表长内容处理质量。
按独立评测的任务成本,xhigh 大约是同等智能水平附近 Claude Sonnet 5.5(max)的三分之一,却约为 GPT-6.1 Sol(max)的 2.5 倍。因此,「更便宜」必须带上比较对象。
Artificial Analysis 还称,high、medium、low 都处于帕累托前沿:在该评测覆盖的候选中,没有其他模型同时比它更便宜、分数又更高。这是特定测试下的性价比位置,不是对全部业务场景的保证。
知识工作表现突出,终端编程仍有差距
Google 宣称,相比 Gemini 3.8 Flash,Hydrogen 在默认推理档位完成任务快 2.5 倍;Terminal-Bench 4.1 从 18.2% 提升至 57%;幻觉减少至原来的五分之一,工具调用失败或搜索无结果后也更容易恢复。这些属于厂商报告,原文没有提供作者自己的复现实验。
知识工作方面,它在覆盖研究、数据分析和代码导航的 Agent Arena 排第五。Google 报告其在 Vals Tax Agent Bench 以 52.3% 排第一,在 Vals Legal Research Bench 以 55.8% 并列第一;Multimodal Knowledge Agent Benchmark 为 53.4%,Agents' Last Exam v1.1 为 71.6%。
独立评测提供了另一组证据:AA-Omniscience 中,Hydrogen 编造答案的比例为 8%;评估 Agent 知识工作的 AA-Briefcase 中,它的呈现质量超过了包括 Carbon 在内的其他 Gemini 模型。但这两个结果都不能直接推导出代码可靠性。
终端任务更能说明限制。在 Terminal-Bench 4.0 和 Terminal-Bench-Science 0.1 上,Hydrogen 分别为 54% 和 50%;Claude Sonnet 5.5(max)为 64% 和 53%,GPT-6.1 Sol(max)为 56% 和 58%。这里的 4.0 与 Google 前面引用的 4.1 是不同版本,分数不能直接比较。
另一个值得关注的做法来自 Google Antigravity:新编排器会在同一会话中动态切换 Carbon 与 Hydrogen。Google 称,在 Terminal-Bench 4.0 上,它接近 Carbon 的成功率,同时减少 24% 的资源使用、缩短 19% 的处理时间。「资源」具体指什么,原文没说清,不能直接当作账单降幅。
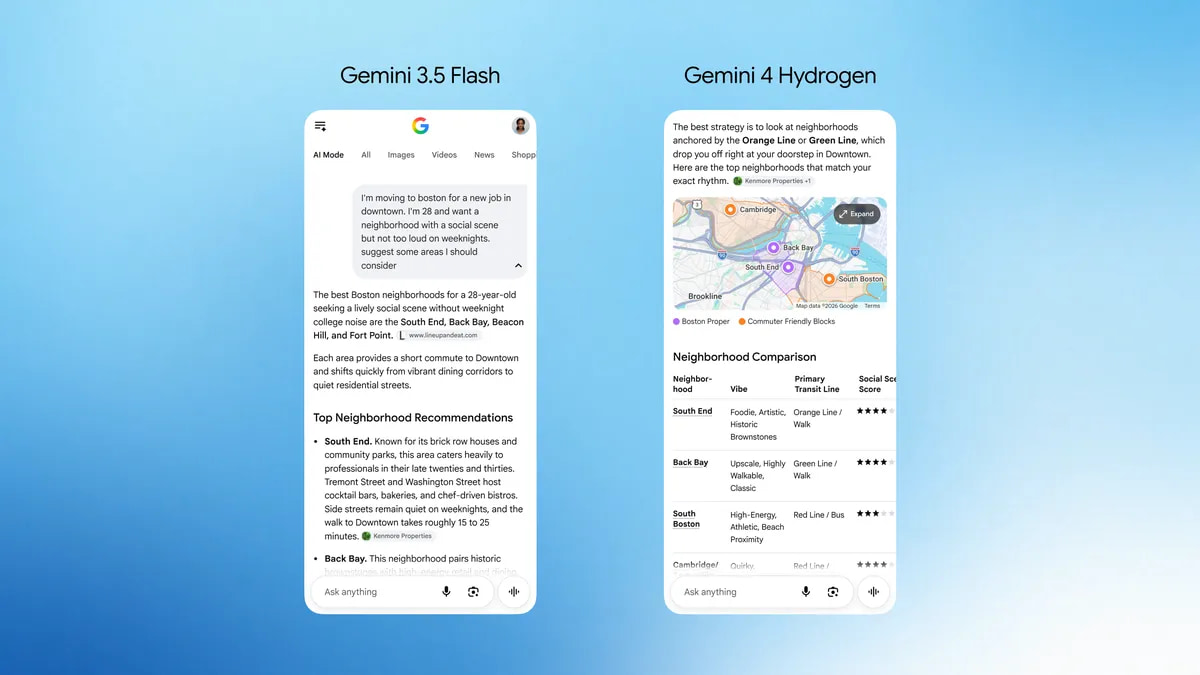
入口已经覆盖 Gemini API、AI Studio、Android Studio、Gemini app 和 Google Search;Antigravity 向付费 Pro、Ultra 用户提供访问,企业入口为 Gemini for Business。Google 还宣称,应用内的长对话更能遵循语气、格式和指令,可接入 Gmail、Drive、Airtable、Dropbox;Search 则改进了错别字、多部分问题和具体请求的处理,并通过 query fan-out 扩展相关链接检索。这些体验改进仍需和独立评测区分。
我的判断
Hydrogen 最有说服力的地方,是综合能力、低编造率和分档成本之间形成了可选择的组合。对于资料研究、文档整理和代码导航,它值得进入候选名单。
但原文标题容易让人把综合排名理解成编程能力排名。独立终端成绩已经表明,Sonnet 和 Sol 各有领先项目。模型能把报告写得清楚,与它能否正确操作终端、修改代码并完成验证,是不同的能力。
团队选型应比较真实任务的通过率、耗时和总费用,不能只比较单价或综合分。
Antigravity 的动态切换提供了有价值的方向,但目前只有 Google 报告的结果,缺少普通团队自建路由的对照数据。它值得验证,尚不能据此承诺相同收益。至于把 xhigh 作为所有任务的默认档,现有成本数据并不支持这种做法。
能拿来做什么
- 为日常 AI 编程准备一组固定任务,覆盖代码导航、修改实现、运行命令和失败恢复,分别记录结果是否可用、总耗时和实际费用,再比较 Hydrogen、Sonnet 与 Sol。
- 从默认 high 开始评估,把 xhigh 留给 high 无法解决的困难任务;对 low、medium 单独验收,确认降档后仍满足要求。
- 处理大型 PDF、表格或视频时,把 Hydrogen 纳入候选,同时核对引用、遗漏和事实错误,避免用一百万 token 容量代替质量验收。
- 在已有 Agent 工作流中试验按任务切换模型,先记录简单步骤与困难步骤各自消耗多少资源,再判断动态编排是否值得引入。