谷歌推出面向分类与路由的决策模型
据素材介绍,Gemini Decision 1 与配套 API 直接对预设候选项评分,返回选择结果、概率及置信度,可用于垃圾识别、文档分类和 Agent 路由。文中称其单次决策延迟为 150–250 毫秒、输入价格为每百万 token 0.10 美元,但候选数量的描述存在不一致。
AI 深度解读
Google 想把一类 AI 任务从「生成答案」改成「给候选答案打分」。据原文,2026 年 11 月 12 日推出的 Gemini Decision 1 配套 Gemini Decisions API,面向垃圾信息识别、任务路由、文档分类等只需要明确判定的场景。
它的吸引力是省掉文本生成过程,直接返回选项、概率和置信度。但原文给出的性能数字缺少测试细节,对批量处理能力的描述也存在歧义。值得看的是这种接口思路,产品结论则需要保留判断。
答案已经列好了,为什么还要让模型写一遍
常见的大模型分类流程,是把输入交给模型,再要求它输出某个标签。即使只要「垃圾信息」或「正常信息」,仍然要经过文本生成,再由程序解析结果。
Gemini Decision 1 采用封闭候选集(closed-set):开发者提供输入、问题和固定选项,模型通过一次前向计算给候选答案评分,返回选中的答案、对应概率和置信度,不逐 token 生成文本。
这里的「前向计算」,可以理解为输入经过模型完成一次计算。原文宣称,候选答案的评分在这一次计算中完成。
它适合答案范围已经确定的任务,价值在于把判定直接做成结构化输出。
例如,系统已经知道有哪些 Agent,只需要决定任务交给谁;文档分类体系已经确定,只需要选择归属类别。它没有试图解决开放式写作或代码生成。
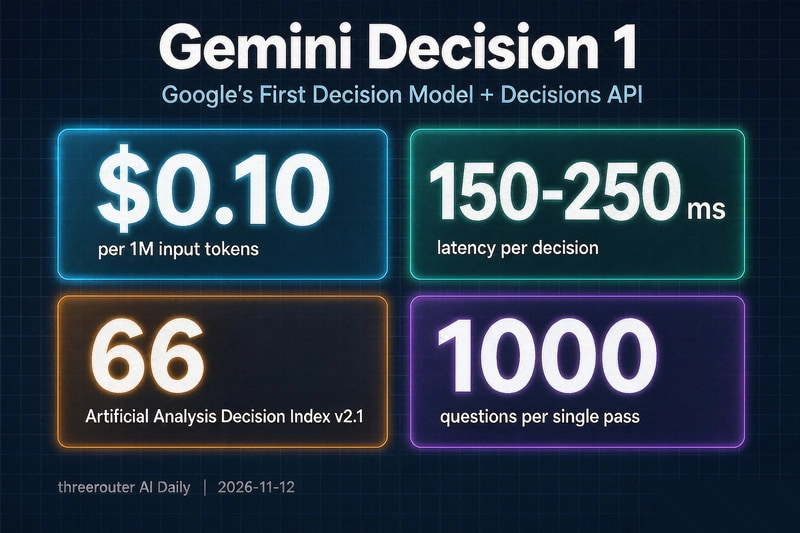
价格和榜单很亮眼,但统计口径还不够清楚
原文列出了几组指标:
- 每 100 万输入 tokens 收费 0.10 美元,输出 tokens 免费。
- 单次判定延迟为 150 至 250 毫秒。
- 成本比 Gemini 3.5 Flash-Lite 低 5 倍。
- 在 Artificial Analysis Decision Index v2.1 上获得 66 分,与 GPT-6 Luna (Max) 的 66 分持平,高于 d1-ultra 的 64 分和 GLiDE v1.2 的 61 分。
- 在 9 类内部基准中,7 类排名第一,最高准确率为 92.2%。
这些数字分别描述价格、延迟和特定测试中的表现,不能合并成「所有分类任务都更好」的结论。尤其是 92.2%,原文只说是最高准确率,没有交代对应哪类任务,也没有提供各类别结果。
批量能力的表述还有一处需要打问号:开头写一次前向计算可评分最多 1000 个候选答案,后面的指标却写一次可评分 1000 个问题,同时又列出最多 255 个多选选项。
「问题数量」和「每题选项数量」是两种不同限制。原文没有解释三者关系,不能据此认定接口支持怎样的批量组合。
我的判断
我认可它针对的问题:当业务只需要一个标签时,直接返回选项和分数,比生成一段文字再解析更贴近程序调用需求。不过,原文没有提供作者自己的调用实验,也没有给出请求示例、错误处理方式和完整测试条件,现阶段只能把它视为产品介绍中的主张。
与通用大模型的结构化输出相比,这种设计有机会省掉生成环节,但原文没有给出同任务、同输入下的直接对照,无法确认实际能省多少时间和成本。对于边界明确的任务,规则或专用分类器也仍然值得比较。
另一个关键缺口是置信度。返回一个分数,不代表分数已经校准到可以直接驱动业务决策。原文没有说明概率与置信度的区别,也没有展示低置信度或输入不属于任何候选类别时的处理方式。
选项范围可控,是这类模型好用的前提;置信度能否用于自动放行,还需要业务数据验证。
能拿来做什么
- 如果正在用 AI 做文档分类或 Agent 路由,可以先整理固定候选项,检查任务是否真的存在明确、稳定的答案范围。
- 在 Node 服务中评估这类接口时,用同一批业务样本比较规则、现有模型和新接口,记录准确率、实际延迟与总费用,避免只看榜单。
- 对可能出现未知类别的输入,先设计拒绝判定或人工复核路径;拿到实际接口后,再验证它是否支持所需的回退机制。
- 接入前先核对官方接口规格,重点确认 1000 个问题、1000 个候选答案和 255 个选项各自指什么,以及概率和置信度如何定义。