同一知识图谱任务对比 ADK 与 Strands
作者用同一多智能体知识图谱流水线比较 Google ADK 与 Strands,分析显式流程结构与模型自主决策两种组织方式。文章还覆盖通过 Terraform 部署到 Amazon Bedrock AgentCore、调用服务及运行结果。
AI 深度解读
Google ADK 和 Strands 都能把多智能体应用跑在 AWS 上,区别主要在于:下一步由代码安排,还是交给模型决定。作者把同一个知识图谱流水线分别用两套框架实现,再把 ADK 版本部署到 Amazon Bedrock AgentCore,比较了编排、调试和部署体验。
这篇最有用的部分,是那些实际踩出来的边界:模型会漏调用工具、误判数据一致性,内存里的会话也有寿命。它能帮助你选框架,也能提醒你把哪些责任留给普通代码。
选框架,先看谁决定下一步
ADK 倾向先定义结构,再把模型放进节点;Strands 倾向先创建能调用工具的 Agent,需要约束时再加入 Graph、Swarm、Workflow 等模式。两者能力有重叠,不能简单理解成一个只能固定执行,一个只能自主行动。
作者使用 ADK 2.12.0。按原文描述,ADK 2.x 推荐用 Workflow 定义图,节点可以是 LLM Agent、Python 函数或工具,边可以带条件。SequentialAgent、ParallelAgent、LoopAgent 仍能运行,但在该版本代码中已标为 deprecated。动态任务则可以通过 ctx.run_node 启动。
判断这些机制,最直接的问题是:控制权交给谁?
AgentTool 和 Strands 的 Agents as tools 都让主 Agent 调用专家,拿到结果后继续掌控流程。ADK 的 transfer_to_agent 会转交控制权;Strands 的 Swarm 则允许 Agent 彼此交接,不依赖中央编排者。
作者的案例把论文摘要转换成实体和「主语 → 谓语 → 宾语」关系:三个提取器并行工作,聚合器合并结果,校验器检查,不通过就返回修改。
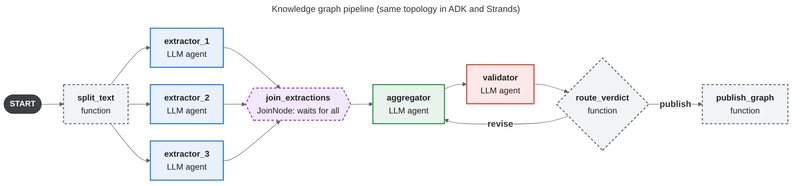
下面的声明把并行分支和返工路径集中在一个地方:
root_agent = Workflow(
    name="kg_pipeline",
    edges=[
        ("START", split_text),
        *[(split_text, extractor, join_extractions) for extractor in extractors],
        (join_extractions, aggregator, validator, route_verdict),
        # 回边:循环至少需要一条带路由的边
        (route_verdict, {"revise": aggregator, "publish": publish_graph}),
    ],
)
重点看最后一条边:是否返工由 route_verdict 路由,关键规则可以落实在代码里。原文还特别限定,Strands Python SDK 的 join 问题不能直接推广到 TypeScript,其 Graph 默认采用 AND 汇合语义。
模型负责提取,代码负责守住数据约束
这组实验最有说服力的结论,是关键约束需要代码兜底。
一次运行中,Nova 2 Lite 给出 consistent: true,但关系引用的实体中,有 4 个根本不在实体列表里。route_verdict 用代码查出问题,要求聚合器修订,第二次才修正。
类似问题还出现在发布节点:让 LLM 复制最终 JSON,会损坏图数据;改成函数后,输出确定,也不再消耗模型 token。别名合并也一样,Nova 2 Lite 曾建议把 deep learning 与 ai research、mila 与 montreal 合并。作者最后让代码先生成候选对,模型只负责确认或否决。
工具调用还有另一种陷阱。ADK 允许 output_schema 与 tools 同时使用,但作者通过 LiteLLM 调用 Nova 时,模型直接返回 JSON,没有调用工具。LiteLlm 声明支持两者组合,并不保证模型一定按业务预期使用。需要工具取数的节点,可以和结构化输出节点分开。
长文版本 kg_pipeline_docs 进一步暴露了失败处理问题:模型空响应会以 None 返回,没有异常。作者将 None 当作失败,重试一次,仍失败就记录对应片段,避免静默丢失。
几个数字也需要连同条件一起看:
- 同一摘要上,Nova Pro 提取 30 条关系,Nova 2 Lite 提取 44 条,前者还产生更多复合实体。
- 片段从 350 词缩到 150 词,关系数量增加 24%,模型调用次数达到原来的 2.5 倍。
- 本地先输入摘要、再输入引言,累计关系从 5 条增加到 32 条。
这些是案例结果。关系更多是否更准确,原文没有给出足够对照,不能据此认定某个模型全面更好。
调试方便,但会话规则得自己弄明白
ADK Python 的工具是带类型标注和 docstring 的普通函数,框架自动包装为 FunctionTool,没有 @tool 装饰器。最小项目需要 agent.py 定义 root_agent;原文要求 Python 3.12 或以上,通过 pip install google-adk 安装。
接 Bedrock 需要 google-adk[extensions],模型可以配置成 LiteLlm(model="bedrock/us.amazon.nova-2-lite-v1:0")。但模型可替换,不代表内置工具都可替换:google_search 和 BuiltInCodeExecutor 依赖 Gemini。
会话则比 Strands 的 agent("...") 更显式。create_session 必须 await;Runner 用 run_async 执行后,还要重新 get_session,因为 InMemorySessionService 返回的是 deepcopy,旧变量的 session.state 不会自动更新。
state 的键名也有语义:无前缀属于当前会话,user: 跨用户的多个会话,app: 属于应用,temp: 只保留到本次调用结束。但 InMemorySessionService 仍然只存进程内存;需要重启后保留,就得换 DatabaseSessionService 等持久化实现。
作者最看重的是 adk web。它默认运行在 http://localhost:8000,能查看图、state、事件和调用轨迹。
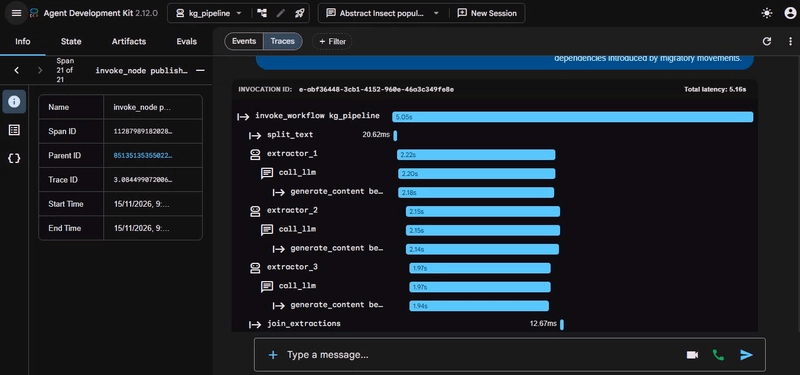
热运行时,三个提取器各约 2 秒,完整流程约 5 秒;进程首次运行时,初始化 Bedrock 客户端、凭据和 TLS 连接,会让另外两个提取器等待约 7 秒。动态 ctx.run_node 并行不会完整画进图里,仍要看 traces。
adk web 默认监听 127.0.0.1,仅用于开发;生产使用 adk api_server 或自建服务。作者在 Strands 文档中没找到对应的本地界面,其观测方式是导出 OpenTelemetry traces。两者都有评估机制,但作者只报告了 ADK 案例通过,没有提供统一测试集上的胜负结果。
部署到 AWS,先算清会话能活多久
作者部署的是长文版本:少量用户逐段粘贴论文,每次请求约 5 至 20 秒,希望工作期间持续累积图谱,因此选择 AgentCore Runtime。
接法是把 context.session_id,也就是 AgentCore 的 runtimeSessionId,直接作为 ADK session_id。按作者方案,每个会话运行在独立 microVM 中,InMemorySessionService 随它保留,后续请求就能继续读取图谱。
部署采用 S3 zip,包约 72 MB,低于 250 MB 限制,不需要 Docker;Terraform 配置包含私有版本化 S3 bucket、IAM role 和 Runtime。下面这段决定了运行环境和会话寿命:
resource "aws_bedrockagentcore_agent_runtime" "agent" {
  agent_runtime_name = "kg_pipeline_docs"
  role_arn           = aws_iam_role.runtime.arn

  agent_runtime_artifact {
    code_configuration {
      entry_point = ["opentelemetry-instrument", "agentcore_app.py"]
      runtime     = "PYTHON_3_13"
      code {
        s3 {
          bucket     = aws_s3_bucket.code.id
          prefix     = aws_s3_object.package.key
          version_id = aws_s3_object.package.version_id # 新 zip 版本会更新 runtime
        }
      }
    }
  }

  environment_variables = {
    MODEL_PROVIDER   = "bedrock"
    BEDROCK_MODEL_ID = var.bedrock_model_id
    AWS_REGION_NAME  = var.region # LiteLLM 调用 Bedrock 时读取
    # 统一遥测:span 写入 runtime 日志组的 spans 流,需要 ADOT >= 0.18
    UNIFIED_TRACES_DESTINATION_ENABLED = "true"
  }

  lifecycle_configuration {
    idle_runtime_session_timeout = 900  # 无活动 15 分钟
    max_lifetime                 = 3600 # 最长 1 小时
  }

  network_configuration {
    network_mode = "PUBLIC"
  }
}
重点看 900 和 3600:图谱只在这段会话生命期内保留,不能当成长期存储。
AWS provider 要求 ~> 6.22。资源从 6.17 起存在,但 zip 所需的 code_configuration 到 6.22 才加入。依赖还要面向 Linux arm64 安装,使用 pip install --platform manylinux2014_aarch64 --only-binary=:all:;Windows 生成的 .exe 启动脚本需要重新生成 Linux launcher。
这次测试使用 PUBLIC,作者没有验证 VPC。IAM 限制读取指定 zip、调用 Nova 2 Lite,但 X-Ray 和 PutMetricData 仍有通配资源权限,不能称为绝对最小权限。调用方还需要 bedrock-agentcore:InvokeAgentRuntime。
我的判断
ADK 的吸引力在于复杂流程集中表达,以及调试时能直接看到执行过程。对于需要并行、返工、确定性校验的任务,这比继续往提示词里追加规则更容易审查。
Strands 则适合先用少量代码启动工具型 Agent,AWS 集成和会话管理也更顺手。原文没有给出两者开发工时、吞吐量或成本的统一对照,框架取舍仍是作者的实践判断。
还有一个比较边界:Strands 版本只在本地测试,AgentCore 部署能力来自文档;实际部署验证仅覆盖 ADK。所提供原文末尾也已截断,没有完整成本结果,不能替作者补出成本优势。
能拿来做什么
- 做文档提取或知识图谱时,把实体引用、必填字段和发布输出交给代码校验,并为 None 响应保留重试与失败记录。
- 评估框架时,用同一份输入比较工具是否调用、失败能否定位、返工能否收敛,再看关系数量和 token 消耗。
- 前端联调 ADK 服务时,把 session_id 当作明确的接口约定,并提示会话过期;需要长期保存的结果应另行持久化。
- 部署前核对 AWS provider、arm64 依赖和入口脚本,分别测量首次调用与后续调用,避免用热运行的 5 秒估算所有请求。