GKE 工作空间支持 GPU 状态暂停恢复
GKE Workspaces 基于开源 Kubeflow Workspaces,在自有集群中提供 JupyterLab、浏览器版 VS Code 和加速器资源。暂停功能通过快照保留内存变量及 GPU 模型状态并释放硬件,同时支持 TPU 与编程 Agent 沙箱接入。
AI 深度解读
GKE Workspaces 想解决一个很具体的问题:GPU、TPU 在团队的 Kubernetes 集群里,研究人员却不该为了跑 Notebook,先学会申请机器、挂载磁盘和配置集群访问。Google 在 2026 年 11 月 4 日公布的方案,是把这些操作收进一个网页开发入口。
它更值得关注的地方,是连内存状态和并行编程 Agent 也一起搬进了集群。研究人员少管基础设施,平台团队则接手快照、容量和沙箱策略。判断这套方案是否适合自己,需要把便利和运维责任一起看。
选好 IDE 和机器就能开工,前提是谁把选项准备好
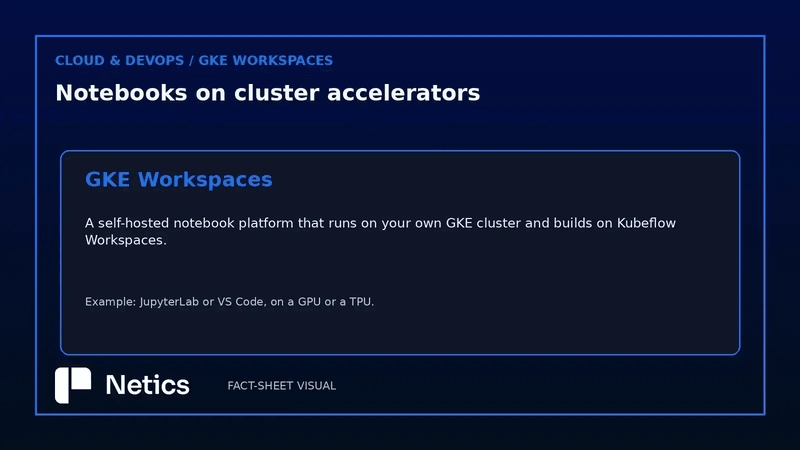
GKE Workspaces 是部署在团队自有 Google Kubernetes Engine 集群上的 AI/ML 开发平台,建立在开源 Kubeflow Workspaces 之上。这里的「自托管」有个明确边界:团队先有 GKE 集群,再把平台部署上去。
Google Open Source Blog 的公告由 Siyuan Zhang 和 Antonio Ojea 发布。按公告描述,平台可以独立运行,不依赖 Istio,集成了身份验证令牌流程,并增加 CPU、GPU 有状态暂停与恢复能力。两个项目都采用 Apache 2.0 许可证,Google 表示正与 Kubeflow 社区合作,将新增能力贡献回上游。
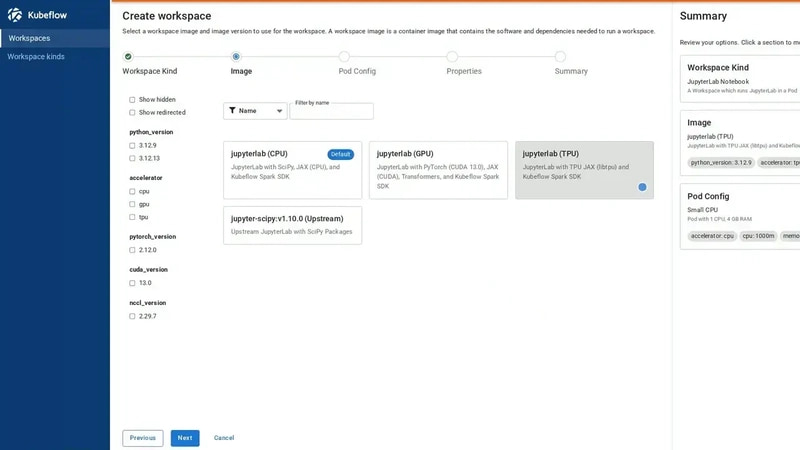
研究人员登录网页后,依次选择 IDE、环境、硬件规格,再启动工作空间。IDE 可以是 JupyterLab 或浏览器里的 VS Code,硬件选项包括 Small CPU、GPU 和 TPU。用户不用打开云控制台,也不用编写 YAML。
这份简单来自管理员提前完成的配置:哪些镜像获准使用,哪些机器和预留容量对应哪个规格,使用 on-demand 还是 Spot,都由平台团队决定。研究人员看到的是已经准备好的组合。
文件持久化也被封装起来。每个工作空间的 home 目录挂载一块专属、加密的 Persistent Disk,位于团队自己的项目中。按原文描述,文件、Notebook 和安装的包可以跨重启、暂停及机器切换保留。
自助开发入口能否省事,取决于平台团队能否把可用环境提前做成稳定选项。
暂停保留的不只是文件,还有 GPU 里的模型
普通 Notebook 文件不会保存进程内存。磁盘上的代码还在,不代表变量、运行到一半的交互状态,以及已经装进 GPU 的模型还在。
原文举的场景是:研究人员花了一个小时加载模型,结束工作时,要么关闭机器并承担下次重新加载的时间,要么让昂贵的加速器空转过夜。
GKE Workspaces 的暂停功能基于 Pod Snapshots。按公告描述,它会保存运行中 Notebook 的状态,包括内存变量和 GPU 中已加载的模型,将快照写入 Cloud Storage,然后释放硬件;工作空间也可以在闲置一段时间后自动暂停。
这里有两套不同的保存机制:Persistent Disk 留住文件,Pod Snapshots 留住运行状态。后者才是这项功能对交互式 ML 开发的主要吸引力。
但公告没有给出大型 GPU 快照的恢复耗时,也没有交代保留期限。作者提出,每天暂停二十个工作空间的团队,最好在第一张账单到来前就确定清理策略。这个数字是用来说明管理压力的假设场景,不是实测规模。
快照还可能包含敏感数据。生产数据如果进入过内存,保存内存状态就可能额外产生一份需要管理的数据副本。谁能读取、何时删除、放在哪个区域,都不能由一个暂停按钮代替决策。
暂停释放了计算硬件,但 Persistent Disk、Cloud Storage 快照和控制平面仍然有成本。
TPU 的接入则解决另一种中断:实验规模扩大时,被迫更换工具。原文描述,研究人员可以在同一个 Notebook 中使用 JAX 或 PyTorch,从单颗 TPU 芯片开始,切换更大的硬件规格使用单机多芯片,再将同一个训练函数提交给 multi-host TPU slice。日志回传到 Notebook,任务结束后释放 TPU。
这能减少切换工具造成的实验偏差,却不能保证训练天然可复现,也不能保证点选后就有容量。配额、容量和预留资源仍由平台团队负责。
Agent 接上远程算力以后,权限边界更重要了
GKE Workspaces 也为本地 coding agent 提供远程执行入口。用户从网页生成一个短期有效、可以撤销的链接,让 Notebook 和 Agent 生成的代码在远程 GPU 或 TPU 上运行。
流量通过 HTTPS,经过 Google Identity-Aware Proxy 和集群访问代理,每次请求都会检查权限。按公告描述,笔记本电脑无需保存 SSH 密钥、本地隧道或集群凭据。
这个设计减少了开发机长期持有集群凭据的需要。原文拿常见的长期 kubeconfig 分发方式作比较,指出凭据留在电脑上,也就多了一个可能泄漏的位置。
不过,短期链接解决不了全部权限问题。代理校验的是生成链接的用户权限,原文没有讲清链接究竟限制到 namespace、service account,还是更大的集群范围。允许 Agent 执行代码之前,团队仍需确认它能读什么、能访问哪里。
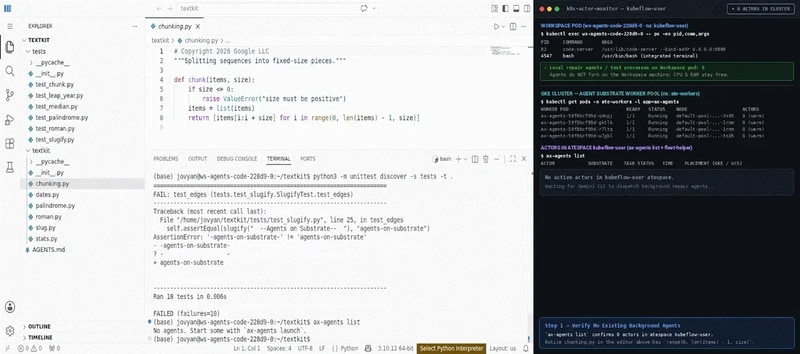
并行子 Agent 又把问题推远了一步。通过 Agent Substrate 等提供方,主 Agent 可以把修复仓库中失败测试之类的任务分给后台子 Agent。它们运行在集群内的轻量沙箱中,共享集群节点、独立执行,用户退出后仍能继续工作,最终返回供审查的补丁。
原文称,沙箱闲置时可以快照到 Cloud Storage,计算成本为零。这里仍要区分计算与存储:快照保留下来,并不代表整个任务没有后续费用。
平台描述了隔离沙箱,却没有展开沙箱能访问哪些网络、数据和服务。并行任务越容易启动,平台越需要明确并发量、资源额度和访问范围。
我的判断
我认同它把常用环境、身份验证和算力入口收在一起的方向。对于已经运行 GKE、拥有共享加速器池的 ML 团队,这有机会减少研究人员与平台团队之间反复申请环境的沟通。
但它的收益有很强的组织前提。没有现成集群,也没有人负责容量规划的团队,不能把这套自托管平台当成开箱即用的托管 Notebook。Apache 2.0 说明了许可证条件,无法回答部署、升级和日常维护要投入多少人力。
与只持久化文件、启动后重新加载模型的做法相比,运行状态快照用更多存储和生命周期管理,换取恢复交互现场的可能性。是否划算,取决于模型加载时间、快照大小、恢复速度和实际账单。原文没有对照数据,也没有作者实测的性能结果,不能据此认定它一定更快或更省钱。
同样,「同一个 Notebook 扩展到多主机 TPU」和「并行 Agent 返回补丁」都是公告描述的工作流,不能据此推导训练扩展效率或补丁质量。
多租户隔离也需要进一步核实。原文说平台支持 GKE Standard 和 Autopilot,使用 Google 账号登录、Google-managed certificates 加密流量,并隔离不同团队的工作,但没有展开隔离机制。严格的数据驻留要求、团队间的访问边界,以及 GPU 争用时谁优先,都还需要运营方给出答案。
能拿来做什么
- 如果团队已有 GKE 和 GPU/TPU,可以先选一个反复加载模型的 Notebook 做验证,记录首次启动、暂停、恢复耗时及存储增量,再判断状态快照是否值得引入。
- 如果日常用本地 coding agent 操作远程 ML 环境,可以评估短期、可撤销链接的接入方式,同时核实授权范围与撤销效果,减少长期分发 kubeconfig 的需要。
- 如果准备让 Agent 并行修复仓库测试,先明确沙箱的网络访问、数据权限、资源额度和并发上限,并保留补丁审查环节。
- 如果负责平台运维,应把 home 磁盘和运行状态快照分别管理,提前确定 Cloud Storage 的归属、保留期限、清理策略与恢复责任。