Copilot Fusion 增加模型并公开跑分
GitHub 扩充了 Copilot Fusion 的模型选择和使用入口,并公布了它在两个公开 Terminal-Bench 榜单上的成绩。
AI 深度解读
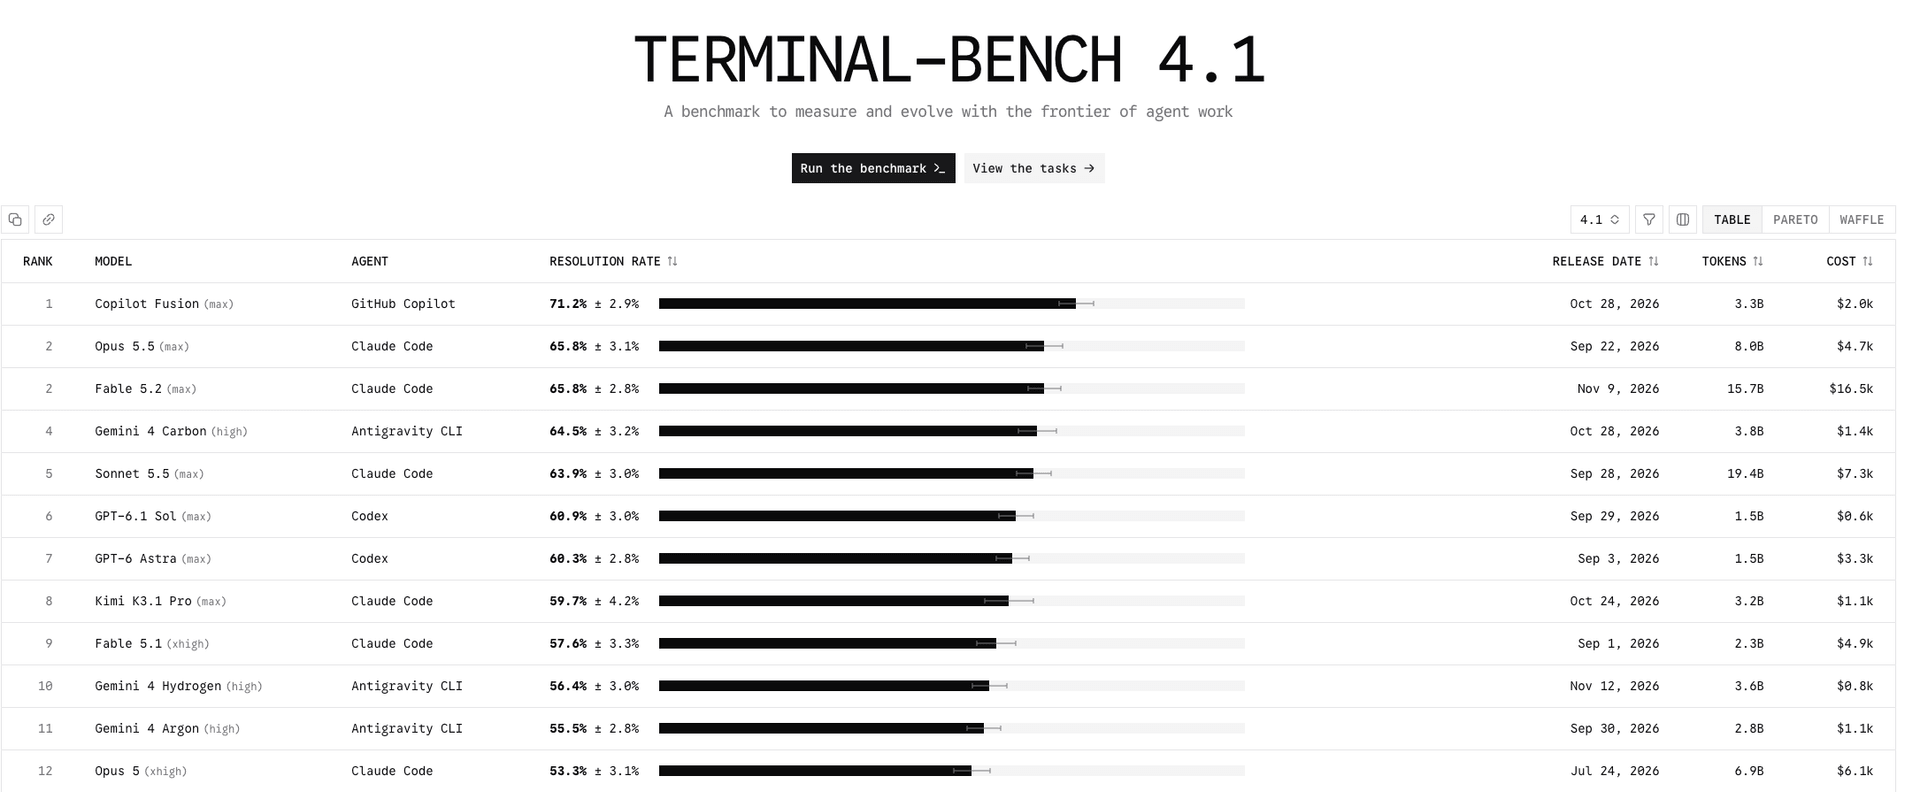
GitHub Copilot Fusion 这次更新带来两件事。它能在更多 Copilot 入口里使用,三个档位也各加入了一个模型。同时,Fusion Max 在公开的 Terminal-Bench 4.1 榜单上交出了 71.2% 的任务解决率,公告给出的成本也低于两个对比模型。
对日常用 AI 写代码的人,这组成绩最适合用来决定要不要试。终端任务与跑构建、排查测试失败这些工作有交集,但榜单上的优势能不能带到你的项目里,还得拿仓库里的实际任务验证。
Fusion 把逐次选模型变成了选档位
在 Copilot 的模型选择器里选中 Copilot Fusion,再设置投入档位(effort level),Copilot 就会按任务选择并协调模型。你仍然决定用哪个档位,具体任务交给哪个模型由 Fusion 处理。
这次三个档位各新增一个模型。Copilot Fusion Max 加入 Claude Sonnet 5.5,Copilot Fusion High 加入 GPT-6.1 Terra,Copilot Fusion Standard 加入 MAI-Code-2。公告没有说明每个模型会在什么任务上被选中,因此单看新增名单,推不出某次任务实际用了哪个模型。
入口方面,公告列出的可选范围是最新版 github.com、Visual Studio,以及 iOS 和 Android 的 GitHub Mobile beta。GitHub Mobile 正式版支持即将推出,公告没有给出具体日期。
71.2% 的解决率能说明什么
Terminal-Bench 4.1 让 AI 智能体在终端里完成有一定难度、贴近实际工作的任务。公开榜单由 Stanford、Harbor 和 Laude Institute 托管。参评智能体面对同一批任务和同一套评估规则,所以结果可以横向比较。
Fusion Max 的任务解决率是 71.2%,比 Opus 5.5 和 Fable 5.2 高 5.4 个百分点。按公告给出的成本对比,Fusion Max 比 Fable 5.2 低 88%,比 Opus 5.5 低 57%。公告开头提到两个公开榜单,但正文只展开了 Terminal-Bench 4.1 的这组结果。
我的判断
公开跑分提供了一组可比较的结果,适合用来筛选值得试用的方案。它离团队采购或日常选型还有一步。公告没有交代成本的具体计算口径,也没有给出同一套 Fusion 分别用 Max、High、Standard 跑出的对照成绩。仅凭这组数字,算不出团队能省多少,也判断不了日常任务升到 Max 会多解决多少问题。
和手动固定一个模型相比,Fusion 省去了每次派活前选模型的操作。固定模型则更方便做重复对照,比如同一个测试失败交给两套配置处理,看它们能否在相同条件下独立定位并修复。Fusion 这次的跑分给了试用理由,自动选模型在自家仓库里能省多少人工接手,公告没有给出数据。
能拿来做什么
- 从最近修过的 Node 构建失败或前端测试失败里挑几例,让 Fusion 和当前常用的固定模型分别处理。给它们相同的起始提交和任务描述,用复现命令与测试结果验收。
- 如果主要想判断要不要上 Max,可以让 Standard、High 和 Max 做同一批任务,记录完成率、耗时和人工接手次数。有可比的成本记录时,再算每个成功任务花了多少。
- 如果习惯在手机上使用 Copilot,按公告所列范围,从 iOS 或 Android 的 GitHub Mobile beta 模型选择器里找 Fusion。正式版的可用时间仍待公布。