谷歌新决策API支持千项多模态判断
谷歌推出由 Gemini Decision 1 驱动的 Decisions API,面向工具选择、策略检查和模型路由等任务,可对同份多模态输入回答最多1000个独立问题。公布的延迟为150至250毫秒,支持最多256K输入 Tokens,输入每百万 Tokens 收费0.10美元且输出免费。
AI 深度解读
Google 推出的 Gemini Decisions API,瞄准的是 AI 应用里一类很具体的工作:给定同一份材料,快速完成一批判断。它由 Gemini Decision 1 驱动,一次处理最多支持 1000 个独立问题,并返回候选选项的概率和置信度分数。
对做 AI 编程和应用集成的开发者,这条消息的价值在于工具选择、模型路由、策略检查这些环节可能多了一种专用方案。不过,报道给出的速度和价格,还不足以证明它在实际业务里更划算。
一份材料问 1000 个问题,适合解决什么
据 IT之家 11 月 12 日报道,Google 于前一日宣布推出 Gemini Decisions API。它支持是非判断、选项选择和标准评估,面向工具选择、策略检查、模型路由、上下文质量评估等任务。
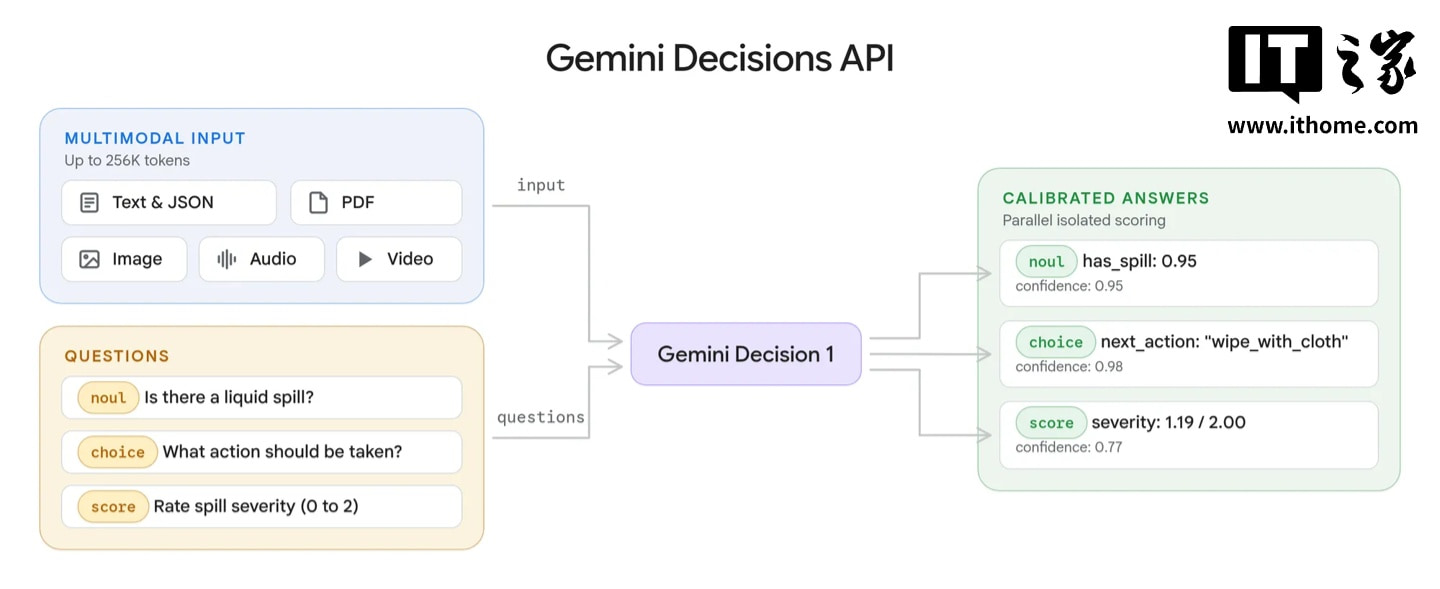
开发者可以提交一份多模态内容,输入上限为 256K Tokens,再针对这份材料提出最多 1000 个相互独立的问题。
这里最关键的限制是「相互独立」。例如,判断一份材料是否包含指定信息、是否符合某项标准,可以分别提问;如果后一个问题必须依赖前一个问题的答案,就不能直接把整条决策链当成一批独立问题。
它的定位是对材料做批量判断,而报道没有展示开放式生成或连续推理的能力。
150 至 250 毫秒,具体快在哪里
报道介绍,Gemini Decision 1 通过一次前向计算对候选选项进行评分,并返回概率和置信度分数。前向计算可以理解为:模型处理输入后,直接算出候选项的分数。
报道给出的处理延迟是 150 至 250 毫秒。输入价格为每 100 万 Tokens 0.10 美元,按原文所附汇率约合 0.67 元人民币,输出 Tokens 不收费。
这组数字很吸引人,但测试条件没有交代:输入有多长、包含什么模态、提出多少个问题,以及延迟是否包含网络传输,都没有说清。不能据此认定,塞满 256K Tokens、问足 1000 个问题,也一定能在这个时间范围内完成。
概率和置信度也需要分开看待。报道没有解释两者的具体定义,更没有提供校准结果,因此不能直接把置信度当成业务正确率。
多模态能一起输入,成本仍要主动控制
该 API 基于 Gemini 原生多模态架构,支持在同一份输入中组合文本、图像、音频、视频和 PDF。
原文举了两个例子:把通话录音和账户元数据放在一起,或者同时提交扫描版 PDF 理赔文件与受损照片。这类任务需要结合不同材料作判断,接口允许开发者一并提交相关证据。
开发者还可以调整图像和视频输入的分辨率,控制视觉细节与 Token 成本。这里存在实际取舍:分辨率降低后,细小文字或局部损伤是否仍可识别,需要用任务样本验证。
报道还称,该 API 已在 Google AI Studio 提供,并有免费额度用于原型开发,但没有列出免费额度数量和具体限制。
我的判断
把重复、独立的判断集中处理,确实贴合 AI 应用中的常见需求。尤其是同一份上下文需要经过多项检查时,这种接口值得进入候选方案。
但目前提供的是产品介绍,没有作者实测,也没有与通用模型多次调用、批量请求或确定性规则的对照数据。150 至 250 毫秒是报道中的指标,不能替代自己业务里的测量。
对于明确的字段校验、权限判断和固定条件匹配,我仍会优先使用代码规则。涉及语义理解或跨模态证据时,再评估模型判断是否有收益。原文也没有给出 SDK、请求参数或响应结构,仅凭这条消息还不足以直接完成接入。
能拿来做什么
- 在现有 AI 应用中,先找出针对同一份上下文执行的独立检查,整理成问题集,用 Google AI Studio 的免费额度验证是否适合批量处理。
- 如果正在做工具选择或模型路由,可以用真实请求比较它与现有方案的准确率、整体延迟和输入费用,再决定是否接入。
- 对图像、视频或扫描 PDF 场景,用不同分辨率测试同一批材料,记录漏判情况,再选择成本可接受的输入配置。
- 接入概率和置信度分数前,先准备有标准答案的样本,验证分数与判断正确性的关系,再设置自动处理和人工复核的阈值。