Gemini 4 Carbon 开放,多智能体协作预览
Google 在两周测试后正式开放 Gemini 4 Carbon,报道称其多项基准领先,部分任务成本不到 Fable 5.2 的一半。同时预览 /swarm 功能,让多个智能体实时拆分复杂任务。
AI 深度解读
Gemini 4 Carbon 刚结束两周测试、正式开放,文章就认为它的新鲜感已经被 Fable 5.2 冲淡了。但对程序员来说,更有用的问题是:Carbon 适合接哪些任务,完成任务究竟要花多少钱,以及多 Agent 协作能否兑现效率承诺。
原文的结论并不是新模型全面胜出。Carbon 在部分编码、自动化和安全任务上表现突出,但 Google 仍推荐多数日常工作使用 Argon。读这篇报道,重点应放在任务分工和成本口径,而不是追逐榜首。
Carbon 分数更高,为什么日常开发还推荐 Argon
Google 将 Gemini 4 Carbon 定位为 Gemini 4 Argon 的补充,面向多步骤编码、复杂调试和开放式科学研究。按 Google 的建议,多数软件工程和知识工作仍适合交给 Argon。
原因藏在推理过程里。Carbon 会消耗更多 token,进行更深入的分析和更长的验证循环。复杂问题可能因此受益,简单问题却未必需要付出这笔开销。
每 token 同价,不代表完成同一件事的成本相同。
两者的 token 单价相同。Carbon 的常规价格为输入每百万 token 4 美元、输出 20 美元;开放后的优惠价仍为输入 2 美元、输出 10 美元。付费开发者和企业客户可以通过 Google AI Studio 中的 Gemini API、Android Studio 或 Gemini for Business 使用它。
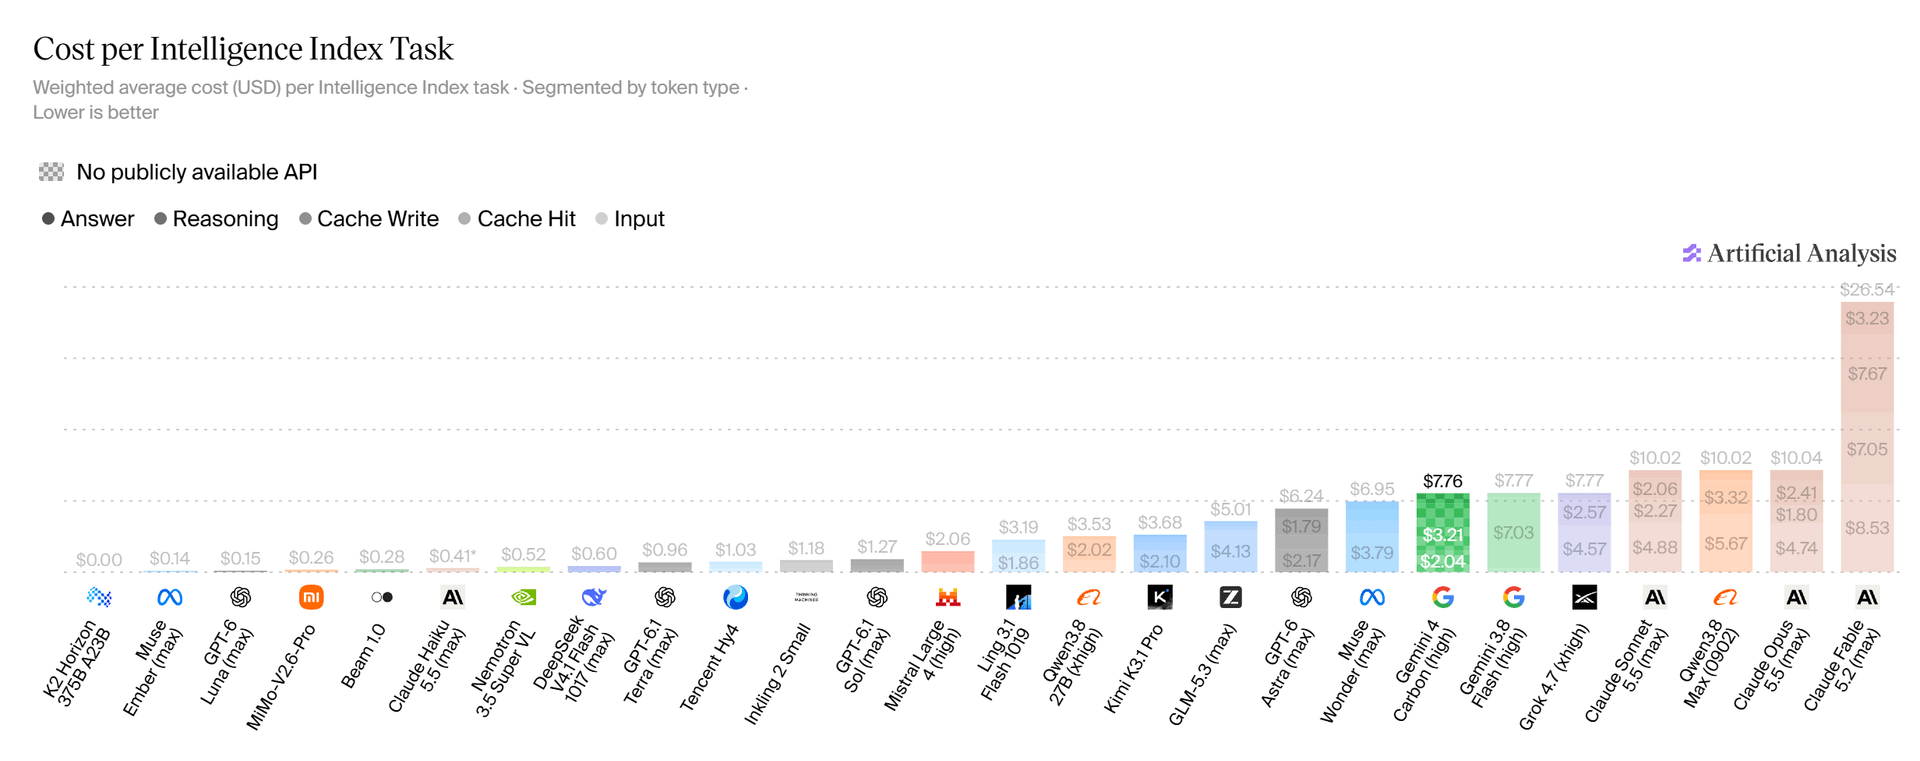
Artificial Analysis 两周前公布的测试按常规价格计算,Carbon 每解决一个任务花费 7.76 美元,表现优于更早的预算模型 Flash 3.8,成本也更低。这是有用的结果,但不能直接拿它与优惠单价混算。原文还猜测 Gemini 4 的 Flash 版本可能很快推出,没有给出确定时间。
榜单各有胜负,任务成本也要一起看
Artificial Analysis 的综合结果里,Fable 5.2 在 High 档得分 62,领先 Carbon 的 60 分,每任务约 9 美元;升到最高档后,Fable 5.2 的成本达到 26.50 美元。同一测试中,Opus 5.5 Max 为 10.04 美元,GPT-6 Astra Max 为 6.25 美元。
这组数据支持的判断比较有限:Carbon 有竞争力,但综合表现并未领先,而且更便宜的配置也存在。
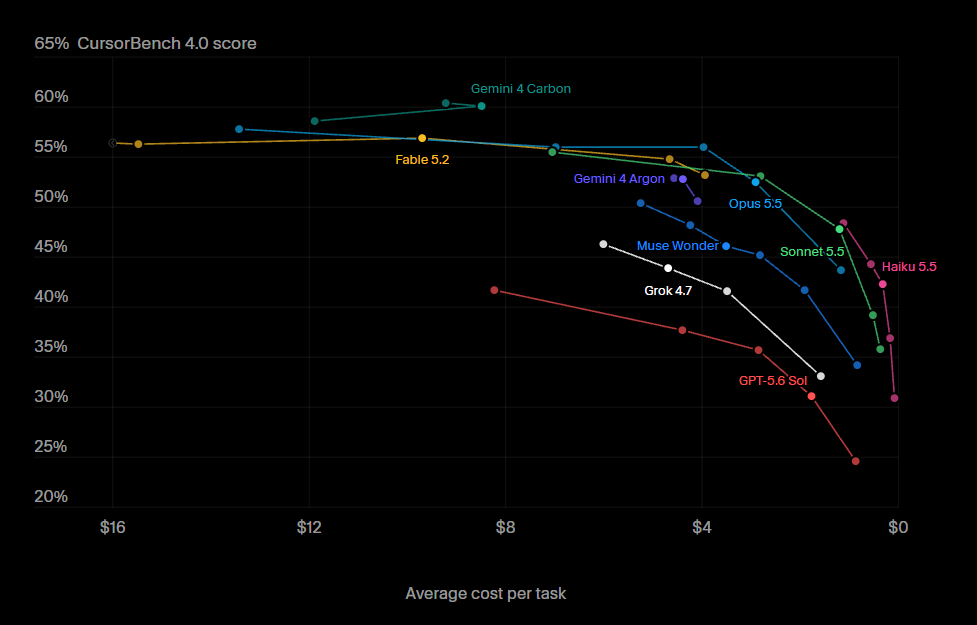
换到具体任务,排名又变了。Google 引用的新结果显示,Carbon 在 CursorBench 4.0、Perplexity 的 WANDR 和 Zapier 的 AutomationBench 上排名第一。AutomationBench 中,它的每任务成本不到第二名 Fable 5.2 的一半。
CursorBench 4.0 上,Carbon 得分略低于 60%,平均每任务约 8 至 10 美元,领先 Fable 5.2 和 Gemini 4 Argon;GPT-5.6 Sol、Grok 4.7 则落后较多。这说明它在该编码测试中表现突出,不能据此推导所有仓库都会获得同样收益。
Google 还与 Artificial Analysis 合作推出 Multimodal Knowledge Agent(MKA)基准,考查含图表、蓝图和表格的密集文档分析。Carbon 排第二,略低于 Fable 5.2、略高于 Opus 5.5,平均成本不到第一名的六分之一。
编码榜、综合榜和文档分析榜没有给出同一个冠军。选模型时,测试内容是否接近自己的工作,比排名本身更重要。
/swarm 把任务拆给多个 Agent,收益还要验证
Google 同时预览了 Antigravity 中的 /swarm。用户输入一个提示词,系统便组织多个 Agent 协作,并展示实时进度。
其中,Carbon 负责架构设计、协调和审查等深度推理任务;更快、更轻的模型在隔离工作区中并行执行,也承担对抗式验证,也就是主动寻找其他 Agent 结果中的错误。
Google 展示了三个例子:骑着 GBike 探索 Mountain View 园区的鹈鹕 3D 游戏、依据历史照片重建埃菲尔铁塔施工过程的交互场景,以及具备座位相关空间声学效果的 18 世纪可演奏 fortepiano。
这些演示能展示任务跨度,却没有回答普通项目能省多少时间、增加多少成本。原文也提到,OpenAI、Anthropic 和研究者对 Agent 群的成本收益持谨慎态度。
并行处理最直接的价值是缩短等待时间。前提是任务拆得开、接口约定清楚,合并结果和相互检查的开销也可控。原文没有给出 /swarm 与单 Agent 完成相同任务的对照数据。
安全结果很亮眼,但测试边界不能省略
报道中更具体的落地证据来自 Fairwind Program 的两周早期测试。Google 称,在 Wiz 的 Scan for Good 项目中,Carbon 扫描两家大型 SaaS 提供商,不到两小时就发现了真实零日漏洞。
Google 云安全团队还让它为一个流行开源项目的两个已知漏洞编写了可运行的概念验证代码(PoC),从而证实漏洞具备严重可利用性,程度可与 PHP2Shell 相比。在自主安全系统 Project Fortify 中,Carbon 对开源代码库的检出率比 Argon 提高超过 25%。
这些属于 Google 披露的实际测试结果,原文没有提供足以独立复现的完整细节。Google 还称它在漏洞发现 SEC-bench Pro、漏洞利用 ExploitGym 和漏洞修复 CWE-bench v1 上领先,但没有公布具体分数,而且这些结论只适用于 Fairwind Program 提供的版本。
安全报告给出的数字同样需要按测试范围理解:
- 在 375 项内部诚实性任务中,Carbon 通过率为 92%,Argon 为 70%;面对缺失实验数据,Carbon 有 98% 的情况拒绝编造。
- 在模拟网络攻击中,它阻断了自适应红队 Agent 的 99% 攻击路径,单次尝试突破率从 Argon 的 3.1% 降至 0.8%。
- Trajectory Labs 用 132 小时、超过 13,000 次查询,没有找到通用越狱方法。
- Google 称 Carbon 在 Gray Swan IPI 上的提示词注入攻击成功率为 0%,并称这是首次有模型达到该结果。
最后一项尤其容易被误读。测试中没有成功攻击,不等于任意环境都能抵御注入。原文也明确提出另一种可能:这套测试已经不足以区分更强模型,需要提高难度。
我的判断
我认同这篇报道把单价、任务成本和具体能力放在一起看。对开发团队而言,模型能否完成自己的任务、总共需要多少次尝试,比某张榜单领先两分更接近采购和使用决策。
但文章里的证据强度并不一致。Artificial Analysis 的结果、Google 引用的专项榜单、内部安全测试和产品演示,各自只能支持对应范围的结论。它们不能拼成一个「全面更强且更便宜」的判断。
相比所有请求统一使用 Carbon,保留 Argon 处理日常工作、遇到复杂任务再升级,更符合文中提供的信息。相比单 Agent,/swarm 的并行潜力也合理,但缺少同任务对照,目前还不足以认定它更省钱或总体更高效。
能拿来做什么
- 给日常 AI 编程建立任务分流:常规修改先使用 Argon,把需要跨文件分析、多步骤调试和反复验证的问题交给 Carbon,再记录升级是否改善结果。
- 评估模型时,用自己的前端或 Node 仓库任务记录最终通过率、总 token、返工次数和实际账单,同时注明采用常规价还是优惠价。
- 试用
/swarm时,先选择能清楚拆分、验收标准明确的任务,并与单 Agent 比较总耗时和总费用,判断并行是否值得。 - 将安全扫描结果作为待验证线索,安排人员复核漏洞和 PoC;即便模型在注入测试中达到 0%,接入仓库、文档和工具时仍应限制权限。