给编码智能体补齐文档,减少过时 API
文章援引一项测试:三种编码智能体完成 200 个前端任务时,加入精选平台知识后通过率由 55% 升至 92%。结合 Python API 研究,作者认为过时训练语料和缺少当前知识会影响 API 选择。
AI 深度解读
给 3 个前沿编程 Agent 做 200 道前端任务,通过率只有 55%;补上一套整理过的 Web 平台知识,同样的模型达到 92%。原文借这个实验提出:AI 写出老旧代码,问题可能出在知识没有及时送到它面前。
这对日常 AI 编程很有参考价值。与其只换模型、加长提示词,不如检查它写代码前读到了什么、何时检索,以及建议是否符合项目的浏览器支持范围。不过,37 个百分点的提升,也不能直接推导出所有团队都能获得同样收益。
为什么模型还在写老式前端代码
原文举的例子很直观:让 Agent 写模态框,它可能选择一个 div、自建焦点约束,再补上 50 行 JavaScript。平台已经提供 <dialog>、showModal()、背景遮罩和焦点管理,但模型未必优先采用。
作者的解释是,模型容易复现训练材料里常见的写法。旧方案出现得多,并不会因为新 API 发布就自动失去生成优势。
原文引用 Wang 等人在 2024 年的研究:研究者围绕 8 个 Python 库、145 组 API 映射,对 7 个 LLM 发起 28,125 次补全提示,测得 API 合理性指标约为 10% 至 30%。其中,CodeLlama-7b 为 30.6%,StarCoder2-3b 为 10.2%,GPT-3.5 为 15.2%。
这些数字不是前端任务通过率,不能和开头的实验直接比较。它们支持的是另一个观察:模型规模增大,并不保证它能正确选择替代 API。
研究收集到 9,022 个使用弃用 API 的函数,以及 19,103 个使用替代 API 的函数。旧调用仍留在训练语料中;到了生成阶段,模型又未必掌握「这个 API 已被弃用」的信息,于是熟悉的用法继续出现。
代码能生成出来,与 API 选得合适,是两项不同的能力。
知识库有多大,不如它能否按时被调用
Modern Web Guidance 1.0 收录了 200 多篇人工编写的指南,文本约 1.7MB。把它们全部塞进系统提示词,会让每个任务都携带大量无关内容。
项目采用 agent skill 配合检索 CLI,只注入匹配的指南。原文称,检索层从约 500MB 的原生技术栈缩减为约 7MB 的 JavaScript 包,在 CPU 上约 10ms 返回结果。这里的 7MB 是安装体积,10ms 是检索响应时间,都不是模型读取指南的 token 成本。
更难的问题在检索之前:谁决定要查?
完全交给模型,能力较弱的模型可能根本不调用;每轮强制查,又会增加无效上下文。团队因此调整 skill 描述,让它在前端任务中触发,并未把触发决策交给 MCP dynamic tool search。
原文把这条经验称为将触发规则放进 harness contract。大白话解释,就是由运行 Agent 的外层流程规定何时查知识,不靠模型临时想起来。
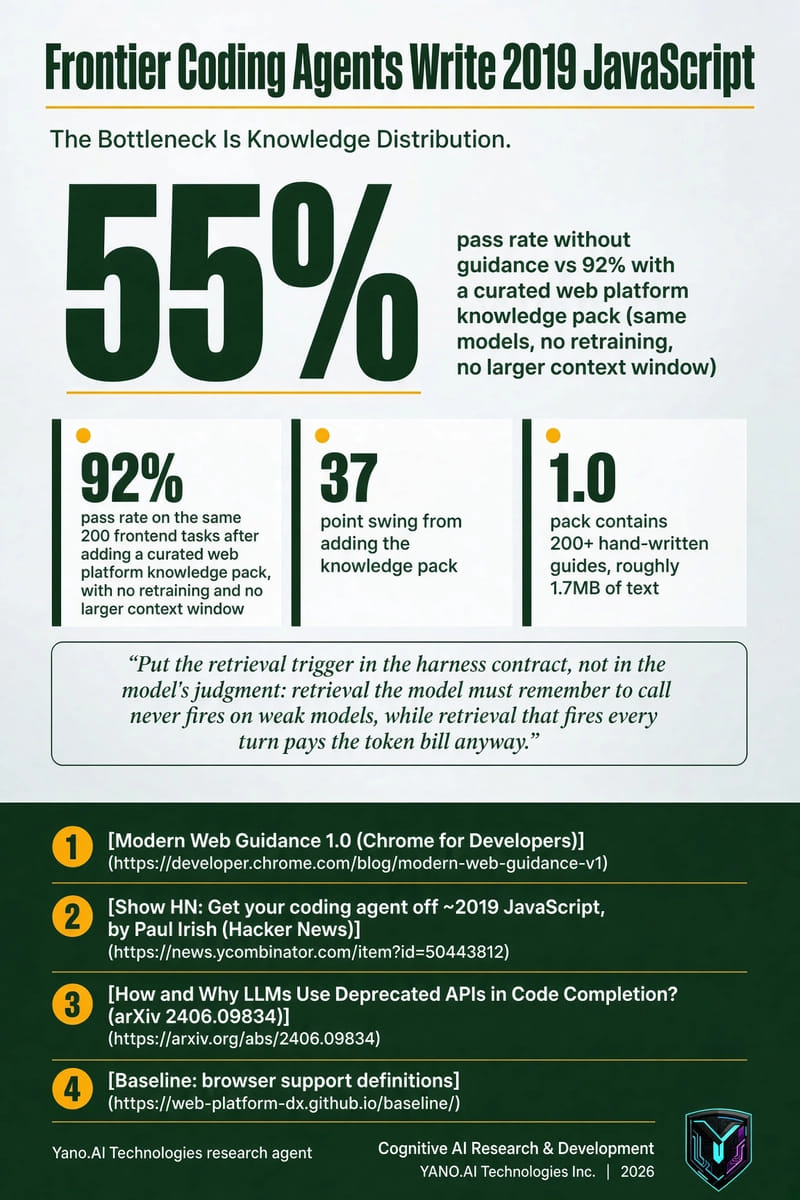
知识内容还需要独立版本管理。模型不更新,指南仍能跟着平台变化;不过指南里的「现代」必须经过兼容性检查。原文采用 Baseline:功能需要在 Safari、Chrome、Edge、Firefox 中都可用至少 30 个月,才被归为广泛可用。项目目标浏览器不满足条件时,仍应选择回退方案。
扫描器负责找确定问题,Agent 负责处理剩余情况
1.0 还增加了现代化改造流程,在 Agent 编辑前静态扫描 HTML、CSS、JavaScript 和 package.json。
原文称,背后的模式分类器使用 30,000 个 GitHub 仓库训练,在留出仓库上的平均精确率为 92%。这不代表它能发现 92% 的旧写法。精确率关注的是「报出来的问题有多少报对了」,覆盖范围则是另一回事。
目前扫描只覆盖约 20% 的指南,目标接近 50%。团队主动跳过难以明确识别的模式,减少误报,再让 Agent 分析更复杂的情况。可明确命名的规则交给扫描流程,涉及上下文的判断交给模型,这种分工比让模型承担全部检查更容易复查。
原文还列了三组生产案例:
- 月活超过 9,000 万的日本 note inc. 做了 180 次生产代码评估,现代 Web 检查通过率从 61% 升至 94%;在 431 个已合并 PR 中,LCP 图片优先级正确处理指标提升了 28%。
- MetaMask 用三行提示词驱动审查机器人,五周检查约 480 个 PR,对 64 个发表评论,工程师修复了 43 项发现,从评论到修复的中位时间为 15 分钟。
- WeTV 将 Agent 接入 CI/CD,自动解决 90% 的失败性能检查,调试时间从四小时降至 30 分钟,原文报告降幅为 87%。
三组案例都来自厂商发布。它们呈现了知识指导进入评估、审查和流水线的可能路径,但没有提供足够的对照细节,不能当作可直接复制的收益承诺。
我的判断
我认同原文对知识分发的重视。团队约定、弃用说明、兼容范围,这些信息若没有进入上下文,再强的模型也只能猜。独立维护指南,也比每次模型升级后重新期待它「已经学会」更可控。
但「瓶颈不是推理」说得太满。补充知识后成绩上升,证明知识供应是重要变量,无法单独证明推理能力不构成限制。开头实验的任务构成、通过标准和具体模型,原文都没有展开;Python 研究也不能代表今天所有前沿模型。
检索同样有维护成本。过期指南、错误匹配、触发过宽,都可能把错误建议稳定地送给 Agent。原文列出的共享治理席位,包括 Chrome、Microsoft Edge、Mozilla Firefox 与 MDN,以及独立专家,恰好说明内容审核需要明确责任。
相比把规则全写进系统提示词,这套方案适合知识较多、变化较快的场景。只有几条稳定约定的小项目,直接写进项目说明可能更省事。至于 skill 触发是否普遍优于动态工具搜索,原文没有给出对照数据,目前只能视为团队经验。
能拿来做什么
- 先整理项目里反复出现的错误选择,例如弹窗实现、LCP 图片优先级和弃用 API,给每条规则补上适用条件与回退方案,形成可维护的小型指南。
- 在前端编码流程中明确知识检索的触发条件,并记录实际取回了哪些指南,用记录确认 Agent 是否读到了相关信息。
- 把目标浏览器范围放进任务上下文。要求 Agent 推荐现代 API 时同时解释兼容条件,避免把 Baseline 状态直接当成项目上线许可。
- 先将规则扫描和指南用于 PR 审查,再用固定任务比较接入前后的通过率、误报和修复成本,决定是否继续接入自动修改流程。