用 Kiro 规格文档约束 AI 开发
文章介绍规格驱动开发及其在 AWS Kiro IDE 中的落地,用客服 MCP 服务示例说明如何明确系统需求和接口契约。内容还对照了在 Kiro 之外完成的更完整实现。
AI 深度解读
AI 写一个脚本,靠几轮提示往往就能跑起来;要它同时维护数据模型、多个 API 和接口约定,反复追问就容易变成反复返工。作者在一场 AWS Egypt 线上分享中,用 Kiro 演示了另一种顺序:先确认需求和设计,再让 Agent 写代码。
这篇最有价值的不是推荐一款 IDE,而是解释怎样给 AI 编程增加可检查的约束。不过,现场只完成了方案草拟,完整实现来自另一套工具,不能把它当成 Kiro 提效的实测报告。
规格写到什么程度,才不会变成另一种负担
规格驱动开发(Spec-Driven Development,SDD)的起点,是把「做什么、怎么做」写成双方认可的规格,让人和 AI 都围绕同一份约定工作。它不要求每个功能都先写厚文档,作者引用的分类更像三个投入档位:
- Spec-first:开工前写清楚,后续允许文档落后,适合小型、短命的功能。
- Spec-anchored:规格跟着代码更新,通常通过 CI/CD 中的测试维持约束。
- Spec-as-source:直接修改规格,再由规格重新生成代码,对自动化和可信度要求更高。
对需要长期维护的项目,作者更认可中间一档。文档负责表达意图,测试、审查关卡和 linting 负责检查实现,所以他用「AI engineering ≈ spec coding + guardrails」概括这套方法。
这里的 guardrails 可以理解成能发现偏离的检查机制。只有文档,Agent 仍可能写出不符合要求的实现;只有测试,也可能把错误理解固化下来。SDD 与 TDD、BDD 关注点相邻,但它先问的是「我们是否定义清楚了要做什么」。
规格的价值,在于提前暴露误解,而不是把所有细节提前定死。
作者也提醒,不要为一个 JSON 字段名争论三周。继续细化规格的成本,应该低于以后修正误解的成本。这是经验判断,没有现成公式,但足以提醒团队:字段名、权限边界、数据一致性,并不值得投入同样多的讨论时间。
Kiro 把评审关卡放进了开发流程
按作者描述,Kiro 是基于 Code OSS 构建的 AWS Agent IDE,与 VS Code 共享开源基础。它的特点,是把规格流程做成产品功能。
在 Spec 模式中,工作围绕三份文件推进:
requirements.md类似 PRD,记录功能与非功能需求,验收条件使用 EARS 表达法,强调可测试。design.md记录架构、分层、数据模型、API 和错误处理。tasks.md把设计拆成有顺序、可追踪的实施任务。
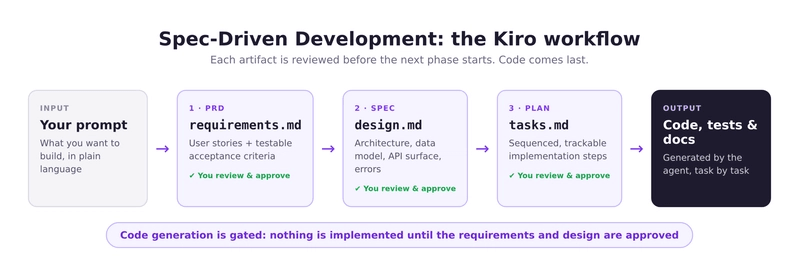
作者强调,前两份文档经过人工审阅后,才进入实现。对程序员而言,这个关卡的作用很直接:在文件大量生成之前,先检查接口是否遗漏、数据归属是否合理,以及失败时该返回什么。
Kiro 同时提供 Vibe 和 Spec 模式,因此探索性任务仍可直接开始。IDE 可以选择具体模型或 Auto,不同模型对应不同 credit multiplier。原文称开放权重模型每次请求的成本明显更低,但没有给出具体模型、倍率或同任务的总成本比较。
安装后可以使用 AWS Builder ID 登录,并导入 VS Code 设置与扩展。另有 Kiro CLI,展示了 /plan、/model、/mcp 等命令,交互形式与 Claude Code、Codex CLI、GitHub Copilot CLI 相近。
这些产品信息有明确时间边界:原文讨论的是 2026 年 6 月的状态,价格套餐从发布时的 3 档增加到了 5 档。它没有提供足够信息,让我们据此计算今天的使用成本。
客服案例真正该学的是共享服务层
分享于 2026 年 6 月 30 日通过 Google Meet 举办,时长一小时。作者选择了一个客服数据查询项目,并拆成两个 Sprint。
Sprint 1 用 Node.js 构建 REST API,连接 SQLite 客服数据库,包含约 100 名客户及其购买、付款、支持交互记录,使用 Swagger/OpenAPI 描述接口,并通过 Postman 测试。SQLite 的选择是为了让演示自包含;作者另提到生产环境需要在 DynamoDB、RDS 等方案之间做选择,但本文没有展开依据。
Sprint 2 将同一套服务层包装成 MCP server,让 Claude Desktop 可以用自然语言查询真实数据,例如「哪个客户的支持问题最多」。MCP 即 Model Context Protocol,是 Anthropic 创建的开放协议。
关键在于「同一套服务层」。如果 REST API 和 MCP 各写一套查询、统计与业务规则,很容易出现普通接口与聊天查询口径不一致的问题。
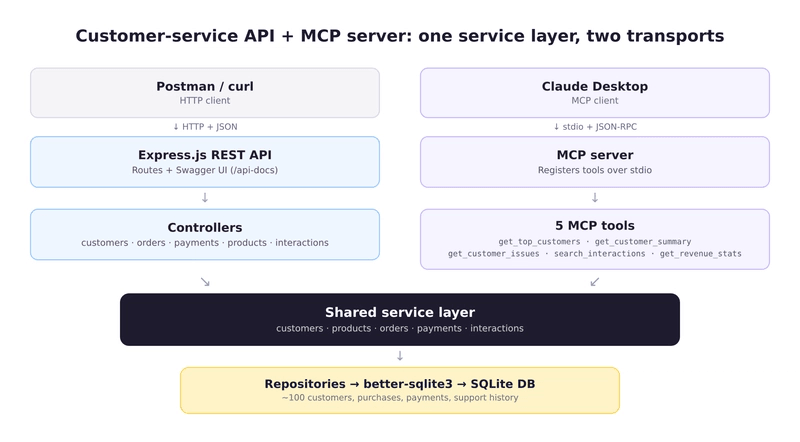
完整参考实现里,REST API 和 MCP server 共用 service、repository 层,通过 better-sqlite3 访问同一个数据库。REST 面向 Postman、curl,MCP 面向 Claude Desktop;两种入口只负责接入,业务逻辑集中维护。
但这个完整实现并非现场用 Kiro 做出来的。现场主要草拟了方案,后续参考版本由 Cursor 和另一模型组成 coder/reviewer 流程完成。
原文称 MCP server 暴露了 5 个工具,却没有列出工具名称、参数或返回结构;也提到 Claude Desktop 能根据数据绘制高消费客户柱状图,但没有提供调用记录和验证过程。因此,我们能理解架构思路,还不能照着文章复现完整行为。文中「五分钟 MCP server」的说法,也不足以作为交付时间估算。
我的判断
我认同把审查提前,尤其是已经涉及多个 API、共享模型和长期维护的功能。比起生成后逐个文件纠偏,先检查需求、接口与分层,能让评审更聚焦。
但文章没有对照数据,无法证明 SDD 减少了多少返工,更无法证明 Kiro 比 Cursor 更快。它展示的是流程与架构经验。
Kiro 的优势,是把顺序和关卡放进 IDE;自建流程则通过规则文件、人工评审和第二个模型维持纪律。前者更容易开始,后者更方便适配已有标准。已经具备成熟评审流程的团队,可以先采用三份文档的组织方式,再判断是否需要换工具。
还要区分「查询真实数据库」和「答案可靠」。数据来源真实,并不能自动保证工具选对、统计口径正确。原文没有说明权限控制、敏感数据处理、查询范围限制和答案校验,这些仍是生产落地时待解决的问题。
作者还建议,非结构化数据的语义搜索可结合向量存储,并提到 OpenSearch k-NN 与 Aurora pgvector。不过,文章没有展示这部分实现,不能把它算作客服案例已经验证的能力。
能拿来做什么
- 为一个需要维护的小功能准备
requirements.md、design.md、tasks.md,先写可验证的验收条件、接口约定和错误处理,再让 Agent 实施;文档厚度跟着风险调整。 - 在 Node.js 服务接入 MCP 前,把现有 REST 接口的业务逻辑整理进共享服务层,让两种入口复用规则,并验证相同问题得到一致结果。
- 在日常 AI 编程中加入明确的暂停点:先审需求和设计,再授权生成代码;需求发生变化时,同时检查规格与验收测试是否需要更新。
- 评估 Kiro 时,选择同一个小功能,与现有工作流比较规格审查时间、返工情况和实际 credits 消耗,再决定产品内置关卡是否适合团队。