排查 AI 生成应用的鉴权与密钥漏洞
作者总结 Next.js 与 Supabase 项目中反复出现的 AI 编码安全问题,包括接口缺少鉴权、管理客户端进入客户端依赖链,以及高权限密钥使用公开环境变量。文章还介绍将问题转为 vibe-shield 扫描规则,并修正误报的经验。
AI 深度解读
AI 写出的 Next.js + Supabase 应用,功能跑通之后,还需要检查密钥是否暴露、路由是否受保护,以及数据库有没有配置行级安全规则。作者提供的 vibe-shield,试图把这些检查放到 AI 编程工具宣布完成之前。
但这份原文并不完整:标题承诺讨论四类安全漏洞和四个误报修复,正文却在 v2.0.0 检测目录开头截断了。能读到的是工具定位、运行方式和部分检测范围,无法据此还原八个具体案例。下面只解读已有信息,并把工具声明与验证结果分开。
AI 说完成了,为什么还要加一道检查
vibe-shield 的定位是静态安全扫描器,加上一份供 AI 编程工具使用的 Agent Skill。前者检查代码中可能存在的风险,后者帮助 Claude Code、Codex、Cursor 和 Windsurf 在交付前执行审查。
这里的静态扫描,可以理解为读取源码并匹配风险特征。它适合发现代码里已经留下的可疑写法,但不能仅凭扫描结果确认整个应用的运行行为。
作者把检查入口放在 AI 宣布完成之前,这个安排有实际价值:功能验收通常关注页面能否打开、接口能否返回;安全验收还要追问,谁能调用接口、调用者能看到哪些数据、哪些凭据会进入客户端。
能运行与有权限运行,是两项不同的验收。
不过,现有片段没有展示具体漏洞代码,也没有提供样本数量,不能据此认定 AI 编程工具产生这些问题的频率比人工开发更高。
扫描覆盖了什么,又没有证明什么
原文给出的启动方式只有一条命令,用于扫描当前目录:
npx -y @vibefoundry/vibe-shield@latest scan .
要注意末尾的 .,它指定扫描当前目录;@latest 则使用最新发布版本,原文没有提供固定版本的复现命令。
v2.0.0 宣称覆盖八个防御方向,但当前片段只完整列出了三个:客户端暴露、认证与路由保护、数据库与 RLS。第四项只露出 AI and…,剩余内容无法确认。
放到 Next.js + Supabase 应用里,这三个方向对应几道关键边界:
- 客户端暴露检查关注不该交给浏览器的信息,尤其是秘密凭据。
- 认证与路由保护检查关注请求进入后,服务端是否确认调用者身份并限制访问。
- RLS,即行级安全,关注数据库是否按规则限制调用者能够访问的数据行。
这些方向有用,但原文没给出具体规则,不能判断扫描器能否识别跨文件鉴权、复杂权限封装,或者 RLS 策略配置错误。
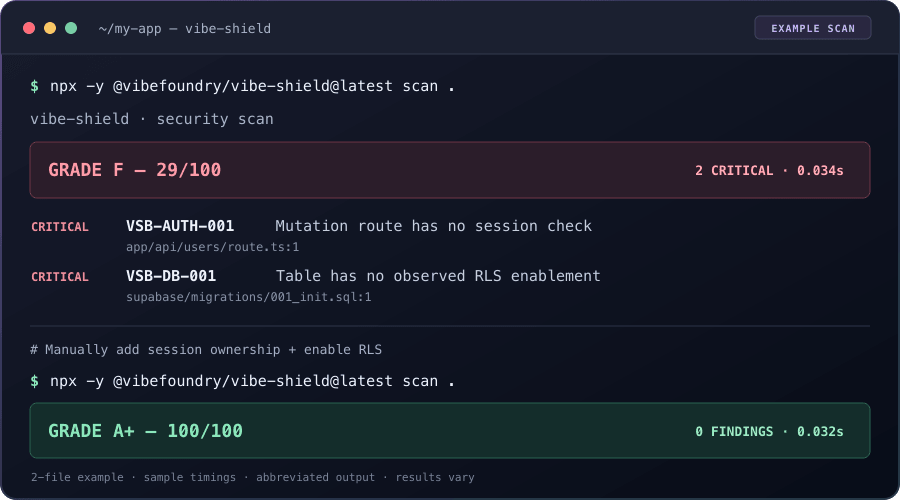
作者明确说明,演示只是两个文件的示例,修复需要手动完成,不同项目的结果会不同。原文徽章还标出了 92 个检测特征、零运行时依赖、Node ≥18.17.0、MIT 许可,以及自扫描 100/100 A+。
这些信息分别描述规则规模、运行条件和项目自身的扫描成绩,不能合并理解成安全效果证明。
扫描没有发现问题,不等于应用获得了安全保证。
我的判断
我认可把安全检查嵌入 AI 编程交付流程。比起每次提醒模型「注意安全」,明确的扫描命令能留下可检查的结果,也方便把发现的问题交回开发者处理。
但这份材料不足以评价检测质量。标题中的四个误报究竟是什么、作者怎样修复、修复是否增加漏报,当前正文都没有交代。没有对照数据,也没有完整实验记录,因此不能替作者背书说它更准确,或者能稳定抓住标题中的四类漏洞。
与人工审查、运行时权限测试相比,静态扫描的优势是容易重复执行,局限是需要从代码推断真实行为。对于 Supabase,发现缺少 RLS 只是检查的一部分;策略存在后是否正确隔离用户数据,仍需要验证。对于 Next.js,识别到鉴权代码也不能直接证明每条敏感访问路径都经过了它。
自扫描满分可以说明工具对自身代码给出的结果,不能代替独立评测。现阶段更合适的定位,是增加一层检查。
能拿来做什么
- 在 Next.js + Supabase 项目的 AI 编程交付要求里,明确列出客户端秘密、敏感路由和 RLS 三项审查,并要求附上检查结果。
- 试用扫描器时,逐条核对告警对应的文件和访问路径;原文演示需要手动修复,不应把运行命令视为修复完成。
- 给涉及用户数据的功能补一次权限验证,例如检查一个用户能否读取另一个用户的数据,让源码检查与实际请求结果互相补充。
- 评估是否接入团队流程前,先用已知问题和已确认安全的代码试扫,记录漏报与误报;标题提到的四个误报修复,在拿到完整案例前不宜作为采用依据。