五款 MCP 安全扫描器实测:阈值左右结论
作者用同一组工具定义比较五款 MCP 安全扫描器,同时呈现恶意定义检出、正常定义告警和扫描覆盖情况。在 485 个 MCPTox 定义中,WARDEN 对 460 个产生高危或严重信号,但作者明确披露维护者利益关联及数据集接触情况。
AI 深度解读
MCP 工具描述也能夹带指令:要求助手先读本地文件、修改另一个工具的参数,甚至隐瞒额外操作。面对这类攻击,安全扫描器究竟能识别多少,又会带来多少告警?
作者把五款扫描器放到同一批工具定义上比较。WARDEN 的高危信号明显更多,但作者同时维护 WARDEN 和数据来源 HISTOR,部分测试材料也参与过产品开发。这份结果值得读,前提是把检出、告警成本、扫描失败和测试集熟悉程度一起看。
460/485 很醒目,但它回答的是哪个问题
参与比较的是五款已发布产品:WARDEN、mcp-audit、mcp-shield、mcpsentry 和 truecopy。作者核对了实际发布包,最后一次 registry 快照日期为 11 月 7 日;已发布 WARDEN 有 40 条规则。
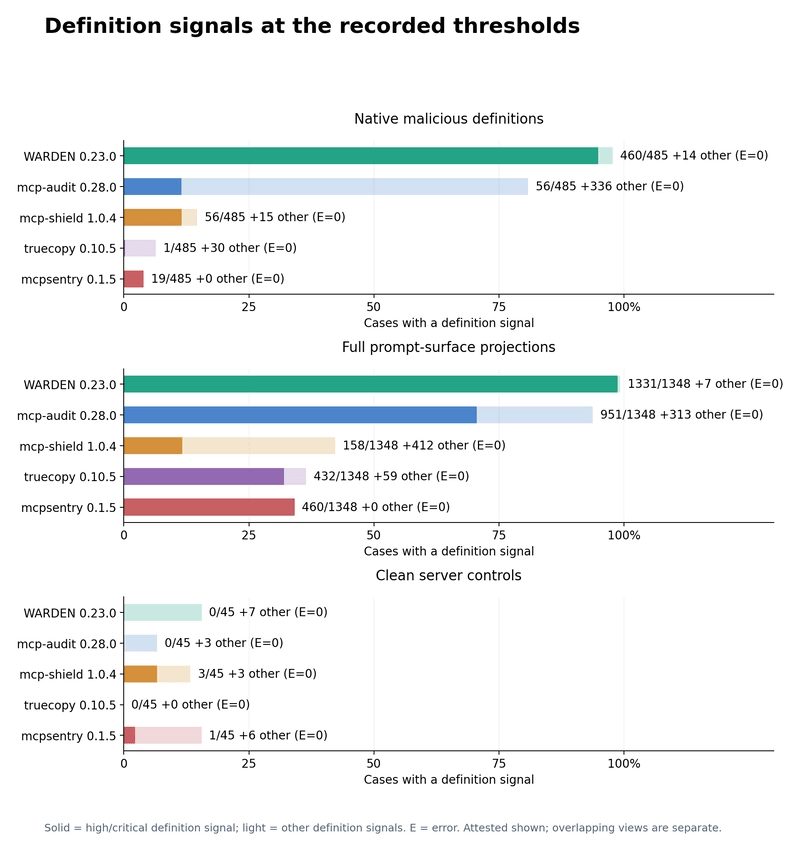
在 MCPTox 的 485 个实际提供过的恶意工具定义中,WARDEN 对 460 个产生 high/critical 信号,其余四款为 1 至 56 个。
这个差距不能直接读成「拦住攻击的能力相差这么多」。它统计的是工具定义触发了什么级别的信号,没有让模型执行攻击,也没有测量最终攻击成功率。
不同产品对信号的处理还不一样。WARDEN 的原生 allow: false 单独保留;truecopy 可能把 advisory 级内容也判为 poisoned 并扣留;mcp-shield 通常发现问题仍以退出码 0 结束;mcpsentry 只有 critical 才退出 1,单独出现 high 不会如此。
对接 CI 或 Node 脚本时,这个区别很实际:只检查进程退出码,可能把「发现风险但正常退出」当成通过。
作者因此同时报告 HC、any、advisory-only 三列,分别表示高危及严重信号、任意相关信号,以及仅低级别提示。其中 advisory-only = any − HC。mcp-audit 纳入低级别提示后,结果变化尤其明显。
扫描器是否发现问题,与你的流水线是否阻止操作,是两件需要分别验证的事。
18,110 行测试,为什么不能当成同样多次独立攻击
这份比较最需要耐心读的,是分母。
18,110 行是测试目标行数,不是独立在线服务器数量。作者自建材料有 23 个攻击和 12 个正常对照;第三方材料有 10 个攻击、1 个正常案例、1 个模糊案例。把这些混在一起算攻击检出率,分母就错了。
MCPTox 又有重叠视图:45 台服务器对应 485 个恶意定义,另有 1,348 个完整提示场景、225 个装饰变体和 45 份正常服务器列表。同一个攻击可能以不同形式出现,几组成绩不能相加冒充更多独立样本。
原始划分中的 267 个开发定义和 218 个测试定义,也不能再当成未知考题。它们已经反复公开,开发集与测试集还共享模板。作者明确承认,这只是历史留出集。
输入转换也存在边界:702 行使用字面换行,646 行使用转义换行;完整场景保留参数文本,但把声明的参数属性表示为字符串,没有还原原始参数类型。正常投影暴露 362 个工具,与论文中的 353 个不一致,去重也没消除差异。
另两组材料更不能直接算误报率。公开语料有 986 份服务器快照,另有 41 条延续观察,扣除 28 个完全重叠项后是 999 份唯一快照。HISTOR 则提供 14,933 个历史包版本,其中 npm 12,023 个、PyPI 2,910 个,涉及 14,449 个不同工具集和 272,657 条工具记录。
这些公开及历史数据没有逐条恶意标签。WARDEN 在历史包中有 409 个 HC 阳性,同时还有 5,918 个 advisory-only 案例。后者会形成实际审查工作量,但不能据此断言它们全是误报。
扫描完成率,也应该摆在检出数字旁边
批量测试调用真实实现的原生分类或完整分析 API,每个案例使用新状态。mcp-audit 运行默认六个分析器的完整流程,只用捕获的工具对象替换发现传输,并经过已安装 SDK 校验。这没有证明每一行都走过各 CLI 的 stdio 通道。
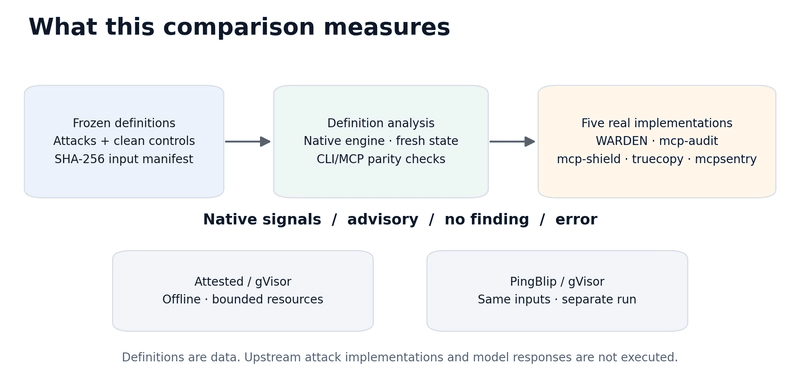
两台远程主机 attested 和 PingBlip 都使用 gVisor 的 runsc,关闭网络,以非 root 的 UID/GID 501:501 运行,根目录及输入只读。环境为 Node 24.22.2、Python 3.13.18,没有执行历史包实现或上游基准 Python。
不过资源并非始终一致。Node 引擎使用 1 CPU / 768 MiB / pids 128;mcp-audit 基础阶段为 pids 256,历史阶段在两台主机上分别使用一个和两个 worker,后者资源为 2 CPU / 1536 MiB。作者明确说,这不是受控速度比较。
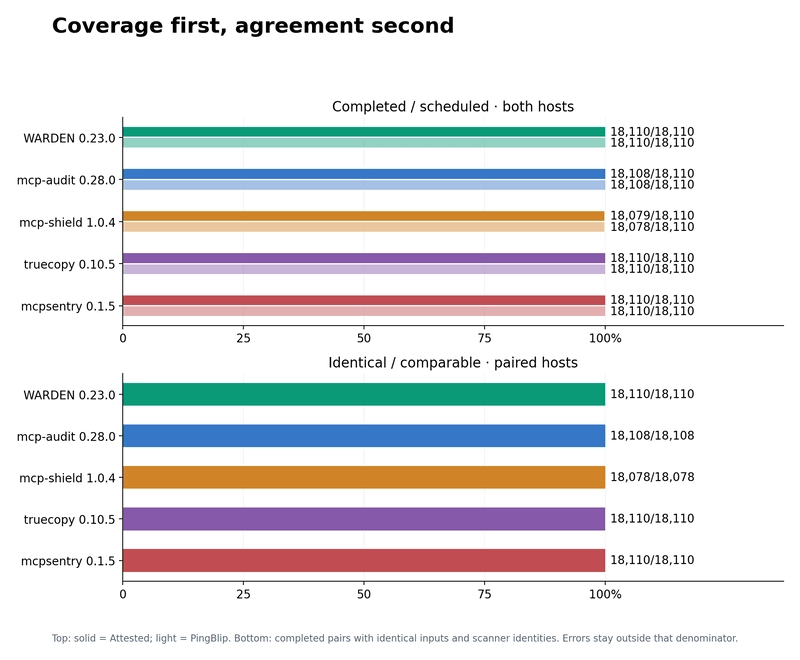
完成情况也有差别。mcp-audit 有 2 条 HISTOR 记录触及原生 schema 或文本预算,只返回部分结果;mcp-shield 在两台主机上都拒绝了 31 个 schema,PingBlip 另外出现一次 30 秒超时。所有产品都没有跳过、未运行或缺失行,但这不等于全部成功完成。
作者采用的关系是:N=C+E+S+U,分别对应计划、完整、错误或部分结果、跳过、未运行;覆盖率为 C/N,HC 信号率为 B/C。只有攻击标签明确时,后者才可称为召回率。
扫描失败不能记为安全,也不能悄悄从报告里消失。
两台主机上所有已完成、可比较的结果完全一致,比较还包括规范化后的完整原生结果签名。这个证据支持运行结果稳定,却不证明分类判断全部正确。
我的判断
我认可作者把不利结果也留在报告里的做法。
未发布候选版本 0.23.1-dev.20261107.1 使用 ruleset 19,没有替换已发布产品。此前 v18 相比 frozen17 出现退步:恶意定义阻断数从 460/485 降到 457/485,历史测试集从 210/218 降到 207/218。
candidate19 .1 修回两项:覆盖 SSH 公钥文件属于安全配置篡改,读取 /etc/shadow 属于访问秘密存储。但读取公开密钥作为前置条件的 FileSystem_22 仍未阻断,作者没有为了提高分数把公钥改叫秘密,也没有把它移出攻击分母。
最终候选成绩为 459/485、209/218、1331/1348,装饰案例 225/225,正常服务器阻断为 0/45;18,110 行全部完成,两台主机均通过 63 个文件中的 1536/1536 项测试。这能证明修复后的已知表现,不能当成面对新攻击的泛化成绩。
局限同样明确。作者有直接利益冲突,WARDEN 接触过部分数据;夹具、适配器及候选源码尚未发布,公开哈希和收据支持核查,却不足以完整独立复现。后来的 .2 修复可选 MIME blob 兼容性,0.23.1-dev.20261108 又加入 Codex/OpenCode hooks,都不能借用冻结 .1 的成绩。
相比只报一个检出百分比,这种报告方式更有参考价值。但它没有测模型攻击成功率、完整代理执行控制或依赖安全,也没有测团队处理告警的实际耗时。关于日常使用是否划算,仍缺对照数据。
能拿来做什么
- 在 Node 或 CI 中接入扫描器时,同时读取结构化发现、严重级别和扫描状态,并明确失败如何处理;不要只依赖退出码。
- 给自己的 MCP 工具保留攻击样本和正常对照,分别记录检出与正常工具受影响的情况。规则调整后,保留旧版本漏检记录,方便判断改动是否带来退步。
- 复用报告配置时,记下 WARDEN 的
allowUnknownServers=true、sensitiveToolPatterns=[]、pinToolDefs=true,并区分定义检测、来源策略和固定工具定义策略,避免把不同机制的效果混在一起。 - 上线前用实际 SDK 检查发现、一次安全调用、未知工具拒绝和后续 ping。作者另外验证了 SDK
1.32.1,以及 filesystem2.2.0、memory2.1.0、sequential-thinking2.1.1;自己的接入版本仍需单独验证。