AQuA 从会话中定位智能体隐性失败
开源质量工具 AQuA 分析多轮会话,发现接口成功、延迟正常但任务执行错误的问题,并支持按需追踪相关代码。文章还介绍无需云项目、在本机运行仪表盘的方法。
AI 深度解读
Agent 返回 HTTP 200,延迟没超标,工具调用也没报错,却把未经核实的座位记成了「已确认」。这种错误藏在对话和执行过程里,常规监控很难发现。AQuA 想补的就是这层检查:从生产会话中找出任务失败,再按需追到代码位置。
作者用旅行助手的脚本回放展示了这套流程。两处单行提示词修改,让完整通过的会话从 5/32 增至 13/32。结果有参考价值,但它能证明什么、部署到自己团队还缺什么,需要分开看。
HTTP 200 为什么兜不住 Agent 的任务质量
服务监控回答的是请求有没有成功执行,用户关心的却是事情有没有办对。两者之间存在空隙:保存座位号的操作可以成功,但保存之前应该执行的座位核验可能根本没发生。
作者认为,靠评测数据集反复运行、评分、修复和比较,几天就能让 Agent 处理预想场景,达到最初的 80%。上线后,用户行为变化,模型、执行框架或工具调整,都可能改变任务成功率,而健康检查继续亮绿灯。这里的 80% 是作者对开发过程的描述,并非通用基准。
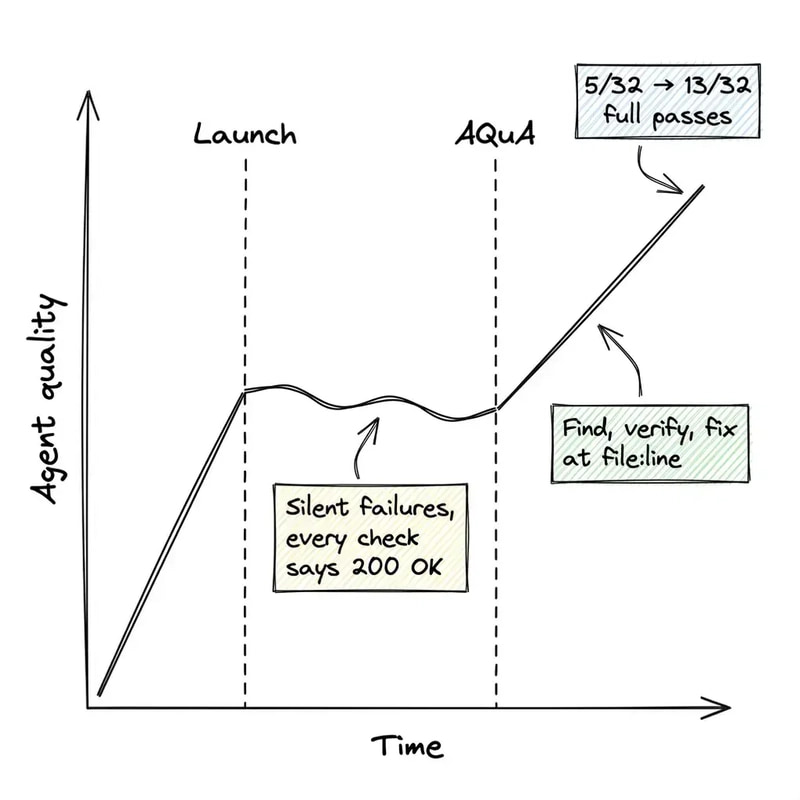
难点还在归因。模型漏掉约束、执行框架路由错误、工具拒绝未记录的参数值、提示词缺少规则,外部表现可能很相似。执行轨迹(trajectory)能告诉你发生了什么,却未必能解释为什么发生。
请求执行成功,不等于用户任务完成。
AQuA 的定位是开源质量检查 Agent。它基于 Agent Development Kit(ADK),运行在 Google Cloud 项目中、请求链路之外,可以定时、部署后或按需扫描 Cloud Trace、Cloud Logging、BigQuery 中的生产会话。
从会话到问题,为什么还要聚类和复核
AQuA 没有直接把每条可疑对话都当成一个待修复问题,而是经过五个阶段逐步收敛:
- Sample 随机抽取最多 1,000 个近期会话。
- Review 阅读会话缩略内容,必要时通过 jq 工具查询完整会话,逐条记录 actual / expected,也就是实际行为与预期行为。
- Cluster 把失败机制相同的发现归为候选问题。
- Verify 由另一个模型复核候选问题,每个候选最多检查三份对话。
- Track 与已有问题匹配,标记为 NEW、RECURRING,或在连续 14 天未出现后标记为 RESOLVED。
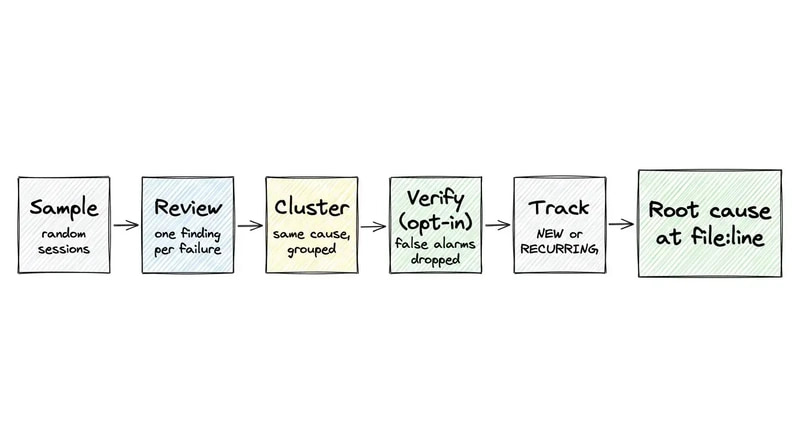
复核默认不开启,需要使用 agents-cli aqua attach --verification;加上 --enforce-verification,才会拦下被复核拒绝的候选。每次运行最多复核 50 个聚类,而且不会检查聚类中的所有会话,所以某个问题关联的轨迹数量只能粗略用于排序。
根因分析也需要主动触发,通过仪表盘 Chat 或 agents-cli aqua run 发起。AQuA 会把失败轨迹与部署时保存的源码快照对照,给出 <path>:<start>-<end> 形式的引用及修改建议。它不会自动修改代码或创建 pull request;问题若出在业务代码之外,就定位到轨迹中的步骤。
这套设计里,源码快照很关键。生产错误对应的是当时部署的版本,拿当前分支解释旧轨迹,可能查到错误的位置。
两行提示词修复,实际改善了多少
作者用较早版本的 AQuA,对 google/adk-recipes 中的 travel-concierge 开启复核,回放四条脚本旅程,共执行 32 次,产生 1,583 个 OpenTelemetry spans。只有 5 个会话通过,另外 27 个产生了 42 条发现。
这些发现聚成 9 个候选,复核拒绝了其中 3 个,包括一个把两个子 Agent 的无关错误合并起来的问题。剩下 6 个已验证问题中:
- 15 个会话跳过了座位核验。
- 7 个会话在
inspiration_agent到place_agent之间丢失了纯素饮食偏好。 - 5 个会话涉及需要核实地图数据、却配置为
tools=[]的poi_agent。
座位问题的触发条件很具体:用户在同一轮选择去程航班 UA204,并要求 3A、3B 两个座位,planning_agent 直接写入会话状态,没有调用 flight_seat_selection_agent 检查可用性和价格。
诊断 Agent 检查部署版本的 33 个文件,将问题定位到 travel_concierge/sub_agents/planning/prompt.py 第 93 行:指令只要求在展示座位图时调用座位子 Agent。饮食偏好问题则定位到 travel_concierge/sub_agents/inspiration/prompt.py 第 23 行。旧版通过 Investigate 发起诊断,v0.3.0 改为向 Chat 请求根因分析。
两处单行提示词修复后,同样 32 个会话的完整通过数从 5 增至 13。改善明确,但仍有 19 个会话未完整通过,不能把它描述成问题已经解决。
费用同样有适用范围。较早版本按标准 Gemini 平台价格计算,这次扫描花费 $3.76,约每会话 $0.12,每会话约 50 spans。另一次单 Agent 的 96 会话扫描,每会话 5 至 6 spans,总价 $0.70;按需根因分析每个问题为 $0.33 至 $2.47。v0.3.0 使用能查询完整会话的审阅 Agent,作者明确表示成本会不同。
我的判断
我认同它把「实际做了什么」和「应该做什么」放到同一条发现里,再跨会话聚类。这比只看工具调用异常更接近业务质量,也能减少逐条翻日志的负担。实验中的复核确实剔除了一次错误合并,说明第一轮判断不能直接照单全收。
但这仍是脚本旅程上的案例。原文没有与人工排查、固定规则或其他评测方案做对照,因此不能据此断言 AQuA 更准确、更省钱。作者关于上线后质量停滞的判断,也主要是经验之谈。
另外,源码引用能通过校验,只能证明文件和行号存在,不能证明因果判断正确。AQuA 的 insight schema 没有 confidence 字段,使用者仍要检查证据是否足以支撑修改。
对于必须执行的业务步骤,发现问题之后还应考虑增加程序约束。
例如座位未经核验就不得进入确认状态,可以考虑在状态写入处强制检查。提示词修补适合快速调整协作行为;确定性校验则更适合守住明确的业务条件。原文没有比较这两种修复方式的效果。
抽样也有边界。作者提醒,影响关键流程 1% 会话的回归可能漏检,可用 agents-cli aqua attach --selector-file 保存 SQL 选择器,指定读取哪些对话。如何筛选关键流程,仍需要团队理解自己的业务。
能拿来做什么
- 先用本地演示判断问题列表和证据展示是否适合团队排查。需要 Python 3.11 至 3.13、uv 和 npm;演示使用生成的一个月数据,不需要 Google Cloud 项目、凭据或模型调用。
下面的命令会创建虚拟环境、构建前端并启动仪表盘:
git clone https://github.com/google/adk-recipes.git
cd adk-recipes/core/python/ambient-quality-agent
make install
make demo
注意 make demo 展示的是合成的 travel_desk_agent,与前面的旅行助手实验不同。打开 http://localhost:8080/?tour 可查看导览;16 条洞察涉及 3,742 条轨迹。默认没有根因,使用 MOCK_ROOT_CAUSE=0.5 make demo 才会加入模拟根因。
-
如果正在维护多 Agent 应用,可以优先检查「跨 Agent 传递约束」和「写入状态前是否完成核验」这两类问题,把已确认的失败补进回放评测,而不是只修改一次提示词。
-
接入自己的 Agents CLI 项目前,先确认版本和部署条件。以下命令固定 AQuA v0.3.0,要求
agents-cli1.10 或更高版本,扩展机制仍属实验性。
agents-cli extension add google/adk-recipes#core/python/ambient-quality-agent --ref ambient-quality-agent/v0.3.0
agents-cli install
注意第一行的 --ref 固定了扩展版本。部署默认需要组织内的 Google Cloud 项目,因为仪表盘由 Identity-Aware Proxy(IAP)保护;没有组织时,原文给出的方式是设置 TF_VAR_ui_iap_enabled=false,再通过 agents-cli aqua ui-proxy 打开。