AI 代码审查也要防范同源模型盲区
文章引用模型评判研究,指出同系列模型可能偏好具有相似错误模式的回答,并将这一风险延伸到 AI 代码审查。作者建议使用不同厂商的模型交叉审查,同时保留人工检查。
AI 深度解读
让 Claude Code 写代码,再让另一个 Claude 会话审查,看起来多了一道保险。但如果两个会话对边界条件抱有相同的错误假设,第二遍阅读可能只是再次认可第一遍的错误。作者因此建议:换一家厂商的 agent 做审查,人再读 diff、核实问题。
这个建议有研究依据,却还没有代码审查场景的直接对照数据。真正值得带走的,是区分「多检查一次」和「增加独立判断」,以及怎样把后者放进日常开发流程。
两个模型都说没问题,为什么还不能放心
原文最有说服力的例子,来自 Goel 等人的论文《Great Models Think Alike and this Undermines AI Oversight》,它是 ICML 2025 的 spotlight poster。
研究让 Qwen2.5-72B 给其他模型的自由回答评分。它判定同家族 Qwen 7B 的正确率为 71%,Llama-3.1-70B 为 67%。但在同一批问题的选择题版本中,Qwen 7B 实际答对 41%,Llama 答对 51%。
这里要区分两件事:自由回答的裁判评分,以及选择题版本的答题准确率。两者不是同一种测量,但这个反差提示,裁判可能更认可「错得像自己」的回答。
研究用 CAPA,也就是 Chance Adjusted Probabilistic Agreement,衡量这种相似性。它会扣除仅凭准确率就可能出现的偶然一致;两个模型给出不同的错误答案,也算不一致。它关心的不是「大家都答对了多少」,而是「大家是否反复掉进同一个坑」。
研究有两组关键结果:
- 9 个裁判模型在看不到标准答案的情况下,评判了 8,707 道 MMLU-Pro 问题的自由回答。所有裁判都倾向于给与自己更相似的模型更高分。控制被评模型的准确率后,相似度与评分的偏相关系数仍为 0.35 到 0.65,参数量低于 32B 的裁判表现得更明显。
- 在 Open LLM Leaderboard 的 130 个模型中,研究者按能力分组,并且只比较不同开发者的模型。在 MMLU-Pro 和 BIG-Bench Hard 上,能力更强的组,错误反而更相似。
模型之间的一致意见,不能自动算成多份独立证据。
但论文没有审查任何 pull request。任务主要是问答和选择题,模型是公开榜单上的开放权重模型,也不是 Claude Code、Codex 背后的模型。结果是相关性证据,不能直接证明同家族 agent 的代码审查更差。
作者把这些发现延伸到代码审查,是一个有理由的推断,还不是已经测出的结论。
换一家厂商审查,具体该怎么做
作者又补了两项研究。Panickssery、Bowman 和 Feng 在 2024 年发现,GPT-4 与 Llama 2 能以一定准确率辨认自己的输出;在微调实验中,越能认出自己的文字,越倾向于在评判时偏爱它。
更接近编程的是 Olausson 等人在 ICLR 2024 发表的自我修复研究:模型读取自己运行失败的程序,再尝试修复。收益往往有限,瓶颈之一是模型对自己代码的反馈质量。由人提供反馈、替代 GPT-4 提供反馈后,修复尝试通过全部单元测试的比例从 33.3% 升到 52.6%,约为原来的 1.58 倍。
这支持了「反馈来源很重要」,但仍不能拿来证明跨厂商审查能获得同样收益。
作者建议的流程很简单:一个 agent 写,另一家厂商的 agent 只审查,人决定哪些问题需要返工。比如 Claude Code 写、Codex 审;反过来也成立。
按原文所述,Codex 的 /review 可以审查未提交改动、某次提交或相对基准分支的变化,按优先级报告问题,并且不修改工作区,也支持自定义审查指令。
下面这段提示词把审查范围、输出要求和权限边界写在了一起:
Review the changes from:
  git diff main...hermes/add-refund-endpoint
Do not edit any files. List bugs by file and line,
most serious first. For each one, give an input
that breaks it. Skip style comments.
重点看 For each one, give an input that breaks it.:要求审查者提供触发问题的输入,能让人更容易验证发现是否成立,而不是接受一串听起来合理的担忧。
git diff main...hermes/add-refund-endpoint 中的三个点,会用两条分支的共同祖先与目标分支比较,聚焦目标分支引入的变化。
如果两个 agent 分别运行在独立的 git worktree,审查者能看到同一仓库中的分支,却看不到另一个 worktree 尚未提交的文件改动。因此,采用这套跨 worktree 流程时,要先提交作者分支的代码。
最后一步依然是人读代码。论文中「能力越强,错误越相似」的趋势本来就跨越了开发者。换厂商可能增加判断差异,但无法保证两套模型没有共同盲区。
Hermes 降低的是操作成本,不是判断责任
原文用作者开发的 Hermes IDE 展示这套流程,带有明确的产品推广立场。
在 Hermes 中,按 ⌘N,Windows 和 Linux 用 Ctrl+Shift+N,每个任务会获得独立的 hermes/<name> 分支和 worktree,任务内容成为 agent 的首条提示。每个任务可以分别选择 agent、模型、effort 和账号。
作者展示的是 Hermes 2.3.4,原文标注发布日期为 2026 年 10 月 15 日。它也支持让 Claude Code、Codex 分别实现同一张工单,再由人比较两份 diff。行为不同的地方,是优先检查的线索;两边行为相同,也不能据此认定正确。
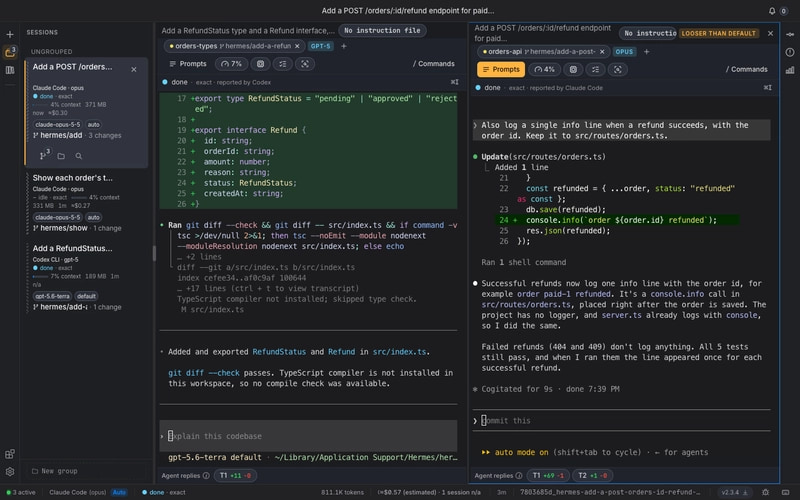
按 ⌘G,或 Ctrl+Shift+G,可以打开 Review Desk,按 agent 的轮次或文件查看变化与风险标记。每轮变化都会保存,可以比较或恢复单轮改动,行评论会回到写下那行代码的 agent。
作者还说明,Hermes 不会替用户回答权限提示,也不会自行向终端输入内容。这套流程中的问题转交,需要用户操作。
这些功能方便组织审查,但并非跨厂商审查的必要条件。普通 Git 分支、worktree 和两个工具也能完成主要步骤。Hermes 免费、以 BSL 1.1 提供可查看的源码,支持 macOS、Windows 和 Linux;双 agent 则可能涉及两份订阅方案和两套用量,审查成本需要另算。
我的判断
我赞成作者对逻辑审查的提醒,尤其是边界条件、错误路径和并发问题。写代码时默认「列表不会为空」,审查时又沿用这个默认,就很难发现缺陷。多开一个会话,不等于增加一种判断方式。
但标题里的「不要让同家族模型审查」比证据更绝对。现有研究没有直接比较同家族与跨厂商 agent 在真实 PR 中的漏报率、误报率和成本。跨厂商更可靠,目前仍是有研究支持的经验性建议,不能当成已经验证的工程定律。
更值得坚持的要求,是让审查意见带着可验证的失败条件。
相比单纯更换模型,测试、类型检查、lint 和人工核查也提供了不同来源的约束。它们各有覆盖范围:静态检查擅长发现明确规则的违反,测试验证选定输入下的行为,模型可以帮助寻找遗漏的场景。不能用任何一种检查的通过,替其他环节签字。
原文也承认,同模型审查可以发现改到一半的文件、没运行的测试、遗留 TODO。没必要为了这些检查,每次都启动另一家服务。应把额外成本花在错误假设最可能藏身的位置。
能拿来做什么
- 给重要改动增加一次只读审查,要求按文件、行号和严重程度列问题,并为每个问题提供触发输入。先确认问题成立,再交给编写 agent 修复。
- 涉及退款状态、异常路径、边界输入或并发逻辑时,可以尝试 Claude Code 与 Codex 交叉审查,同时记录有效发现和误报,判断额外费用是否值得。
- 使用独立 worktree 时,先提交待审分支,再明确提供三点式
git diff范围,确保审查者读到的是准备交付的代码。 - 对同模型的日常检查继续配合 lint、类型检查和测试;如果项目用 LLM-as-judge 决定某项功能能否上线,也要检查裁判与被评模型是否可能共享错误。