用120次审查检验 Claude 插件价值
作者选取5个项目的15个真实 PR,以53个已知问题为参照,对比官方代码审查插件与简短提示词。实验覆盖两个模型、每组重复两次,共120次审查,但摘要未给出结果。
AI 深度解读
给 Claude Code 装上 Anthropic 官方的 code-review 插件,代码审查会更好吗?作者拿 15 个真实 PR 做了 120 次审查。在这批样本里,只用一段提示词,两个模型找到的已知问题都约是插件的两倍,费用还更低。插件的优势是评论少,单条评论更有可能说中问题。
这组结果也提醒我们,切换 Claude Code 会话里的模型,插件内部负责找 bug 和复核的模型可能照旧。要判断升级有没有用,得先弄清楚每一步是谁做的。
同一批 PR,为什么一段提示词找得更多
作者从 Martian Code Review Bench 选了 15 个真实 PR,Sentry、Grafana、Cal.com、Discourse 和 Keycloak 各 3 个,基准一共标了 53 个已知问题。每个 PR 都用 Claude Opus 5.5 和 Claude Fable 5.2 各跑两种方式,每种跑两遍。一种是原样使用官方插件 9780cf4,另一种是用一段提示词,要求报告所有 bug 并给出文件名和行号。环境统一为 Claude Code 2.1.325,effort 设为 high。
作者保存了每次请求和回复,因为 Claude Code 遇到请求被拒时可能悄悄切换模型。Claude Sonnet 5.5 按基准自己的方法评分,统计区间来自对这 15 个 PR 做 10,000 次随机重抽样。120 次审查里,Fable 5.2 的一次插件审查因安全过滤误报中止,其余 119 次完成。
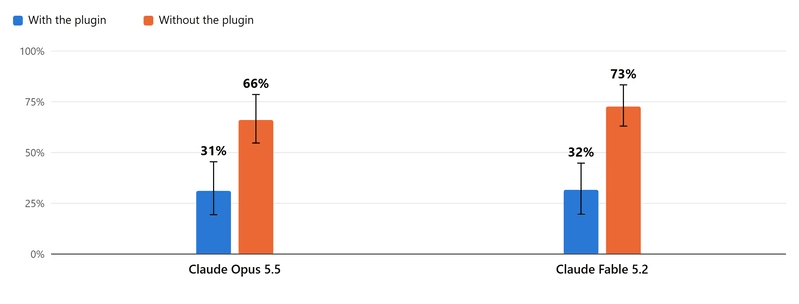
Opus 5.5 用插件找到了 31% 的已知问题,直接提问找到了 66%。Fable 5.2 的两组结果是 32% 和 73%。两个模型在这 15 个 PR 上都没有出现插件找到更多已知问题的情况,插件费用约为直接提问的 1.5 倍。
插件少发了多少评论,又少报了多少真问题
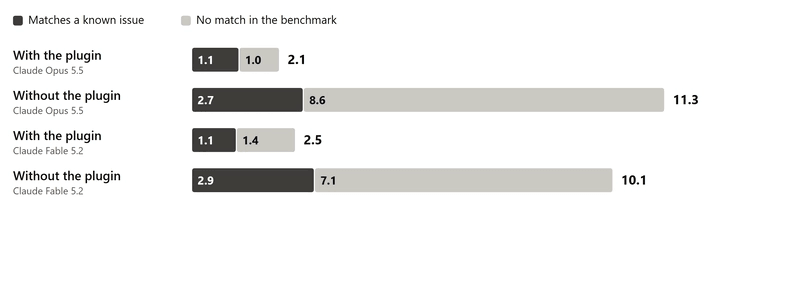
插件只发直接提问约五分之一到四分之一的评论。它让复核助手只报告三类问题:代码跑不起来、无论输入是什么都会给出错误结果,以及能引用明确规则的违规。平均每次审查,Opus 5.5 用插件报 2.1 条,直接提问报 11.3 条。Fable 5.2 则是 2.5 条和 10.1 条。插件把「有多确定」放在了「能找多少」前面。
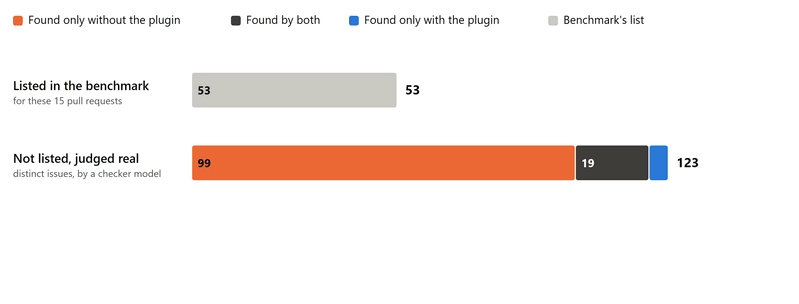
基准也会漏标。543 条未匹配已知问题的报告中,复核模型判定 285 条确实有问题,去重后得到 123 个额外问题。其中 99 个只由直接提问发现,19 个两种方式都发现了,5 个只由插件发现。第二个模型复核了 30 条抽样判断,同意其中 24 条。作者认为额外问题的估计可能偏高。
把命中基准或经 AI 复核判真的报告都算作有效,插件在 Opus 5.5 和 Fable 5.2 上的有效评论占比分别是 81% 和 72%,直接提问是 63% 和 67%。但按每轮收到的有效评论数算,直接提问约有 7 条,插件不到 2 条。如果审查评论会直接发到 PR 上,前一个指标关系到同事要花多少时间排除噪声,后一个指标关系到这轮审查能帮忙发现多少问题。
会话换了新模型,插件里的模型也换了吗
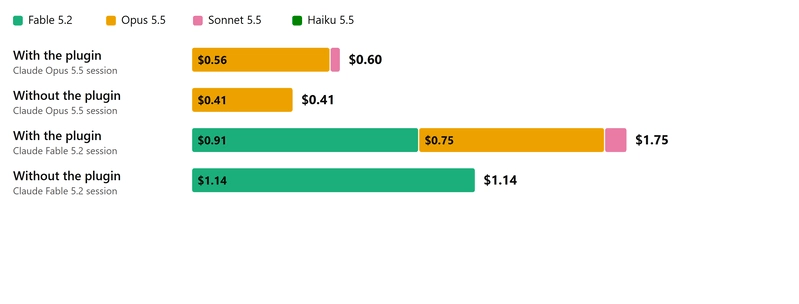
插件的现行流程发布于 2026 年 10 月 26 日。Opus 5.5 在这之前推出,Fable 5.2 则于 2026 年 11 月 9 日推出。切到 Fable 5.2 后,插件仍让 Opus 5.5 助手找 bug 和复核。作者报告,这些助手占该组插件账单的 43%。单次审查成本图把开销拆成了 Fable 5.2 的 0.91 美元和 Opus 5.5 的 0.75 美元。
插件在「报告能匹配到已知问题的比例」上原本领先 31.9 个百分点,到了 Fable 5.2 只领先 16.6 个百分点,这个变化的统计区间没有跨零。至于「找到了多少已知问题」,插件相对直接提问的劣势又扩大了 6.1 个百分点,但区间跨零,可能只是样本波动。再加上两组插件审查都由 Opus 5.5 负责复核,这组结果很难单独回答插件是否会随模型迭代而过时。
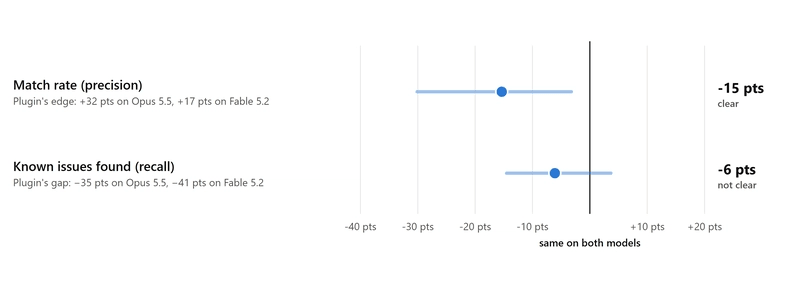
还有一个细节。Opus 5.5 的 30 次插件审查里,有 13 次没有启动任何助手,平均成本是 0.28 美元,启动助手的审查则是 0.85 美元,两组表现接近。跳过流程是模型自己决定的,可能恰好挑中了更容易审查的 PR,不能据此算出助手带来的收益。
我的判断
我会把直接提问当成评估代码审查插件时的基线。这次实验里,插件用更高的费用换来了更少的评论和更高的单条有效率,也漏掉了更多已知问题。如果审查结果先给提交者自己看,多几条候选问题通常有空间逐条筛。如果结果会直接发给整个团队,评论数量和打扰成本就更重要。给普通提示词加一句「只报最确定的问题」也可能缩短评论列表,但作者只试了一种措辞,没做这个对照。
更大的局限在评分。样本只有 15 个 PR,基准公开,作者没有预设通过门槛,也没有放入无缺陷的代码来测误报。Claude Sonnet 5.5 负责匹配和判定,二次复核用的是参测模型 Fable 5.2,全程没有人工核验。Claude Code 还协助作者写测试程序、跑实验、分析和起草。这些数据适合用来决定本地对照怎么做,推广到团队前还要看自家 PR 上的漏报和误报。
能拿来做什么
- 用同一批前端或 Node PR 对照插件和一段普通提示词,两边都要求给出文件和行号,并显式固定
effort。分别记下找到的已知问题数、有效评论数和费用。 - 升级 Claude Code 会话模型时,先读插件当前版本的流程,再从请求和回复里核对找 bug、做复核的实际模型。作者在准备实验时遇到过替代服务由别的模型应答,而 Claude Code 的摘要仍显示请求的模型。
- 如果审查结论会自动发到 PR,补一组「只报最确定的问题」的提示词,并加入人工确认过的干净改动。提前定好能接受的漏报和误报,再让同事复核样本。原实验花了约 136 美元,作者用订阅赠送额度支付。