AI 写代码时,类型检查能减少缺陷吗
作者让 Claude Code 分别用 TypeScript 和 JavaScript 各实现三次简化 Git,将任务扩大至数千行,并比较遗留缺陷。实验延续了此前关于语言对生成耗时与成本影响的研究,但摘录未展示最终结果。
AI 深度解读
让 AI 写代码,TypeScript 就一定比 JavaScript 更少出错吗?作者让 Claude Code 从零实现同一个 Git 兼容工具,两种语言各跑三次。结果是:几千行规模下,两边都接近全对,没有观察到明确的可靠性差距。
这项实验最有价值的地方,是把「类型更安全」拆成了可检查的问题:类型检查究竟拦住了什么,测试补上了什么,Agent 的成本又花在哪里。它不足以替团队决定技术栈,却能帮助我们判断,怎样的验证比单纯换语言更有效。
六次实现,比较的究竟是什么
作者选择的任务叫 tgit,一个与真实 Git 兼容的 CLI。它既要读写相同格式的仓库,输出也要逐字符一致。规格分成 v0.1.0、v0.2.0、v0.3.0,依次交给 AI,在同一仓库上继续开发。
选择 Git 有一个关键好处:正确答案可以直接运行出来。作者不用凭感觉判断实现质量,而是让 tgit 和真实 Git 执行相同操作,再比较结果。
两组都使用 Docker 中的 Claude Code 和 Claude Opus 5.5,直接运行在 Node.js 上,没有构建步骤和运行时依赖。AGENTS.md 除语言与类型检查要求外逐字相同:
- TypeScript 开启 strict 和 noUncheckedIndexedAccess,禁止 any,完成前必须通过 tsc。
- JavaScript 禁止类型注解,包括 JSDoc 类型,也不执行类型检查。
AI 能看到公开测试,还能调用与真实 Git 比较的工具,但看不到最终评分的隐藏测试。作者另外对每个版本执行 2,000 组随机操作序列,比较退出码、输出、工作区文件,以及 .git 中的 objects、refs 和 index,还检查生成的仓库能否通过 git fsck --strict。
这个检查深度很关键。CLI 返回正确,不代表磁盘上的仓库也正确。
作者还设置了 CLAUDE_CODE_DISABLE_1M_CONTEXT=1,把上下文从 1M tokens 限制到 200K tokens,尝试观察记忆压缩后类型是否更有帮助。TypeScript 三次运行共发生 27 次上下文压缩,JavaScript 为 29 次,每次运行有 8 至 11 次。
不过,最终几千行代码本身仍能放进 200K tokens。撑满上下文的是读文件、测试输出和对话记录。因此,它还没有真正测到「整个代码库已经装不进上下文」的情况。
唯一留下的 Bug,类型检查也拦不住
六次运行全部通过公开测试,隐藏测试也接近满分。最终只有 JavaScript 的 BN03 留下一个 Bug:添加被 .gitignore 忽略的文件时,真实 Git 会报错,并且不写入任何内容;BN03 虽然返回了正确的错误退出码,却先写入了一个空的 .git/index。
它从第一个版本一直留到了最后。只检查终端输出,就会漏掉它。
这次真正查出问题的,是对失败后文件状态的比较。
这个 Bug 是操作顺序错误,不是类型错误。TypeScript 同样允许先写文件、再判断应该报错。因此,「TypeScript 三次零 Bug,JavaScript 三次一个 Bug」不能直接用来证明静态类型有效,样本也太少,无法排除偶然性。
另一个结果更有意思:作者事后用 checkJs 检查最终的 JavaScript 实现,每次得到 832 至 1,022 个类型错误,但这些代码仍几乎通过全部行为测试。
这不能解释成类型错误都无害。它只说明,在这项任务覆盖到的行为里,大量类型诊断没有对应成实际失败。
作者的解释是,两组平均都编写了超过 120 个与真实 Git 对照的场景,并不断修复差异。强验证可能提前找到了许多类型检查原本能发现的问题。这是合理解释,但实验没有单独移除对照测试,尚不能确认因果。
日志也显示,TypeScript 每次运行调用 tsc 40 至 55 次,只有 2 或 3 次报告类型错误,三次运行合计遇到八个。约一半属于找不到名称、参数不足等运行测试也容易暴露的问题;作者认为其中只有可能为 undefined 的检查,体现了 noUncheckedIndexedAccess 的独特作用。
成本差在反复读取,验证方式也不一样
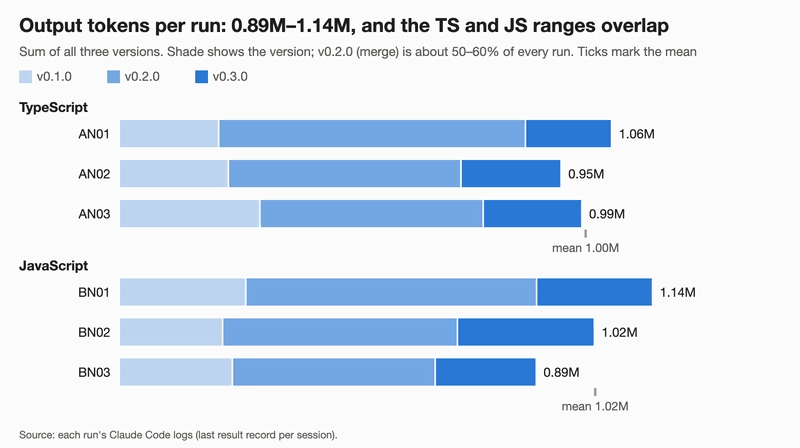
输出 tokens 几乎持平:TypeScript 平均约 1.00M,JavaScript 约 1.02M。加入 merge 的 v0.2.0 最重,占每次运行输出的 50% 至 60%。
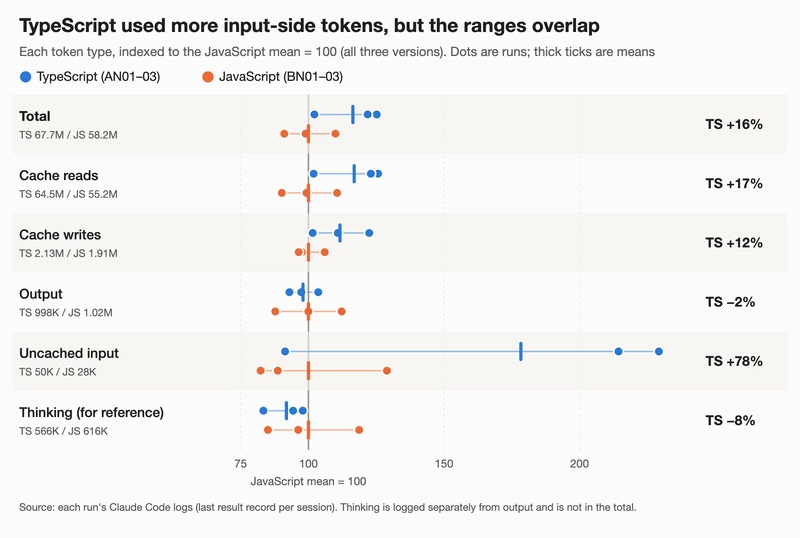
计入输入侧后,TypeScript 的总 tokens 高出约 16%,但各类 tokens 的两组取值范围都有重叠。仅 JavaScript 最大与最小运行之间,输出就相差接近 250K。语言差异没有大到能摆脱运行波动的影响。
日志估算费用为 TypeScript 49.9 美元、JavaScript 46.7 美元,相差约 7%。这些不是实际账单,作者使用订阅运行实验。
为什么 TypeScript 输出略少,费用反而更高?作者估算输出只占约三分之一费用,主要差异来自输入,尤其是缓存读取。TypeScript 缓存读取平均高约 17%,多出约 9.3M tokens,按作者的拆分估算约贡献 3 美元差额;未缓存输入约为 JavaScript 的 1.8 倍。
TypeScript 代码约长 20%。最短的一次有 4,796 行,仍超过 JavaScript 最长一次的 4,642 行。Agent 每轮都要从缓存读取对话,较长的文件内容进入对话后,会在后续轮次反复产生读取开销。
不过,费用拆分使用了作者假定的相对价格,并非官方价格,每次运行的拟合偏差最高约 9%,不能把它当成精确计费分析。
验证方式则出现了更清楚的区别:TypeScript 每次执行 npm test 13 至 19 次,JavaScript 为 28 至 36 次,约为两倍;JavaScript 测试代码也多约 13%。与真实 Git 的比较次数接近,分别为 135 至 200 次、161 至 207 次。
作者推测,没有类型检查时,AI 会更多依靠测试确认修改是否正确。此次规模下没有形成明显成本劣势,但代码扩大后,测试更慢、影响范围更广,情况可能变化。这仍是待验证的推测。
我的判断
我更认可的结论是:在正确答案明确、验证充分的任务里,不能仅凭语言判断 AI 代码是否可靠。
类型检查适合发现接口不匹配、缺失值等问题;行为测试和状态比较能发现「报错之前已经写坏文件」的问题。它们检查的对象不同。日常 Node CLI 开发中,退出码、输出、文件副作用都值得检查,仅通过 tsc 并不够。
但也不能据此认为 TypeScript 没必要。普通团队往往没有一个真实 Git,可以随时充当完整参照;需求含糊、跨模块修改、长期维护等场景,也没有在这里得到验证。每种语言只有三次运行,一个任务、一个模型,很难支持普遍结论。
作者还排除了两个要求超出规格的隐藏测试,以及一组无法正常比较的随机序列。AI 拿到的随机测试生成器也是旧版;六次并行运行受到机器睡眠和负载影响,墙钟时间不可靠,tokens 可能高估 1% 至 2%。这些限制都应一起看。
前一项实验使用 Claude Opus 4.6,每种语言运行 20 次,几百行任务中 TypeScript 的时间和费用约为 JavaScript 的 1.6 倍。这次换成 Claude Opus 5.5,任务也扩大了,不能据此画出「规模越大,TypeScript 越划算」的趋势线。
目前能说的只是:这次没有发现明确差异。关于更大项目中类型是否占优,作者给出了线索,没有给出答案。
能拿来做什么
- 给 Node CLI 或文件处理工具补上失败路径检查,除了退出码和报错文本,还要确认失败后没有留下额外文件或部分写入。
- 让 AI 实现已有协议、命令或兼容层时,提供可执行的参照对象,把同一组输入交给两边,比较输出和持久化状态。
- 评估 AI 编程成本时,同时记录缓存读取、输入、输出和测试次数,并重复运行,避免把一次偶然顺利当成技术栈优势。
- 保留项目现有的 TypeScript 或 JavaScript 选择,先检查验证是否覆盖真实风险;这六次实验不足以成为迁移语言的理由。