网关显示正常,Discord 机器人却离线一周
主机重启时的磁盘 I/O 争用让 Hermes Agent 的 Discord 插件超过 10 秒加载时限,注册调用晚了约 0.7 秒。机器人离线一周,期间 systemd、看门狗和网关状态文件都显示正常。
AI 深度解读
一个 Discord bot 离线了整整一周,systemd、看门狗和网关状态文件却都显示正常。故障出在重启时:Discord 插件超过了 10 秒加载时限,Hermes Agent 的网关继续提供另外两个平台的服务,磁盘上还留着上一个进程写下的 connected。
这次排障对维护 bot、Webhook 或多平台网关的程序员很实用。只看进程是否存活,会漏掉单个平台失效。即使检查已经读到了平台状态,也得先确认那条记录是谁写的、是什么时候写的。
晚到 0.7 秒的插件,为什么能让 Discord 离线一周
2026 年 9 月 30 日约 02:02,作者家里的 Proxmox 节点重启。这个节点的虚拟机和容器共用一块 5400 RPM 硬盘,启动时集中争抢磁盘 I/O,按作者的描述会持续约 15 分钟。
Hermes Agent 的 hermes-gateway 把聊天平台作为插件加载。每个插件必须在 plugins.load_timeout_seconds 指定的时间内完成导入和注册,默认是 10 秒。这次 discord-platform 超时了,register_platform() 约 0.7 秒后才返回,加载器已经放弃等待,迟到的注册结果也被忽略了。
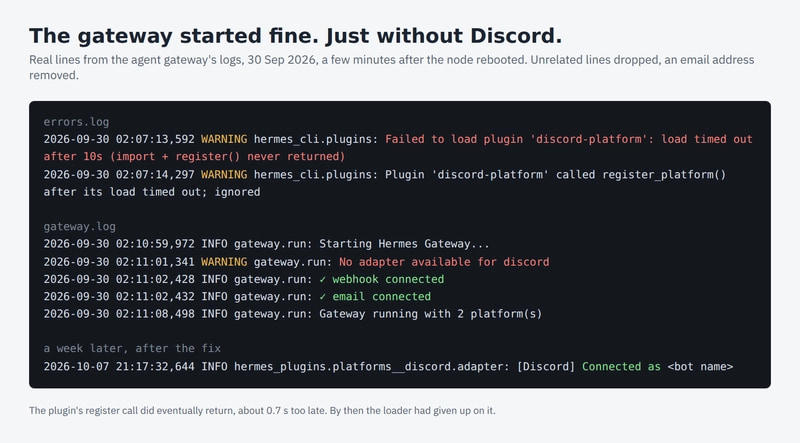
几分钟后,网关启动并记录 No adapter available for discord。Webhook 和邮件正常连接,网关最后报出 Gateway running with 2 platform(s)。配置了 3 个平台,实际只跑起 2 个,这个差异没有触发故障判定。作者直到 10 月 7 日查日志才定位问题。
为什么三处检查都显示正常
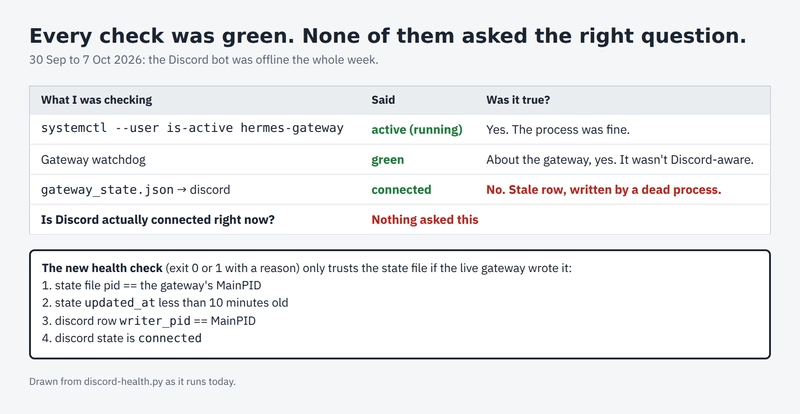
systemd 的 active (running) 只说明进程在运行。原有看门狗也只检查网关是否存活。两处都在准确回答各自的问题,Discord 适配器是否加载成功根本没进入检查范围。
最容易误判的是 gateway_state.json。Discord 行还写着 connected,对应的 writer_pid 是 15603,而这个进程早已退出。新进程没有加载 Discord 适配器,这一行就一直没人更新。读取方如果只认 connected,停机前的一次成功连接就能被当成一周内每次检查的结果。
恢复 Discord 和发现故障,需要改两处
作者先在 config.yaml 里给插件导入和注册留出更多时间。
plugins:
  load_timeout_seconds: 90
真正控制等待时间的是 load_timeout_seconds 这一行。改完并重启后,作者在日志里看到了带 bot 名称的 [Discord] Connected as。这次重启恢复了连接,文章没有交代它是否在同等磁盘压力下复测过。升级如果重新生成 config.yaml,这个值还可能回到默认的 10 秒。
随后作者编写了 discord-health.py。脚本要求状态文件的 pid 等于服务当前的 MainPID、文件的 updated_at 距今不到 10 分钟、Discord 行的 writer_pid 同样等于 MainPID,且该行的状态为 connected。检查通过退出 0,失败则输出原因并退出 1。下面这段专门拦截上一个进程留下的 Discord 状态。
if str(d.get("writer_pid")) != pid:
    print(f"discord row written by pid {d.get('writer_pid')}, not live gateway {pid} (adapter never loaded)"); sys.exit(1)
第一行比对的是 Discord 这一行的写入者。即使整个文件已经被当前网关刷新,也要单独判断这条平台记录。脚本用 systemctl --user 获取 MainPID,作者的 root 定时器需要设置 XDG_RUNTIME_DIR=/run/user/0 才能找到用户总线。
改完后的看门狗每 3 分钟跑一次,网关启动后有 5 分钟宽限期,连续失败 2 次才重启,每小时最多重启 3 次。触发重启或达到上限时,它通过 Discord REST API 发告警,绕开了 bot 自己的连接。
我的判断
我最认同的是把平台健康单独看待。多平台网关允许部分服务继续运行,有它的好处。Webhook 和邮件还能处理工作,没必要为了一个插件启动失败就让所有入口一起停掉。只要 Discord 是用户依赖的入口,健康检查就该能报告它缺失。作者也提出,希望网关原生识别「平台已配置,但没有适配器」的情况。
这套脚本能发现本次故障留下的旧记录,但检查到的是当前进程写下的连接状态,文章没有展示 bot 能否实际收消息并回复。用测试账号发送探测消息再等回复,覆盖范围会更完整,也需要维护测试入口和判定超时。至于 90 秒的加载时限、10 分钟的状态新鲜度和重启阈值,原文没有对照数据,这是作者按自家环境定的经验值。
能拿来做什么
- 给 Node bot 或多通道网关做探活时,在进程检查之外,为用户依赖的平台单独报告健康状态。读取持久化状态时,同时核对更新时间和写入进程,把过期记录视为未知。
- 排查冷启动掉线时,把宿主机重启时间、插件超时、注册返回和实际载入的平台数对齐。调整超时后,尽量在同类冷启动条件下复测,并在升级后核对实际配置。
- 给自愈脚本设启动宽限期、连续失败阈值和重启上限。告警走独立于 bot 会话的请求,并验证 bot 离线时告警是否仍能送达。