本地模型内存预算要算清三笔账
文章将本地推理内存拆为模型权重、KV 缓存与运行开销,并建议保留容量余量。它列出不同量化格式的每参数字节估算,解释量化元数据为何会让实际占用高于标称位宽。
AI 深度解读
本地 LLM 能不能跑,不能只看模型文件大小,也不能只看电脑装了多少内存。作者用 osFoundry 的模型浏览器估算结果,拆出了三个账本:模型权重、上下文缓存、运行开销,并用一台 16 GB 内存的 MacBook M3 核对应用显示值。
这套方法的价值,是让你下载前就能判断:模型能否装下,长上下文会不会挤爆内存,生成速度大概在哪个量级。但其中的安全系数和速度估算,都需要带着前提使用。
模型文件之外,还有两笔内存账
作者给出的判断公式很直接:
need = weights + KV cache + overhead
fits if need <= 0.8 × usable memory
要看第二行:比较对象是「可用内存」,还要再留出 20% 余量,不能直接拿机器标称容量来比。
第一笔是权重,由参数量乘以每个权重占用的字节数得到。量化会降低这个数,但 Q4_K_M 不能直接按每个参数 0.5 字节计算。K-quants 还要给每个小块保存缩放信息,平均约为 4.5 bits,即 0.56 字节。
因此,14B 模型采用 Q4_K_M 时:
14 × 10⁹ × 0.56 = 7.84 × 10⁹ 字节,约为 7.3 GiB。
作者建议,遇到不认识的量化名称,就按 FP16 保守估算。这个办法适合初筛,但不能把它理解成对所有未知格式的绝对保证。
第二笔是 KV cache。模型生成时,会保留上下文中每个 token 的键和值,避免后续重复计算。其大小按下面的公式估算:
2 × layers × kv_heads × head_dim × context_tokens × bytes_per_element
最需要盯住的是 context_tokens,它与缓存大小成正比。
Qwen2.5 14B 有 48 层,采用分组查询注意力(grouped-query attention),KV 头数为 8,每个头的维度为 128。使用 FP16 缓存时,4K 上下文的计算是:
2 × 48 × 8 × 128 × 4096 × 2 字节 = 768 MiB。
上下文增加到 32K,缓存就变成 6 GiB。不注明上下文长度的内存估算,很难拿来选模型。
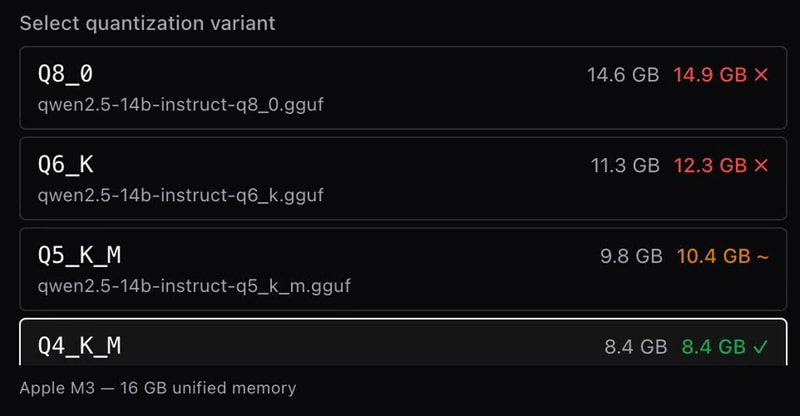
第三笔是运行开销。llama.cpp 需要计算缓冲区和工作空间,作者粗略按「权重的 10% 加约 200 MB」预留,14B 模型约为 0.9 GB。三项相加,Q4_K_M 的 14B 模型落在约 8 至 9 GB,应用显示为 8.4 GB,截图采用的是 4K 上下文。
16 GB 内存,为什么不能按 16 GB 来选
不同硬件的上限不同。
独立 GPU 若要完整承载模型,应先看显存(VRAM)。12 GB 显存不会因为系统内存更多,就自动变成更大的显存池。
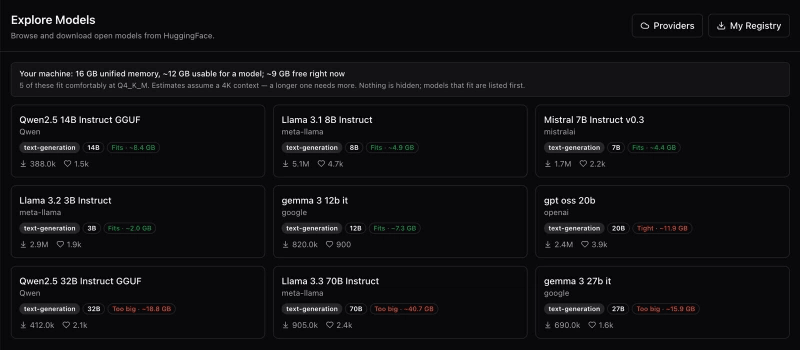
Apple Silicon 使用统一内存,但系统需要空间,GPU 也不能把全部内存拿走。作者用总内存的 75% 作为工作估值,因此 16 GB 机器按约 12 GB 可用内存计算。
接下来再分三档:占可用内存不超过 80%,留有余量;80% 至 100%,比较勉强,建议关闭其他应用;超过 100%,作者认为会进入磁盘交换(swap),速度难以接受。
在这台机器上,14B 模型的估算结果是:
| 量化格式 | 内存需求 | 作者的判断 |
|---|---|---|
| Q4_K_M | 8.4 GB,约 70% | 可以装下 |
| Q5_K_M | 10.4 GB,约 87% | 比较勉强 |
| Q6_K | 12.3 GB | 超出预算 |
| Q8_0 | 14.9 GB | 超出预算 |
同样采用 Q4_K_M 时,20B 模型约需 11.9 GB,已经贴近上限;27B 约需 15.9 GB,超出预算。这里的界线属于这台机器和这套估算条件,不能直接推广到所有 16 GB 电脑。
装得下以后,速度还要看内存带宽
作者的推导是:生成每个 token,都要读取一遍模型权重,因此可以用「内存带宽除以模型大小」估算生成速度上限。
基础款 M3 的内存带宽约为 100 GB/s。按文中的计算,8.4 GB 模型约为 12 tokens/s,4.9 GB 的 8B 模型约为 20 tokens/s。真实速度会更低,但作者认为模型之间的速度比例比较符合这个估计。
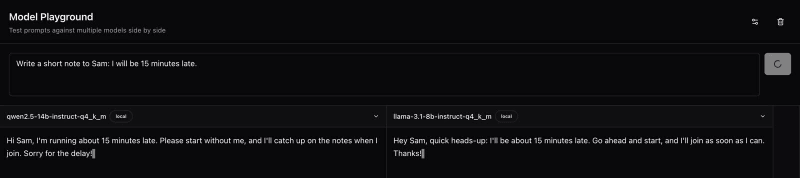
这给选型增加了一个维度:大模型即使勉强装下,也可能让每轮交互等待更久。用于日常编程时,模型能力与响应速度需要一起衡量。
我的判断
我认同把权重、KV cache 和运行开销分开计算。尤其是上下文这一项,能解释为什么同一个模型,短对话正常,塞入较长代码后却可能吃紧。
但原文的验证主要是核对 osFoundry 在一台 MacBook M3 上的显示结果,没有给出完整的实测峰值内存、测试配置和多机器对照。75%、80%,以及「10% 加 200 MB」都应当视为经验预算。
另外,原文混用了 GB 与 GiB,手算时应统一单位。速度部分也有一处近似:推导讲的是读取权重,计算却用了包含缓存和开销的 8.4 GB 总需求,不能把 12 tokens/s 当成严格上限。
「超出预算就会 swap」也不是所有后端的统一行为。原文没有展开加载失败、部分卸载等路径。与只看参数量相比,这套方法更有用;与实际运行测量相比,它仍只是下载前的筛选工具。
能拿来做什么
- 下载本地模型前,按目标量化格式和实际上下文长度计算三项需求,并先确认比较的是显存还是统一内存。
- 给本地 AI 编程工具选择模型时,按准备输入的代码量估算 KV cache,不要直接照搬截图中的 4K 条件。
- 在同一台机器上比较 8B 与 14B 时,同时记录回答质量、生成速度和峰值内存,用实际交互体验决定是否接受更大的模型。