Agent 榜单高分背后:自报成绩与验证缺口
文章检查 Claw-Eval 的 22 条榜单记录,称没有记录标记为已验证,前七名均引用模型卡自报成绩。榜单还混列同系列检查点、量化版本和不同运行模式,直接比较名次容易误判。
AI 深度解读
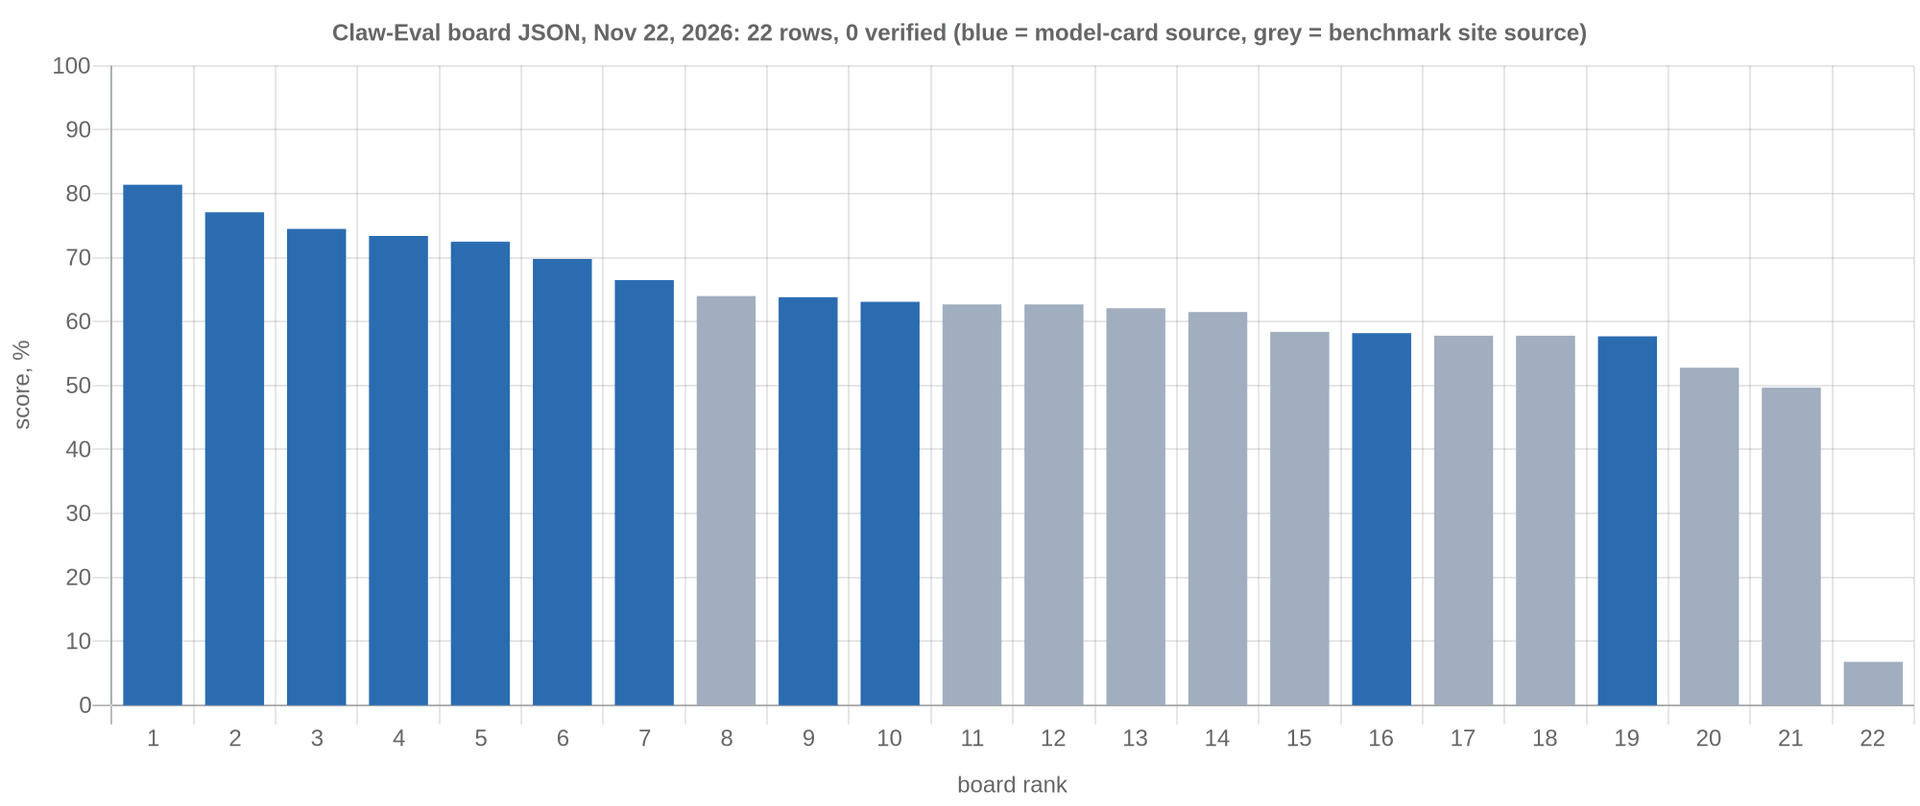
Claw-Eval 在 Hugging Face 上排出的名次,能直接用来选 Agent 模型吗?作者检查了 2026 年 11 月 22 日的榜单:22 条记录里,0 条标为 verified,18 条来自尚未合并的 PR;前 7 名全部引用厂商自己的 model card。
这篇审计最有价值的地方,是把「分数」和「分数的证据」拆开来看。模型可能确实很强,但测试口径、结果来源、重复条目没有交代清楚时,名次还不足以支撑选型。
前七名为什么不能直接和后面比较
Claw-Eval 测的是 Agent:模型在沙箱里操作工具、文件和服务,再由评分器检查任务是否完成。它共有 300 个任务,分为 general 的 161 个、multimodal 的 101 个,以及 multi_turn 的 38 个。general 覆盖通信、金融、运维、生产力等 24 类任务。
Hugging Face 榜单按 general 收录结果。来自基准官网的记录注明了 Pass^3% | N=3 | 161 tasks,但部分 model card 只写一个 Claw-Eval 分数,提交 YAML 的人仍将其归入 general。有条记录甚至明确承认「没有说明具体任务划分」。
这里的 Pass^3 要单独解释:同一个任务独立运行三次,三次全部通过才算成功。它不是三次成绩的平均值,也不能直接与 avg@3 或 pass@1 比较。
22 条记录的来源恰好各占一半:11 条来自 model card,11 条来自基准官网。但位置很不均匀。前 7 名的 66.5 至 81.4 全是 model card 自报结果;官网来源的最高分是第 8 名的 64.0。
例如,Ornith-1.5-397B 的模型卡写了 temp=0.6 and 256K context,却没有说明任务划分、运行次数,以及是否使用 Pass^3。参数披露了一部分,仍不足以确认它与官网记录采用同一套协议。
来源不同并不代表分数有假,但协议没对齐,排序就不能当成统一条件下的比赛结果。
问题还在数据结构上:榜单 JSON 没有专门记录指标、运行次数和 split 的字段,这些信息散落在各条 YAML 的自由文本备注中,而且并非每条都有。
差零点几分,到底差了多少能力
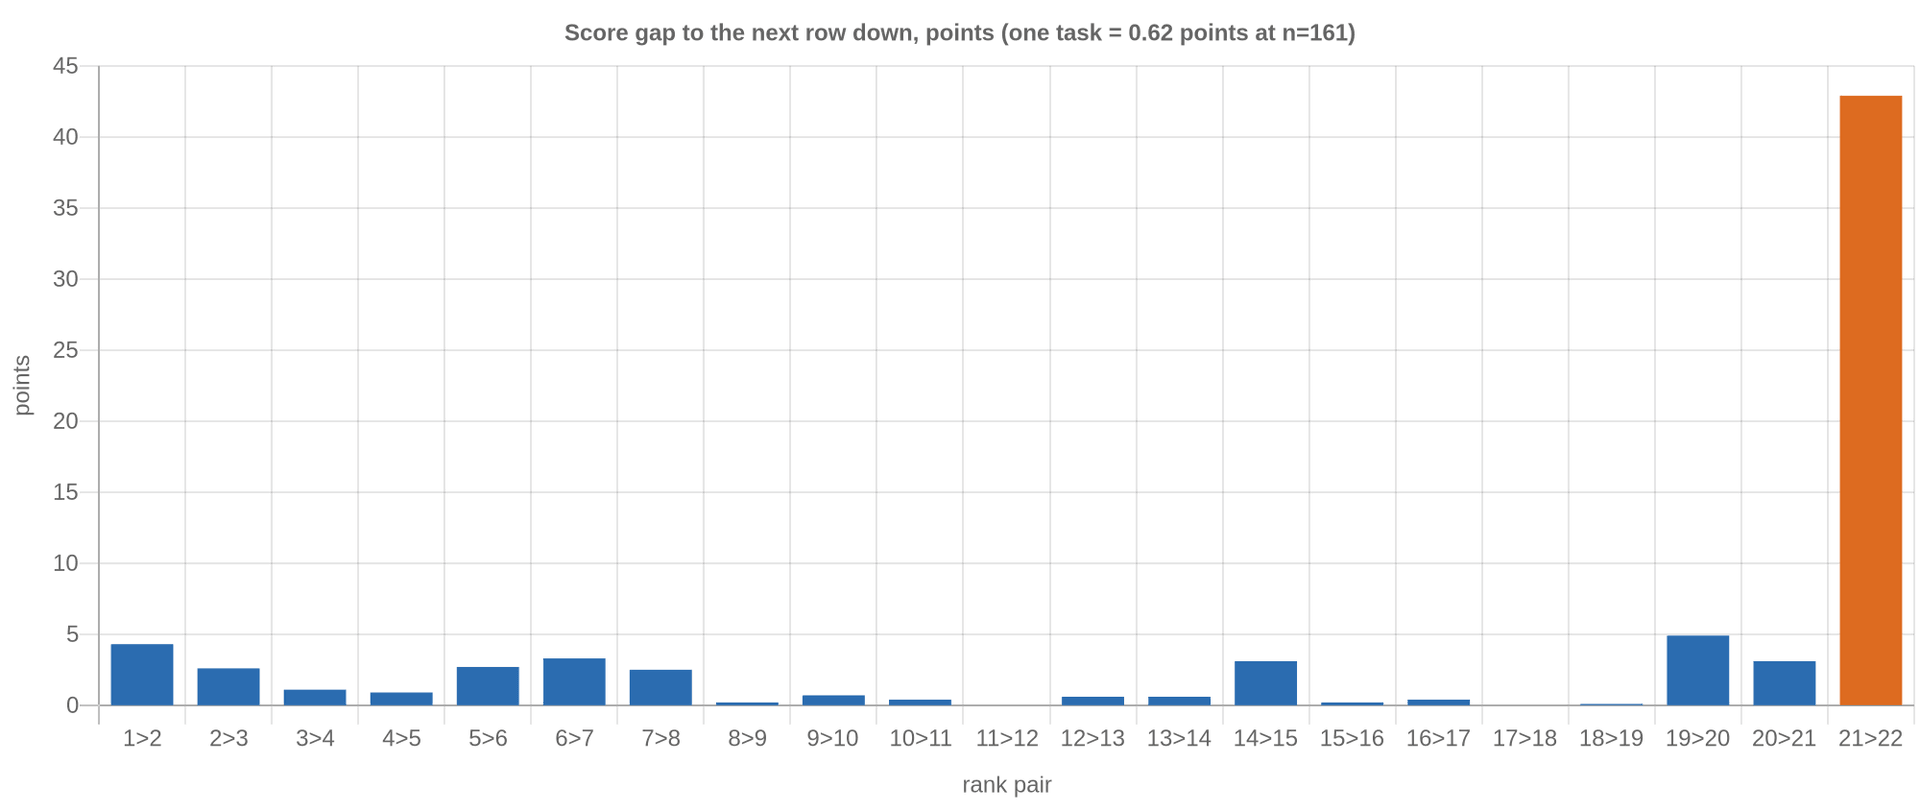
general 只有 161 个任务,一个任务约值 0.62 分。分数显示一位、两位小数,并不代表测量精度也有那么高。
第一名 81.4,第二名 77.1,相差 4.3 分,约为 7 个任务。第 8 名到第 14 名从 64.0 降到 61.5,总共只差 2.5 分,约为 4 个任务。这样的差距值得继续调查,却很难只凭排名宣布谁更可靠。
作者用 n=161 的 Wilson 区间演示了不确定性的量级:81.4 对应的示意范围为 74.7 至 86.7,74.5 对应 67.3 至 80.6,66.5 对应 58.9 至 73.3。第 8 名的范围为 56.3 至 71.0,包含第 9 至第 19 名的分数,也包含第 7 名的分数。
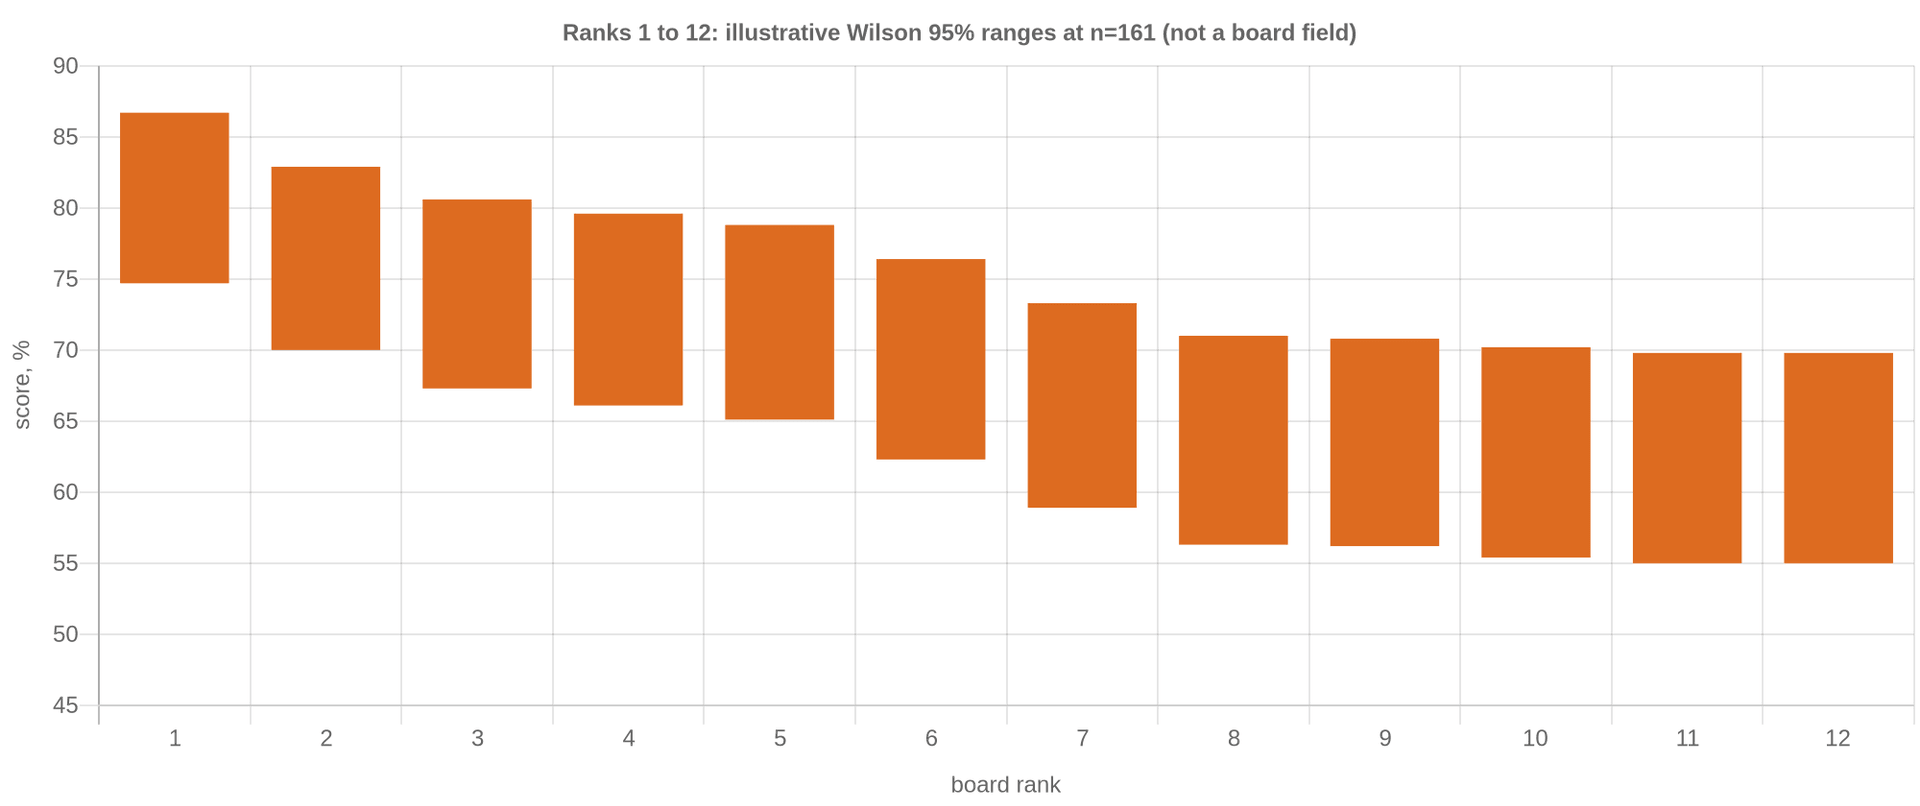
但这不是显著性检验。作者也承认,Pass^3 不能简单当成普通通过率;各模型又是在相同任务上比较,真正的配对分析可能比这些独立区间更精确。榜单没有逐任务数据,无法据此判断小分差是否稳定。
作者还做了整数检查:如果分数来自 161 个任务的一次完整 Pass^3 计数,乘以 161 再除以 100,应该接近整数。22 条里有 14 条距整数不超过 0.1,另有 8 条不符合。
这只能提供线索。Ring-2.6-1T 的 63.82 对应 102.75 个任务,明显不是整数,但 YAML 又明确写了 Pass^3 | N=3 | 161 tasks 和 high reasoning effort。因此,不能把「不接近整数」直接判为异常成绩,具体汇总方式仍需查证。
十个名次不等于十份独立证据
前十名里,Ornith 占了第 1、2、5、6、7、10 名,共 6 席,涉及 1.0、1.5 两代,以及 397B、35B、9B 等规模。按厂商计算,前十其实只有 Ornith、MiniMax、dots、Xiaomi、inclusionAI 五家。
多型号上榜没有问题。问题是,读者容易把同一实验室、相似测试设置下的一组结果,误读成十份独立来源的验证。
下面这段原始脚本可以统计榜单条数、verified 标记、PR 来源和前十模型的命名空间:
import json, math, urllib.request
from collections import Counter

URL = "https://huggingface.co/api/datasets/claw-eval/Claw-Eval/leaderboard"
req = urllib.request.Request(URL, headers={"User-Agent": "board-audit"})
rows = json.load(urllib.request.urlopen(req))

N = 161  # general 划分中的任务数
print("rows:", len(rows), "verified:", sum(r["verified"] for r in rows),
      "open PRs:", sum(1 for r in rows if r.get("pullRequest")))
print(Counter(r["source"]["name"].lower().endswith("model card") for r in rows))
top10 = rows[:10]
print(Counter(r["modelId"].split("/")[0] for r in top10))
print("one task =", round(100 / N, 2), "points")
要留意 rows[:10]:它沿用 API 返回的顺序;modelId 的命名空间统计也只是检查入口,是否属于同一厂商仍需核对。
重复结果比厂商集中更容易影响判断。第 11 名 zai-org/GLM-5.1 和第 12 名量化社区仓库 INCModel3/GLM-5.1-MXFP4-Mixed-CT-AutoRound 都是 62.7。两者 YAML 的日期、备注、提交者相同,参数量也同为 753,864,139,008。作者据此判断,量化仓库继承了基础模型的成绩,没有提供独立运行证据。
同一模型的不同模式也混在一起。openpangu/openPangu-2.0-Flash 在第 16 名和第 19 名各出现一次,分别为 58.2、57.7。模型卡对应的是 Non-Thinking 和 Thinking,前者高 0.5 分,但榜单没有模式列。
参数量字段同样需要核验。num_parameters 把 Ornith-1.0-35B 写成 664,944,把 Ornith-1.0-9B 写成 1,469,680。直接拿这些数据画「参数规模与能力」散点图,会把两个模型放进不足 200 万参数的区域。
我的判断
作者说得最有说服力的,是榜单把不同证据强度、不同运行模式和继承成绩压进了同一个排名列。这些都有具体字段或记录支撑,对选型的影响比「第一名领先多少」更直接。
但有两处需要收紧理解。第一,0 条 verified 说明当前快照没有记录带这个标记,不能据此推断所有结果都不可信;18 条来自开放 PR,也不能直接等同于提交错误。原文没有展开平台的完整审核流程。
第二,Wilson 区间重叠不能证明模型没有差异。作者也提示了局限,但「这些名次无法区分」更准确的读法应是:仅凭当前榜单公开的信息,无法确认差异,而不是已经证明差异不显著。
最后一名 Nemotron 的 6.8 比前一名 49.7 低了 42.9 分,作者猜测可能与评测框架或输出格式不匹配有关。他没有检查那次运行,这只能保留为假设。
这张榜适合发现候选模型,不能独自承担最终选型。
相较只看总榜,先按来源、指标和模式分组更有用;相较完整自建评测,榜单又能降低初筛成本。至于「差距不到 5 个任务、约 3 分就视为同一档」,这是方便筛选的经验规则,原文没有提供对照实验来证明这个阈值普遍适用。
能拿来做什么
- 给日常 AI 编程或工具调用 Agent 选模型时,先用榜单建立候选集,再确认成绩对应的 split、Pass^3、N=3、161 tasks 和运行模式。只写「Claw-Eval」的模型卡,暂时只能当作待补充材料。
- 比较相邻模型时,把分差除以 0.62,先理解它相当于几个任务。若候选之间只差少量任务,就用自己实际需要的工具调用和任务流程复测。
- 用 Python 或 Node 整理榜单数据时,保留
source、verified、pullRequest和模式信息,并单独标记继承的量化成绩。同一个数字出现两次,不应被当成两次成功验证。 - 如果团队准备测试量化版本,就对实际部署的量化产物重新运行任务。基础模型的 62.7 不能替代量化版本的测量,参数量也应回到模型文件和配置核对。