Claude Sonnet 4.5 将停用,迁移需回归
据文中援引的 Anthropic 弃用时间表,Sonnet 4.5 将于 2026 年 11 月 30 日停用,推荐迁至 Sonnet 5.5。旧请求参数可能触发 400 错误,默认推理、词元计数和工具调用行为也有变化。
AI 深度解读
Claude Sonnet 4.5 将于 2026 年 11 月 30 日在 Anthropic 运营的平台退役。届时,指向旧模型的请求会失败,也没有自动切换。迁移还涉及请求参数、响应结构和 token 预算。只改模型 ID,有些请求会直接报 400,有些会返回 200,却让页面读不到正文或让工单漏掉分类。
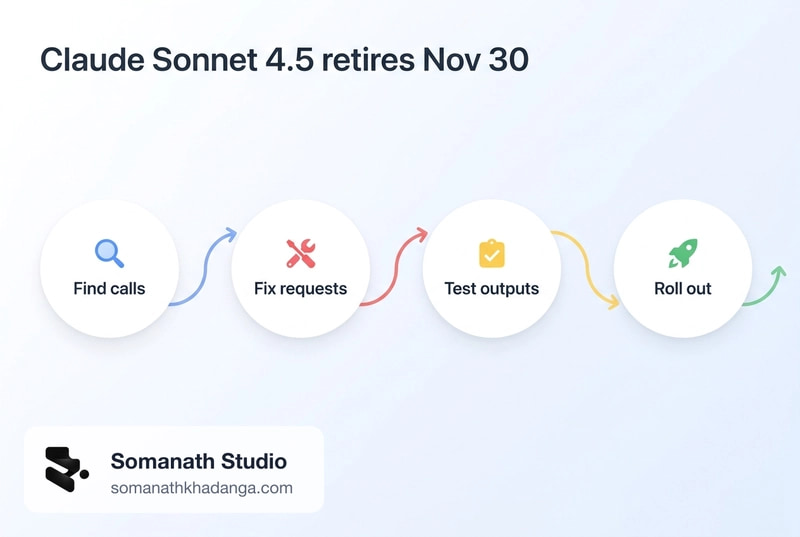
这份指南最值得借鉴的是它的验收方式。先找齐旧模型的调用,再分别验证接口能否跑通、业务结果是否合格,最后用灰度验证成本和延迟。回滚也有期限,退役之后要切到另一个已经测过的在役模型。
哪些调用会在 11 月 30 日后失败?
原文援引 Anthropic 的退役清单,claude-sonnet-4-5-20250929 于 2026 年 9 月 30 日进入弃用状态,11 月 30 日退役,推荐替代型号是 claude-sonnet-5-5。这个日期适用于 Claude API、Claude Platform on AWS、由 Anthropic 托管的 Claude Models on Google Cloud,以及 Microsoft Foundry。Amazon Bedrock 和由 Google 托管的 Claude Models on Google Cloud 各有时间表,要看实际接入平台的模型卡或生命周期页面。原文还提醒,Bedrock 的 Legacy 模型闲置 15 天后,现有客户可能失去访问权限,低频任务也得纳入盘点。
作者建议先在 Anthropic Console 的 Usage 页点 Export。导出的 CSV 按 API key 和模型拆分用量,可以先定位哪些 key 仍在发旧流量,再去找对应服务。下面两条命令分别搜索旧模型名称和迁移时需要检查的请求设置。
git grep -nE "claude-sonnet-4-5|claude-sonnet-4\.5|sonnet-4-5" -- . ':!*.lock'
git grep -nE "budget_tokens|temperature|top_p|top_k|tool_choice|output_format|interleaved-thinking|fine-grained-tool-streaming" -- . ':!*.lock'
第二条命令专门查参数和 beta 标记。两条命令都只覆盖仓库里的内容,像 tenants.ai_model 这样的数据库字段还要单独查。队列 worker、CI 评估脚本、内部工具、Slack bot、按租户或套餐生效的配置、运行时开关和 fallback 链都可能藏着旧调用。每处记下负责人、发送的参数、是否走工具或图片,以及验收方式,后面就能按业务逐项切换。
哪些旧参数会直接触发 400?
先清理采样参数。按原文转述,API 版本 2026-10-21 移除了 temperature、top_p 和 top_k。即使用较早的 API 版本,Claude 4.7 及以后的模型也会拒绝这些参数的非默认值。工单分类里常见的 temperature: 0 得删掉。其余要逐项检查的还有固定思考预算 budget_tokens、预先塞入一段助手回复的 assistant prefill、强制 tool_choice 和 thinking 的 disabled 类型。结构化输出从 output_format 迁到 output_config.format,同时移除 interleaved-thinking-2025-05-14 和旧的上下文窗口 beta 请求头。
下面这段 TypeScript 用工单分类展示了怎么改 client.messages.create,包括把强制调用 label_ticket 改成 auto 配合 strict tool。
// Before (Sonnet 4.5)
await client.messages.create({
  model: "claude-sonnet-4-5-20250929",
  max_tokens: 200,
  temperature: 0,
  tool_choice: { type: "tool", name: "label_ticket" },
  tools: [labelTicketTool],
  messages,
});

// After (Sonnet 5.5)
await client.messages.create({
  model: process.env.TRIAGE_MODEL, // "claude-sonnet-5-5"
  max_tokens: 1024, // illustrative: recount for your prompts
  thinking: { type: "between_tools" },
  output_config: { effort: "low" },
  tool_choice: { type: "auto" },
  tools: [{ ...labelTicketTool, strict: true }],
  messages, // system prompt now says: "Always answer by calling label_ticket."
});
注意 tool_choice: { type: "auto" } 这一行。模型仍可直接作答,strict: true 约束的是工具被调用时的参数结构。Schema 里的每个对象都要有 additionalProperties: false,每次请求最多带 20 个 strict tools。提示词可以说明何时调用,业务代码仍要处理没有工具调用的情况。示例把 max_tokens 从 200 改成 1024,后一项是演示值,实际预算要重测。
为什么返回 200,功能也可能出问题?
Sonnet 4.5 省略 thinking 时直接作答,Sonnet 5.5 默认启用自适应思考(adaptive thinking)。响应可能先出现 thinking block,直接取 response.content[0].text 的代码就可能读不到正文。按 type 遍历 content 才能取对内容。工具循环里要把 thinking block 原样传回,包括空块,并且只在会话末尾追加消息。工具参数的转义也可能变化,交给标准 JSON 解析器处理。
思考 token 按输出 token 计费,也占 max_tokens。工具调用之间较长的说明会进入 thinking block,默认省略其中的文字,原来展示这些说明的界面可能突然安静下来。如果产品要展示思考摘要,可以设 display: "summarized"。拒绝响应也应有单独的界面状态。Sonnet 5.5 会在更多类别下返回 stop_reason: "refusal",原文提到它新增了实时网络安全防护,处理安全相关内容的产品应专门测这条路径。
按原文引用的迁移指南,同样的文本在 Sonnet 5.5 上大约多出 30% 的 token,具体看内容。一张 2000×1500 的图片大约用掉 Sonnet 4.5 的 2.5 倍 token。做截图或文档处理的功能,要用 token counting endpoint 重算输入开销,再检查截断策略、租户配额和价格假设。对分类、抽取等看重延迟的任务,原文建议试 thinking: { "type": "between_tools" },它只接受 low、medium、high 三档 effort。Claude API 默认是 high,聊天可从 medium 或 low 试起,目标明确的 Agent 任务可从 medium 起步。旧思考预算没有固定的档位换算,作者建议实测两到三档。
怎么验收、灰度和回滚?
先给每个调用在 staging 发一次真实请求,覆盖工具调用、图片、流式输出和 token counting endpoint。计数接口同样会拒绝强制 tool_choice。然后拿固定的一批代表性输入比较新旧输出。分类看标签准确率,抽取看 Schema 是否通过,摘要看结论能否从输入找到依据,Agent 则核对工具调用和最终状态。顺手记录输入 token、含思考的输出 token 和延迟,用旧模型的用量做基线。拒绝、max_tokens 截断、工具报错和长对话超出上下文都要单独走一遍。
模型 ID 可以按业务集中配置,发布顺序从内部工具和评估任务开始,再到后台任务,最后到面向用户的功能。用户侧按流量百分比或租户灰度,按状态码看错误率,同时监控拒绝率、输出 token、延迟和现有质量指标,比如点踩或人工修改率。作者建议在 11 月 30 日前几天完成,给遗漏调用留出排查时间。
退役前可以恢复旧模型配置,并从版本控制恢复对应请求结构。退役后,Anthropic 运营的平台上旧 ID 已经失效,回滚旧部署也会重新带入失败请求。原文举的在役备选是 claude-sonnet-4-6,按其引用的清单,最早退役日期是 2027 年 2 月 17 日。这个备选也拒绝 assistant prefill,2026-10-21 版 API 对所有模型移除采样参数,同样需要提前跑契约测试。
我的判断
我认可把接口兼容和输出质量分开验收。尤其是原先靠强制工具调用拿 JSON 的业务,换成 auto 后,光测几条 Schema 合法的样例容易漏掉真正的故障。要把「返回 200 但没有 tool_use」纳入验收,并确认工单最终有没有拿到标签。
30% 和 2.5 倍来自作者引用的迁移指南。原文没有给出他们团队用真实业务流量跑出的质量、延迟或成本对照数据。「一两天能发」是对单人负责、只有一两处简单调用且手上已有样例的经验估计。调用散在租户配置和队列里的团队,先估盘点与回归成本更实际。把模型 ID 收到配置里能缩短灰度和回滚操作,每个业务的请求构造与响应解析仍要单独验收。
能拿来做什么
- 把 Usage CSV 里的 API key 对到 Node 服务和 worker,再查租户配置、运行时开关和 fallback 链,给每处旧模型调用补上负责人和验收样例。
- 检查前端是否直接读取
response.content[0].text,用 thinking block 排在首位的响应跑一遍页面,再验证stop_reason: "refusal"能显示明确的状态。 - 给工单分类或结构化抽取补一条「请求成功但模型没调用工具」的用例,把工具调用缺失和参数 Schema 校验失败都计入验收。
- 给生产灰度准备一个已通过契约测试的在役备选模型,并用代表性提示词和截图重测 token,按租户观察开销、延迟和错误率。