Claude双新模型强化编程与复杂推理
Anthropic 发布 Claude Fable 5.2 和 Mythos 5.2,分别面向广泛用户与经过验证的组织开放。公司称新模型在物理问题、网络安全和操作系统构建上有所突破,并承担了其核心代码中超过九成的合并改动。
AI 深度解读
Anthropic 在 IPO 前推出 Claude Fable 5.2 和 Mythos 5.2,把旗舰模型的成绩又往前推了一截:综合评测领先,漏洞发现能力增强,还展示了约 1,000 个智能体协作完成数学证明形式化的案例。但对程序员来说,真正需要判断的是:这些进步能否覆盖自己的任务,以及多花的钱是否值得。
The Decoder 这篇报道给出的答案有两面。Fable 5.2 的综合领先有第三方评测支撑,但日常终端编程并未全面胜出;安全、数学和自主协作方面的亮眼结果,则主要来自 Anthropic 自己的测试。
综合第一,为什么还不该直接替换日常模型
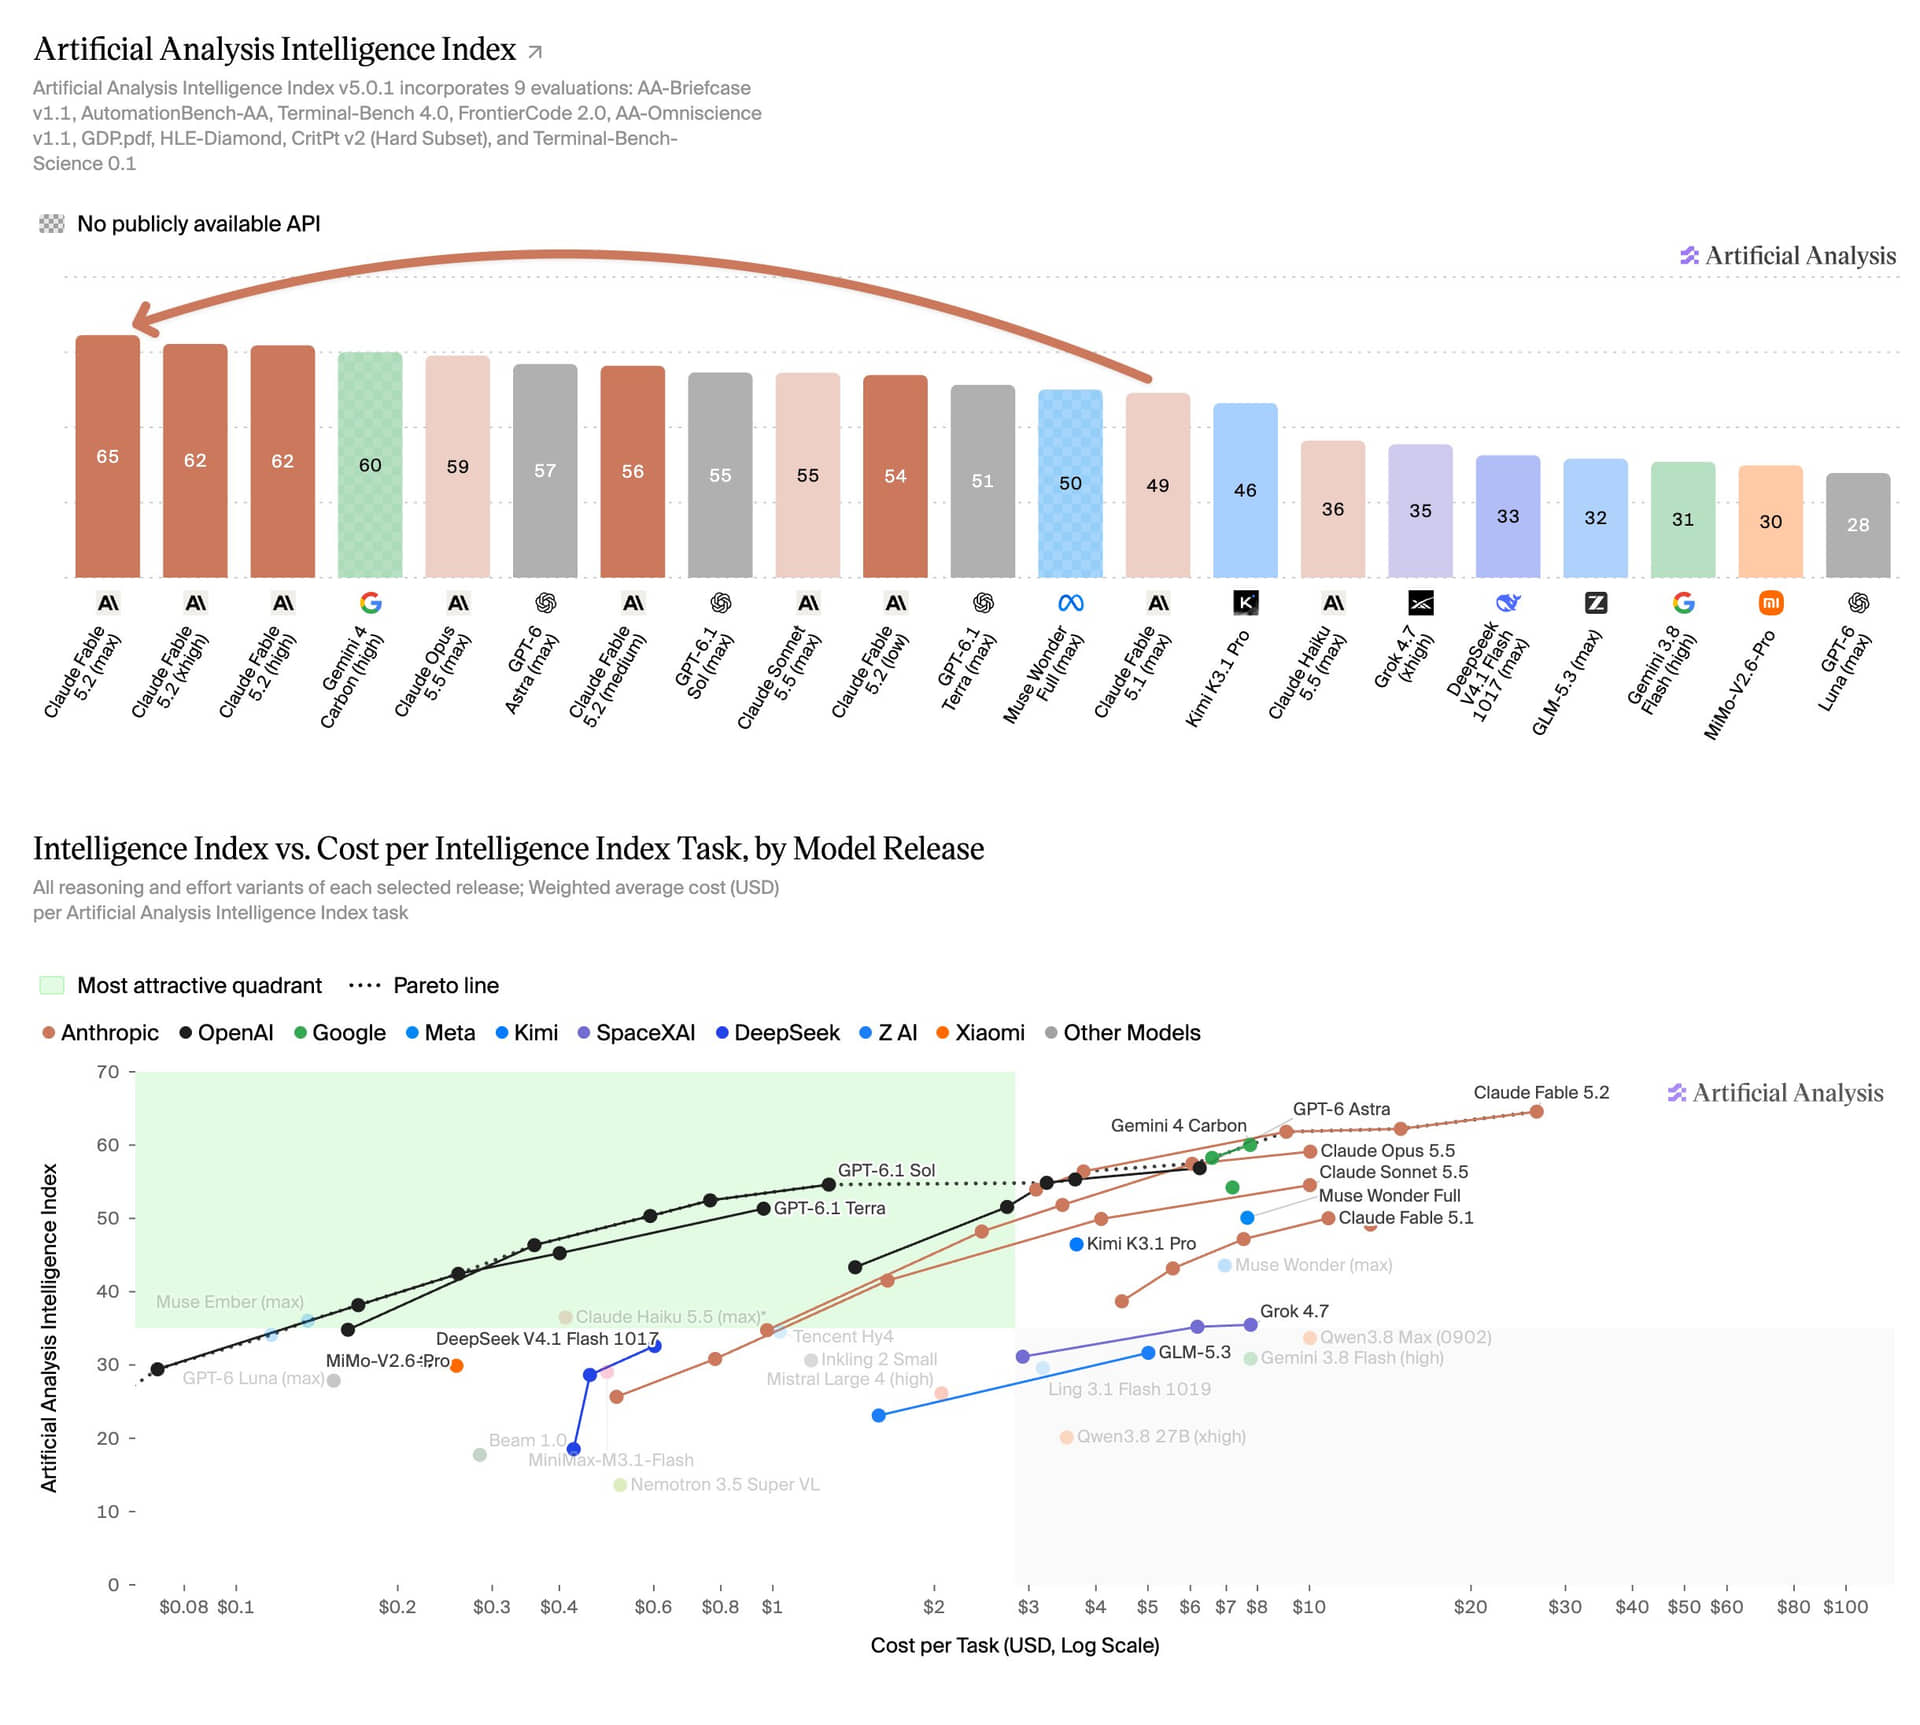
Fable 5.2 在 Artificial Analysis Intelligence Index v5 最高计算档拿到 65 分,比尚未发布的 Gemini 4 Carbon 高 5 分,比 Opus 5.5 高 6 分,比 9 月初推出的 Fable 5.1 高 15 分。对应的对手成绩分别是 Gemini 的 High 档 60 分、Opus 的 Max 档 59 分。
它在 9 项测试中的 5 项拿到最佳成绩,包括专家级学术问答 HLE-Diamond 的 80%、终端科学工作流 Terminal-Bench-Science 的 73%,以及真实开源项目代码修改测试 FrontierCode 2.0 的 49%。
不过,把综合榜首理解成「所有开发任务都更强」,会选错模型。
在多步骤知识工作测试 AA-Briefcase 中,Fable 5.2 得到 1,785 Elo,低于 Sonnet 5.5 的 1,813,与 Opus 5.5 的 1,800 处于置信区间内,无法据此确认显著差异。在软件开发、安全等多步骤终端任务组成的 Terminal-Bench 4.0 中,它拿到 60%,与 Opus 5.5 持平,落后于 Kimi K3.1 Pro 的 67%、Gemini 4 Carbon 的 65% 和 Sonnet 5.5 的 64%。
综合能力领先,不等于你的代码仓库任务也会同比变好。
成本也需要拆开看。新模型每百万输入、输出 token 分别收费 8 美元和 40 美元,低于前代的 10 美元和 50 美元;但最高档评测的平均单任务成本达到 26.50 美元,约为 Opus 5.5 的 2.6 倍,也约为 Fable 5.1 的两倍。两者对应成本分别是 10 美元和 12.99 美元。
好消息是,Fable 5.2 在 High、Xhigh 较低计算档仍有 62 分,超过其他模型任意档位。报道给出的输出消耗为每任务 98,000 tokens,低于 Opus 5.5 Max 档的 173,000。但这是不同模型、不同档位的比较,不能直接拿来估算自己的账单。
Anthropic 称,新模型输出速度比 Fable 5.1、Mythos 5.1 最多快 30%。面向部分组织的可选 fast mode 最多再将 token 输出速度提高到 2.5 倍,价格翻倍,仅在包括 Claude Code、Claude Platform、Google Cloud、Microsoft Foundry 在内的部分平台提供。这里说的是输出速度,不能当成完整任务耗时同比缩短。
Fable 和 Mythos 的区别,主要在可访问的能力范围
Fable 5.2 与 Mythos 5.2 使用相同模型基础,但开放方式不同。Fable 面向所有用户,设置了网络安全和生物领域的限制;Mythos 移除了其中部分限制,仅向通过 Anthropic 网络安全或生命科学 Verification Programs 申请的组织开放。
这对安全开发工作很关键。报道说,Fable 会阻止大多数安全相关任务,包括渗透测试和 exploit 代码生成;被拦截的网络安全请求改由 Opus 4.8 响应,生物领域请求改由 Opus 5 响应。因此,选择了新旗舰,并不保证每类请求都由它执行。
Mythos 的主要证据来自内部测试 CVE Rediscovery。测试把项目回退到漏洞修复前,让模型独立找出已经登记在 CVE 数据库中的漏洞,相当于检查它能否重新发现已知问题。
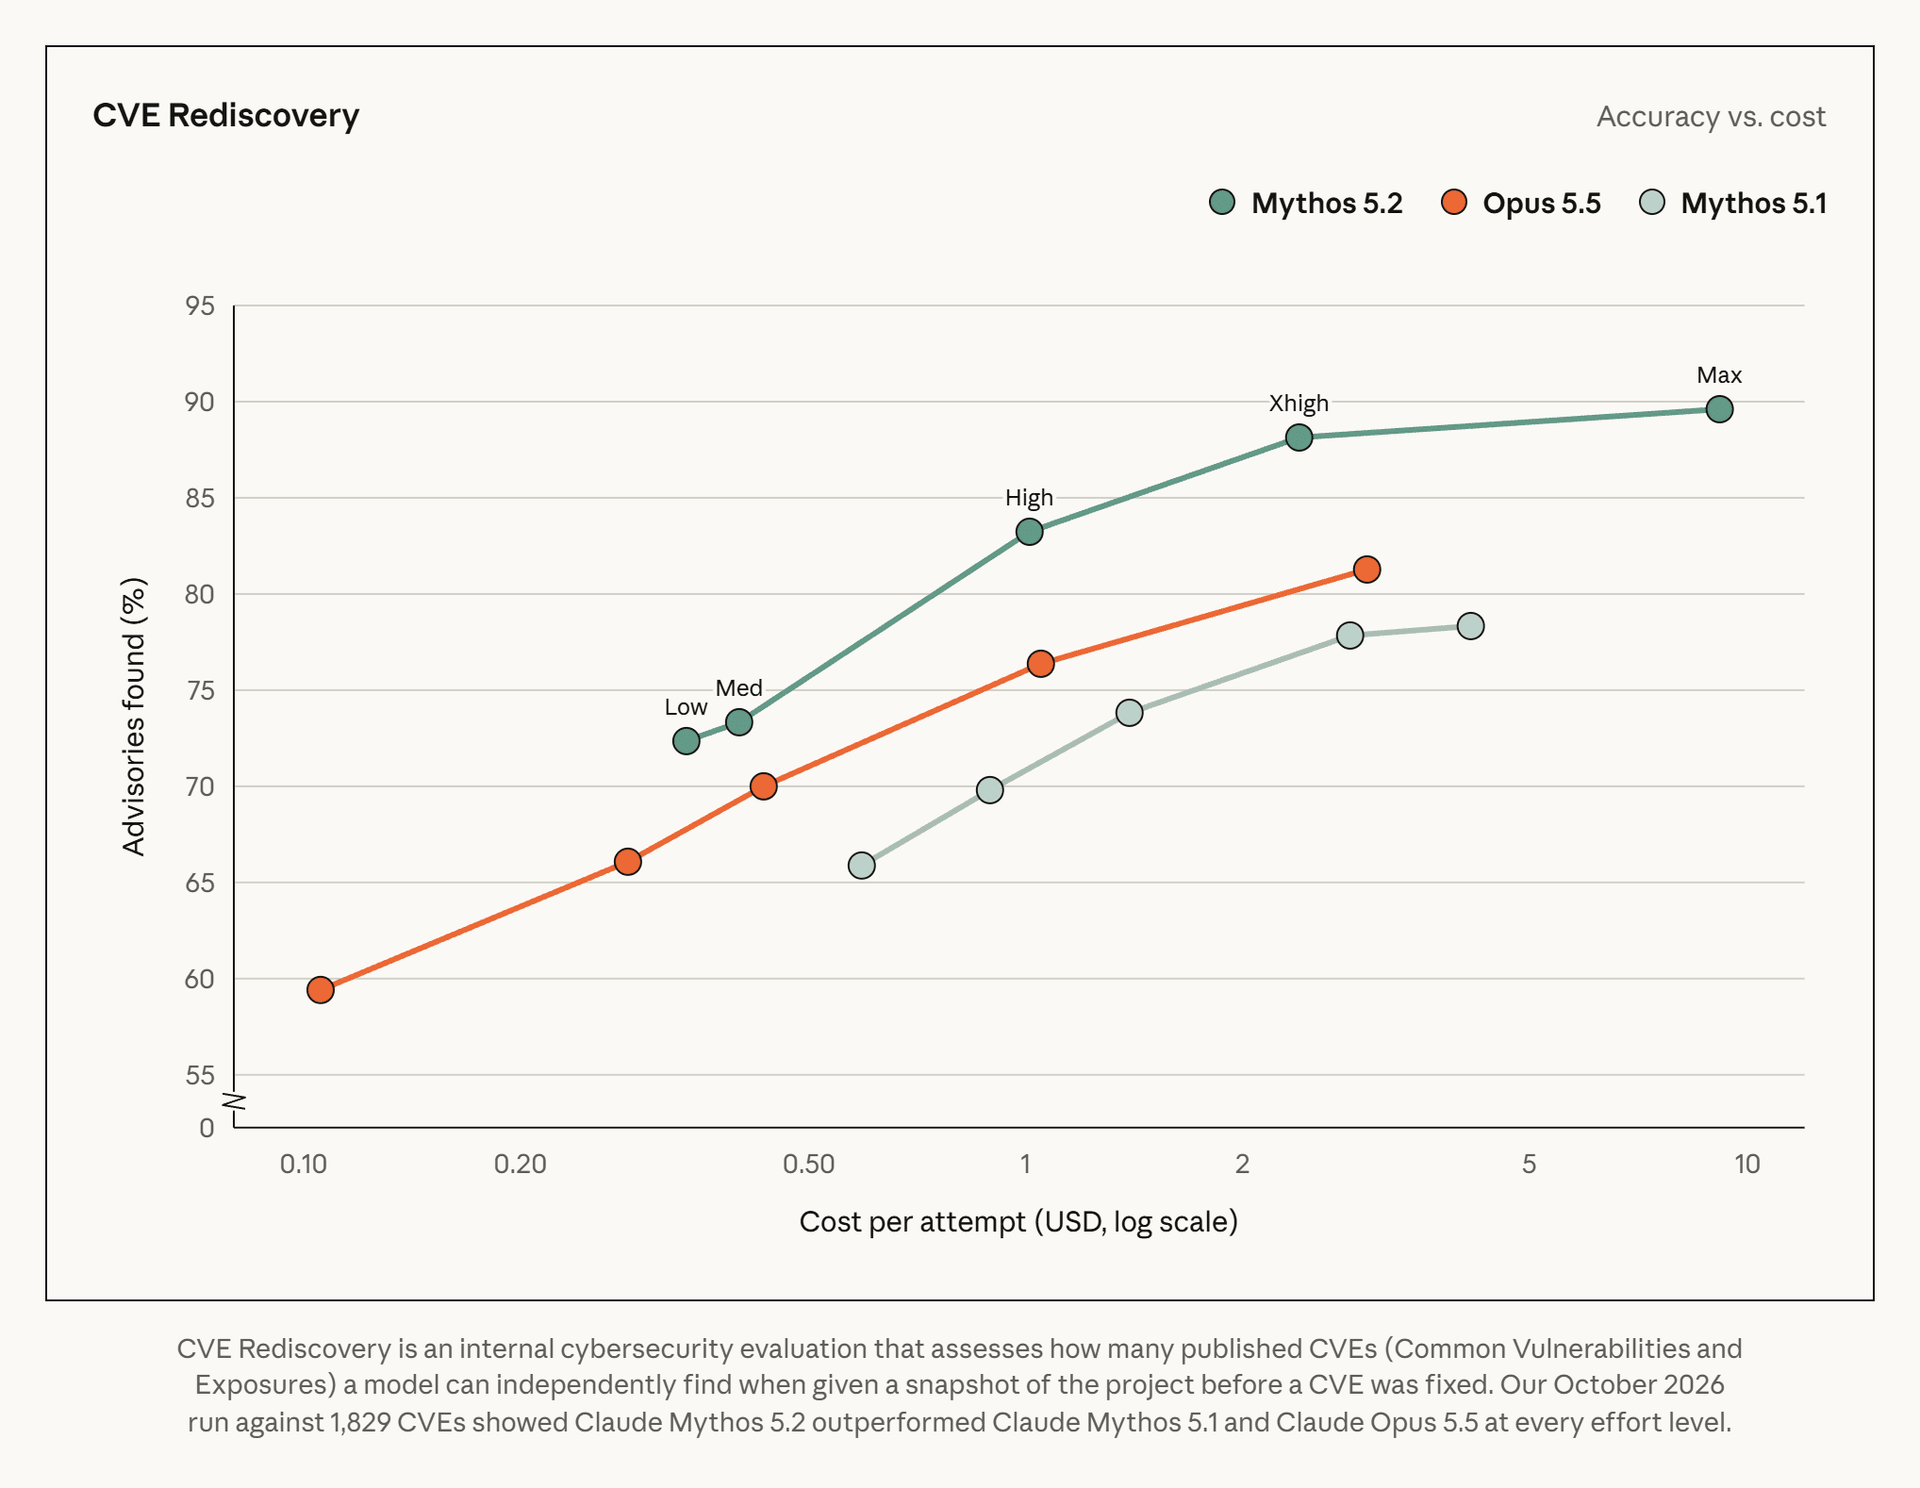
在 2026 年 10 月、包含 1,829 个 CVE 的测试中,Anthropic 称 Mythos 5.2 发现的漏洞数量比 Opus 5.5 多 10.2%,比 Mythos 5.1 多 14.4%,并且在每个计算档位都领先。另据 Anthropic 转述,一家安全公司确认的 Mythos 5.2 所发现漏洞中,每 6 个就有 1 个被其他受测前沿模型全部漏掉。
这些结果支持「它能补充现有模型的漏洞发现覆盖」,但还不能直接推出真实项目中的投入产出比。原文没有交代误报率、人工确认成本,也没有展开那家安全公司的测试范围。
限制 AI 自我改进,和千智能体证明有什么关系
Anthropic 还强调,训练时刻意限制了最可能直接加速 AI 开发的能力,即报道所说的 RSI 相关能力,例如为加速器芯片优化计算内核、改进大语言模型架构。按公司的说法,Fable 5.2、Mythos 5.2 在这些方向与 Opus 5.5 大致相当。
它同时表示,智能体编程、硬件开发、传统 AI 研究及可解释性研究没有受到影响。问题在于,这些领域彼此相邻,限制边界如何划定、如何验证,原文没有讲清楚。
公司给出的能力展示很强:在人类指导下,Claude 已编写其核心代码库超过 90% 的合入变更,还在内部测试中从零编写了一个操作系统。但报道没有给出变更规模、审核成本或操作系统的功能范围,不能据此估算普通团队能减少多少开发工作。
更具体的展示是费马大定理的形式化。约 1,000 个 Fable 5.2 智能体在 30 小时内,把证明转成 Lean 能逐步检查的形式。这里完成的是对证明的机器化表达与验证,并非首次提出数学证明;Andrew Wiles 已在 1995 年给出百余页的证明。
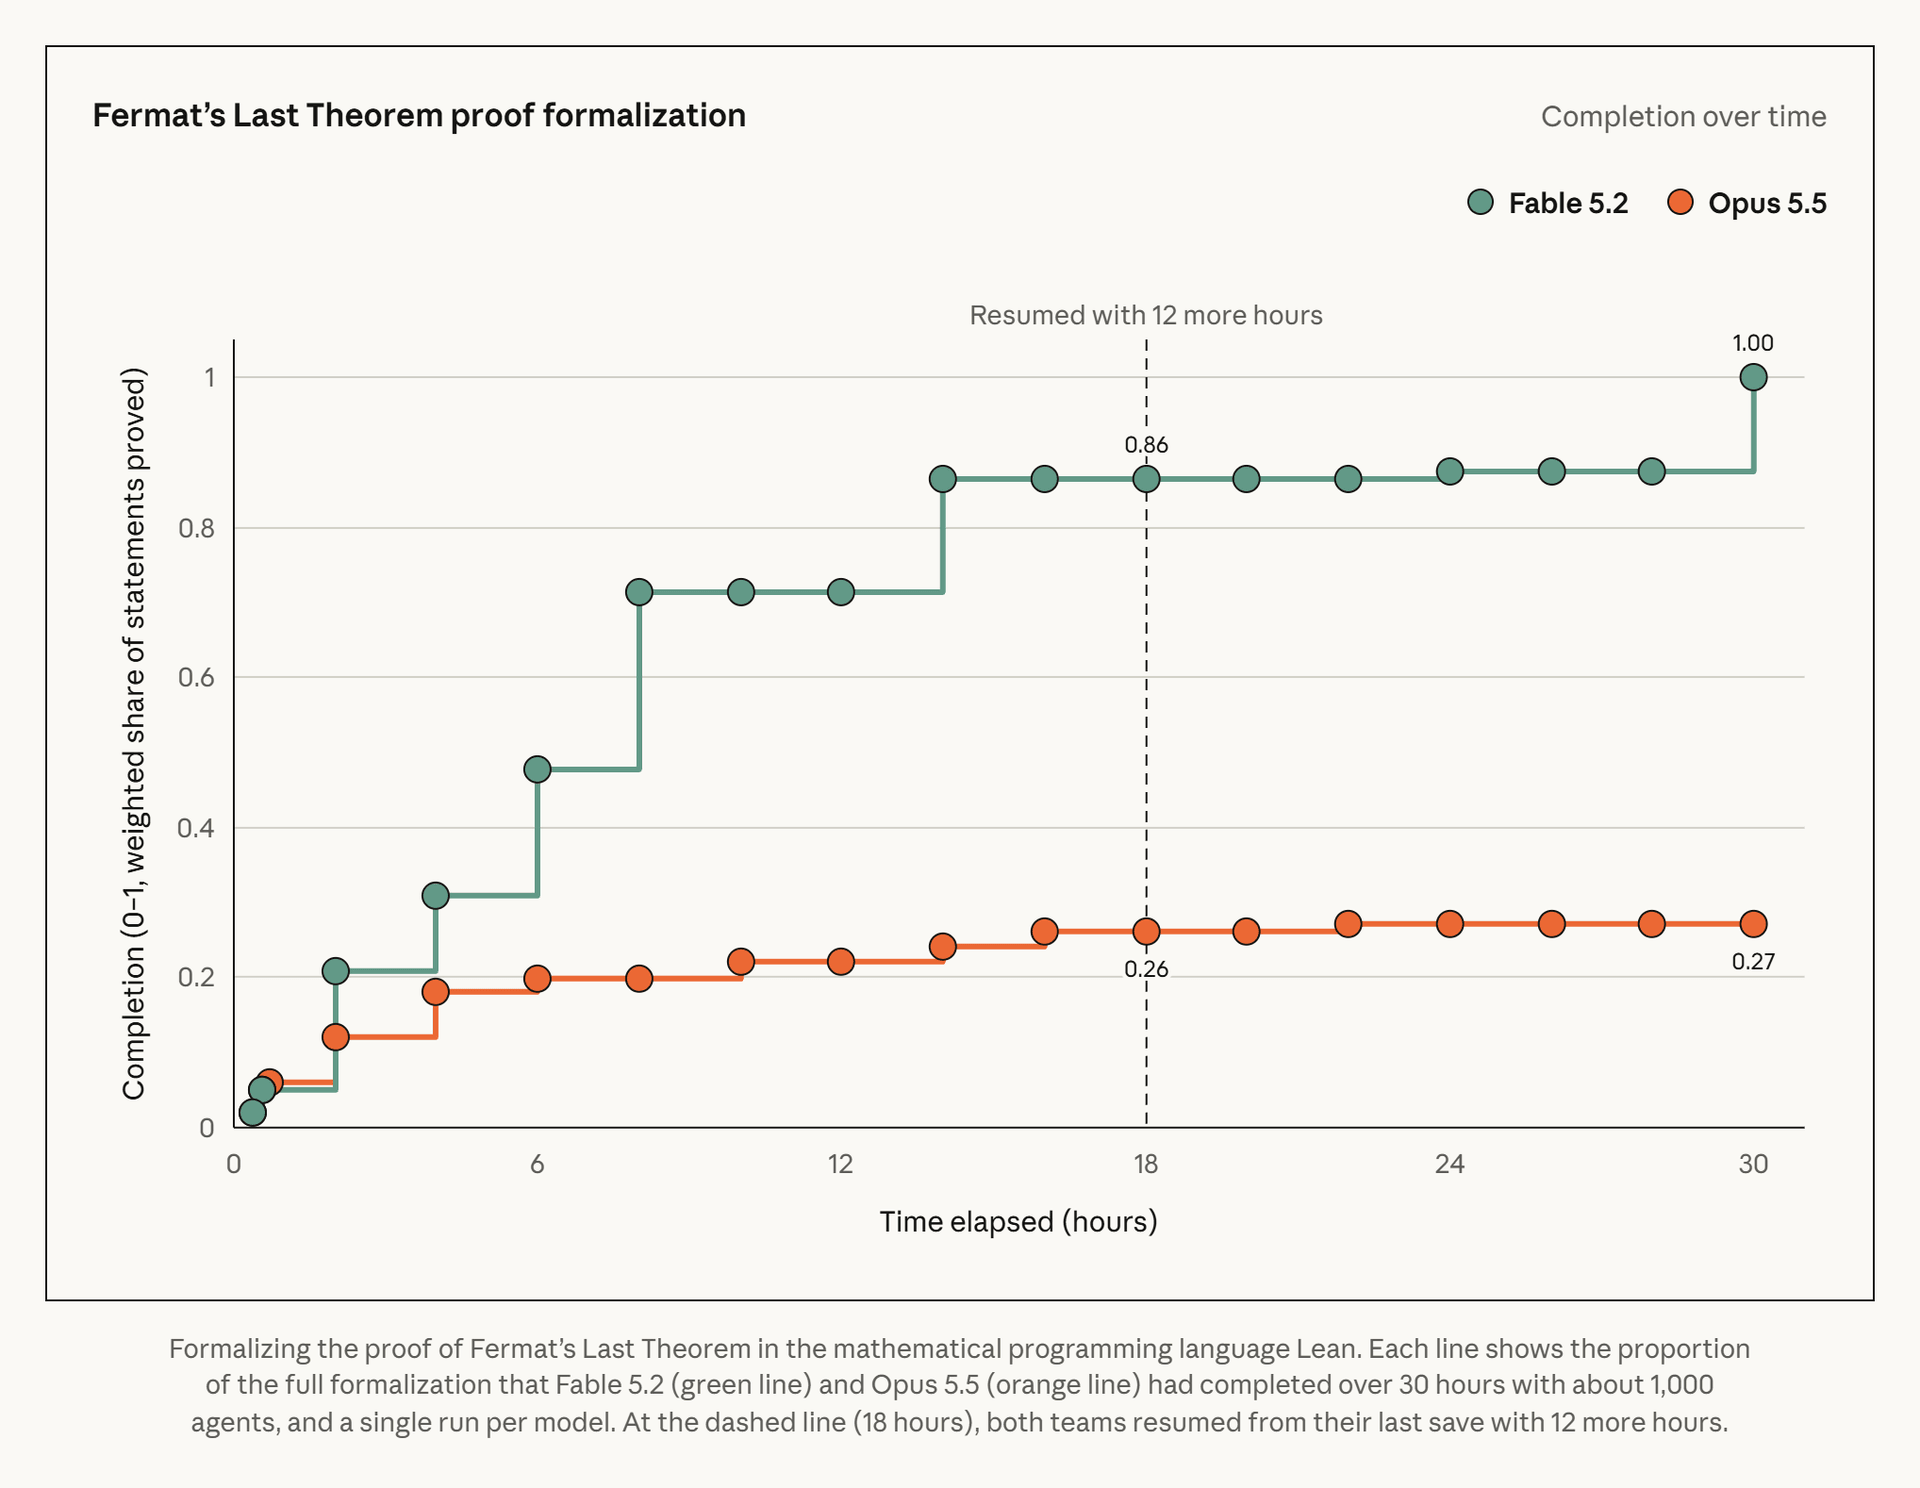
Anthropic 称,此前一个未发布研究版本需要 11 天,还依赖专门环境和研究人员指导。此次 Fable 5.2 从简短指令出发,自行组织协作,不使用数学参考资料,以中间引理清单衡量进度;action tokens 用量为首次尝试的三分之一,生成的证明长度为其七分之一。
同一环境下,1,000 个 Opus 5.5 智能体在 18 小时完成约 26%,延长到 30 小时后几乎没有推进,图中最终约为 0.27。
这个案例最有启发的地方,是任务有明确的机器检查标准。每个中间结果能否成立,可以交给 Lean 验证。它比「让一群智能体自由讨论,最后交一份答案」更容易判断进展,但总成本、失败尝试和验证细节,报道仍未完整披露。
我的判断
我更认可这篇报道中按任务拆开的评测,而不是标题里的全面领先判断。第三方综合榜单能说明能力上限,但 Terminal-Bench 4.0 已经提醒开发者:换成最贵旗舰,日常终端任务也未必更好。Anthropic 自己仍推荐 Opus 5.5 用于日常工作,这个定位与数据并不冲突。
安全和数学结果值得关注,不过证据层级要分清。前者是内部已知漏洞重发现,后者是内部形式化实验;它们都有具体方法和数字,比空泛宣传更可讨论,但仍需要更多独立复现。关于限制 RSI 的有效性,原文提供的主要是公司声明。
对普通团队,更合理的选择是按任务升级模型,而不是按发布顺序升级默认配置。
相比全量切换,保留日常模型、把复杂任务交给更高档模型,更符合报道呈现的能力与成本差异。这是基于现有数据的取舍,不是已经被文中团队对照实验验证的最佳方案。
能拿来做什么
- 给日常 AI 编程建立一组真实任务,覆盖仓库修改、多步骤终端操作和复杂问题分析,比较完成质量、人工返工时间与总费用,再决定哪些任务需要 Fable 5.2。
- 试用 Fable 5.2 时先评估 High、Xhigh 档。原文显示它们仍有较高综合成绩,但是否适合你的任务,需要结合完整调用账单判断。
- 做授权安全评估前,确认 Fable 的任务限制与 Mythos 的申请条件,并记录实际响应模型,避免把不同模型的结果混在一起比较。
- 设计多智能体编程流程时,优先挑选能自动验收的子任务,用编译、测试或明确检查规则约束交付结果,再评估增加智能体数量是否有收益。