将聊天记忆存成固定大小文件
MemT-1.0-Nano允许将指定轮次写入固定大小的记忆状态,再保存并载入新会话;文中测试文件约41.9MB,重载后九道回忆题全部答对。哪些轮次进入记忆由应用逻辑决定,其余轮次仍作为普通文本保留。
AI 深度解读
聊天记录能不能存成一个文件,下次加载后继续记事,不必每轮重发整段对话?MemTensor 的开放模型 MemT-1.0-Nano 提供了一条可运行的路径:把指定轮次写入固定大小的记忆状态,再保存到磁盘。作者把文件载入一个消息数为零的新会话,9 道回忆题全部答对。
但这还不能证明它能替代聊天记录库。41.9 MB 的固定文件、省显存的推算、长期记忆的准确率,是三个不同问题。对做 AI 应用的程序员,这篇最有用的是把接口、成本和部署坑放到了一起。
模型记什么,仍然由业务代码决定
MemT-1.0-Nano 的基座是 Qwen 团队的 Qwen3.6-35B-A3B。它允许把指定轮次折叠进一块不会增长的数字状态,原文文本随后从会话中丢弃。未指定的轮次仍按普通文本保留。
MemTensor 的 modeling_memt.py 把这件事设计成显式调用。下面这段展示了写入、保存和恢复的完整路径:
session.chat("<facts to remember>", enable_memory=True, enable_thinking=False)
session.save_state("dana.safetensors")
restored = model.create_session(tokenizer, state="dana.safetensors")
print(len(restored.messages))  # 0
要看第一行的 enable_memory=True:它决定这一轮是否进入记忆状态。最后的 0 则说明,恢复后没有靠消息列表携带旧文本。
固定的是记忆块,整个会话的输入并不会自动保持固定。
作者恢复会话后连续问了 4 个问题,由于这些问题没有标记为记忆,文本继续累积,每次提问的输入从 27 tokens 增至 210 tokens。Token 是模型读取文本时使用的片段;如果始终不设置标记,对话历史依然会越攒越长。
所以业务层还得判断:哪些事实需要长期保留,哪些只是临时讨论。文件管理也要自己处理,save_state 默认不会覆盖已有文件,需要提前设计命名规则。
41.9 MB 节省的到底是什么
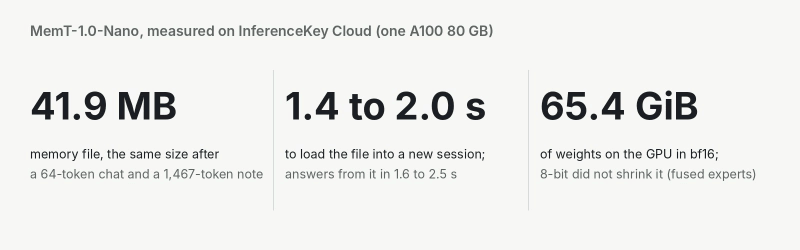
测试中,每个状态文件都是 41,944,024 bytes,约 41.9 MB。无论写入的是 64-token 聊天还是 1,467-token 笔记,文件大小都一样。
这对短对话甚至是负担。测试里虚构面包店主的历史只有 107 tokens,存成文本不过几百字节。
它要比较的对象,是普通模型读取完整历史后,在 GPU 上建立并维持的工作状态,而不是磁盘上的文本文件。按 MemTensor 研究文章的计算,历史超过约 2,000 tokens,固定状态才开始有空间优势;到 128K tokens 时,约小 64 倍。
速度则是另一条曲线。论文称 Nano 在短历史下更慢,接近 32,000 tokens 时持平,到 128K 时约快 1.86 倍。这些空间和速度优势来自研究文章,作者这次测试没有验证。
作者实测的是一张 A100 80 GB 上的保存和恢复:加载耗时 1.35 至 1.99 秒,保存耗时 0.66 至 1.02 秒。使用原版 Hugging Face 代码,未启用可选 GPU 加速组件,也没有调优,一次「记住」轮次生成 128 tokens,约需 13 秒。
因此,不能用「文件固定大小」直接推出「聊天更快」。实际延迟还包括加载、写入记忆和生成回答。
接进服务之前,先算清显卡、加载和许可证
最容易误判的是量化。权重通常使用 bf16,即 16 位数值格式,但切到 8-bit 并没有让模型适配更小显卡。
作者用显存上限模拟 48 GB 显卡,8-bit 加载申请约 64 GiB 后耗尽显存;取消限制后虽然加载成功,第一次「记住」调用又遇到 dtype,也就是数值类型不匹配。
原因在模型结构:每层有 256 个专家子网络,存储形式是融合的三维参数,而不是 nn.Linear。bitsandbytes 的 8-bit 处理跳过了这些参数,最终只省约 2 GiB。作者没有尝试其他压缩方法;在没有官方压缩版本的前提下,试点仍应按 80 GB GPU 预算。
加载路径也有坑。trust_remote_code 允许 Transformers 执行模型自带的 Python 文件。直接指定 Hugging Face 缓存快照目录时,Transformers 沿 modeling_memt.py 的符号链接进入 blobs/,相对导入随之报「file not found」。作者的修复方式是使用 repo id,并固定 revision。
服务层还得处理文件出口。InferenceKey 后端的结果载荷上限是 8 MB,装不下状态文件,所以文件留在 worker,也就是 GPU 机器上的执行程序所在磁盘,API 只返回大小和 sha256。
许可证不能只看权重。Nano 权重采用 Apache-2.0,允许商用;MemTensor GitHub 代码,包括双 GPU 的 memt-sglang 服务,采用 PolyForm Noncommercial 1.0.0。此次测试走的是 Hugging Face 仓库中的 Apache-2.0 代码,也是较慢的路径。
我的判断
这个实验证明了一个明确能力:记忆状态能保存、跨会话恢复,并支持短事实回忆。9 题全对很有价值,但题目都是刚刚提供的简短事实,不能外推到数月对话。
更关键的参照是 LongMemEval-S:论文中 Nano 得分 32.6,发送完整对话得分 76.8。MemTensor 也承认,文本记忆系统仍然领先,尤其是从长历史里寻找精确细节。
如果业务需要准确找回早期约定、日期或配置,文本存储仍有明显价值:原文可以重新检索、核对。固定状态提供的是另一种成本取舍,还没有证明能全面替代它。
实验边界也很清楚:长期反复写入是否挤掉旧事实、多会话并发会怎样,都未验证。作者使用本地 InferenceKey 测试副本和云 GPU worker,托管端点也没有测试。现有结果适合支撑试点,距离生产容量结论还有差距。
能拿来做什么
- 做日常 AI 编程助手时,先用真实项目历史验证早期配置、接口约定等细节的回忆能力,并与文本存储或完整历史对照,别只测刚写入的事实。
- 在业务层明确
enable_memory=True的触发条件,记录未标记消息的增长,避免误以为接入后就不用管理上下文。 - 通过 Node 后端封装服务时,分别测量加载、保存和回答延迟,并处理状态文件命名、持久化与 worker 重建后的恢复。
- 试点先覆盖连续记忆写入和多会话请求,再依据实测结果决定是否投入 80 GB GPU,同时分别核对权重与服务代码的许可证。