用 Celery 隔离长耗时机器学习任务
文章讨论将同步 Web 接口与长耗时 ML、LLM 任务分离,通过容器化 Celery 工作进程承担异步执行。重点围绕网关超时、线程耗尽和资源争用,介绍其与分布式推理集群的集成及部署思路。
AI 深度解读
耗时几秒到几分钟的 AI 任务,如果一直占着 HTTP 请求,先出问题的可能是网关和 Web 服务。作者给出的架构是:接口接收任务后立即返回 HTTP 202 和任务编号,由容器里的 Celery worker 排队执行,再调用独立的 LLM 推理集群。
这篇值得读的地方,是把任务调度、显存管理和部署隔离串在了一起。不过,它更接近一份架构建议:列出了不少配置和规模数字,却没有给出压测方法、吞吐量或故障恢复记录。理解设计思路,比照抄参数更有用。
长任务为什么要从 HTTP 请求里搬出去
多页表单实体提取、文档摘要、大规模文献抓取、神经翻译,都可能运行很久。同步等待会让连接和服务资源持续被占用,最终遇到 API 网关超时、worker 线程耗尽或资源争抢。
作者把系统拆成两层:Web 接口负责接单,Celery 负责执行。客户端拿到 HTTP 202(Accepted),只代表任务已受理,后续还要凭任务编号获取状态和结果。原文没有交代查询、推送、取消和结果过期机制,真正落地时仍需补齐。
拆开之后,两层可以分别扩容。API 看 HTTP 请求量和网络吞吐;任务池看队列深度、CPU 利用率和 GPU 显存余量。入口流量平稳时,后台也可能因大文档集中到来而积压。
容器还承担业务隔离。原文举例,生产 pod 分配 7.5 CPU 核和 15 GB RAM,QA pod 分配 3.9 CPU 核和 15 GB RAM;销售、法务等业务也可以使用独立任务池,减少彼此争抢资源。
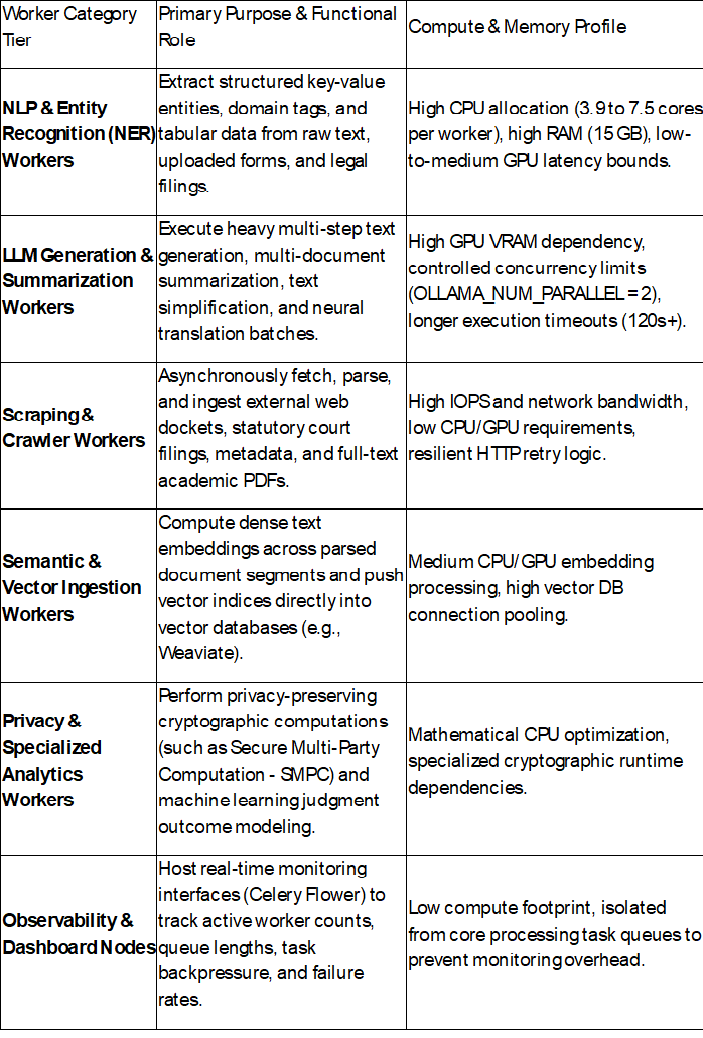
作者用 -dev 表示开发或预发布环境,-e1 表示靠近用户的区域低延迟实例,-e4 表示高内存、多 GPU 的批处理实例。这些是文中的命名约定,不能当作 Celery 的行业标准。
Celery 的几个参数,决定任务怎么排、失败后怎么办
长短差异大的任务混在一起,容易出现分配不均。原文拿 200 毫秒的短实体提取和 120 秒的多文档摘要作比较:某个 worker 提前取走多个长任务,其他 worker 即使空闲,也接不到这些已被预留的工作。
作者给出的配置如下。原文把它们写在同一行,适合当配置项清单阅读:
CELERYD_PREFETCH_MULTIPLIER = 1 CELERY_ACKS_LATE = True CELERY_TASK_TIME_LIMIT = 300 CELERY_TASK_SOFT_TIME_LIMIT = 240
要重点看 CELERYD_PREFETCH_MULTIPLIER = 1:它限制预取倍数,但原文把效果描述成「一个 worker 一次只接一个任务」,过于简化。实际预取量还与并发槽位、确认策略有关,不能据此推断整个 worker 只执行一个任务。
CELERY_ACKS_LATE = True 则把确认时机推迟到任务执行之后,降低任务刚取出、worker 就崩溃带来的丢失风险。不过,延迟确认不等于任务只会执行一次。 任务可能执行过又被重新投递,写数据库、扣额度或生成文件的操作需要幂等设计。不同退出方式能否触发重新入队,也要结合 broker 和 worker 的相关配置验证。
超时分两道:240 秒软限制留给任务处理异常和清理资源,300 秒硬限制用于终止失控任务。这里还要区分 Celery 进程和远端推理服务:终止前者,未必会自动取消 Ollama 中已经开始的计算。原文没有说明取消如何传递。
容器能缩小故障影响范围,但多个容器如果仍共享同一张 GPU,显存耗尽仍可能相互影响。资源边界需要靠实际部署来落实。
推理集群的瓶颈,往往在显存和排队
原文列出的服务规模包括 17 个 NER 实例、20 个 Summarizer 实例,以及 21 个 Ollama 节点。NER 是命名实体识别,用来从文本中提取人名、机构等信息。这些数字说明示例系统的组成,不能证明这套配置能处理多少请求。
请求先经过 KONG API Gateway,采用最少连接算法(Least Connection Algorithm)分发,再进入服务和任务队列。对于 7.5 核与 3.9 核这类容量不同的实例,作者提出通过插件设置容量权重,例如给高容量实例 2x 权重。
连接数却不直接等于后台负载。接口快速返回 202 后,连接已经释放,GPU 上的任务可能仍在运行。网关负责入口分配,队列和推理节点还需要各自的调度机制。
Ollama 承载的模型包括 qwen3:8b、bge-m3、qwen3:4b-instruct、gemma3:4b 和 llama3.2。作者建议:
- 常用推理与 embedding 模型使用
OLLAMA_KEEP_ALIVE = -1,保持驻留。 - 次要模型使用
OLLAMA_KEEP_ALIVE = 5m,并以OLLAMA_MAX_LOADED_MODELS = 3限制加载数量。 - NER 设置
OLLAMA_NUM_PARALLEL = 4、30s timeout;摘要设置OLLAMA_NUM_PARALLEL = 2、120s timeout。
这些配置的目的,是减少模型反复装卸和显存争抢。但「最多加载 3 个模型」并不是显存预算:模型大小、上下文长度和并发请求都会影响占用。原文也没说清 30s、120s timeout 配在哪一层,不能直接当成 Ollama 环境变量使用。
配套设施包括 Weaviate 存储向量、共享 NFS 或定时同步任务保持模型权重一致,以及 OpenTelemetry 配合 Jaeger 追踪网关、排队、推理和网络耗时。Flower 独立部署,用于查看 Celery 状态。
检查显存时,作者给出了这条命令:
watch -n 1 nvidia-smi --query-gpu=memory.used,memory.free --format=csv
其中 -n 1 表示每秒刷新;它能展示显存占用变化,但仅凭这段输出,还不能认定存在显存泄漏。
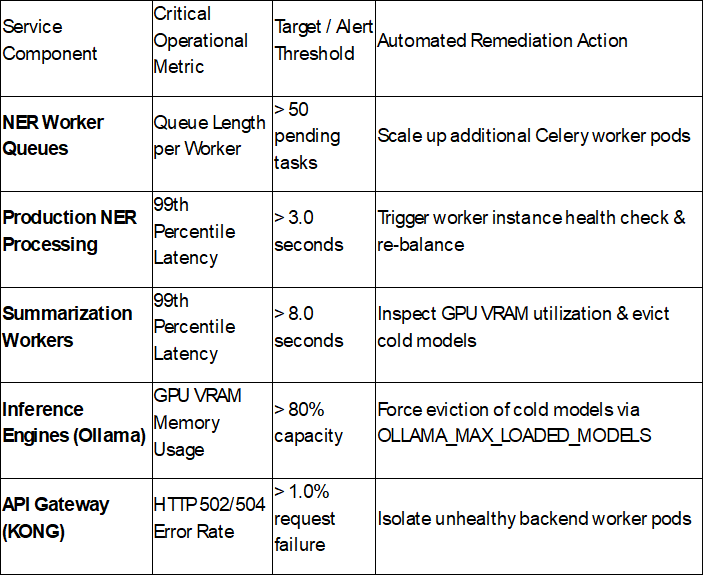
部署上,本地方案使用 Docker Compose 或 Kubernetes,配合 CPU 亲和性、内存限制和 NFS、NVMe 存储;示例中为生产预留 5 个高容量 pod。Azure 方案使用 AKS,并通过 KEDA 提供的队列深度指标驱动 HPA,模型放在 Azure Files 或 Managed Disks,推理节点使用 GPU 虚拟机规模集。
混合容灾则让 Azure 上的入口经 ExpressRoute 或 VPN 连接本地算力,故障时转向云端 worker。但只切入口还不够:broker、任务状态、模型和结果存储如何在故障后继续可用,原文没有展开。
我的判断
我认同把长任务从同步接口中拆出来,也认同按任务特征分池。对文档处理服务而言,排队通常比无限增加 Web 并发更容易控制资源。
但这不是一份经过充分验证的容量方案。原文没有给出硬件型号、文档长度分布、吞吐、尾延迟或恢复时间;7.5 核、并发 4、21 个节点等数字,只能当作示例。正文还有重复段落,部分技术描述也需要补充条件。
和简单的同步调用相比,这套设计换来了独立扩缩容与故障隔离,也增加了 broker、任务状态管理、幂等和观测成本。如果只是短请求、低流量推理,未必需要一次引入整套基础设施。已有 Node 服务的团队若使用其他后台队列,同样可以采用接口接单、后台执行的分工;选择 Celery 更应考虑 Python 任务生态和现有运维能力。
可以直接借鉴的是职责划分,配置值需要用自己的负载验证。
能拿来做什么
- 给文档摘要或批量提取接口设计任务协议:提交后返回 202 和任务编号,前端明确展示排队、执行、成功与失败,避免一直挂着加载状态。
- 将短实体提取和长摘要分到不同队列,分别测量等待时间、执行时间与显存占用,再决定并发和超时。
- 在启用延迟确认前,给任务增加业务唯一标识,检查重复执行时是否会重复写入结果或产生副作用,并验证 worker 崩溃后的行为。
- 先把 API、任务队列和推理请求串进同一条追踪链路。定位慢在排队还是生成之后,再决定扩 worker 还是加推理资源。