用预定义操作手册约束运维智能体写入
Escalane 将故障处置判断与执行权限分开,模型只能选择已有操作手册或上报,并回答变更安全性问题。执行层掌管命令参数、锁、试运行和结果验证,以降低遥测数据中的提示注入触发任意命令的风险。
AI 深度解读
运维 Agent 看见 PHP 服务报 502,可以建议重启 PHP-FPM。真正要管住的是下一步:谁有权决定现在能不能重启,谁来填写命令参数?Escalane 把模型限制在预先登记的操作目录里,由执行框架检查权限和风险,再按固定模板组装命令。
作者用一次本地实跑展示了这条边界。模型选中了合法的操作,置信度也很高,流程仍然转给了人工。这套设计对写 AI 运维脚本的开发者有参考价值,也留下了一个问题:拦截够严时,系统还能自动处理多少事故?
模型选处置方案,执行框架管命令参数
作者在 2026 年 11 月 6–12 日的 MLH Global Hack Week: Builders Week 做了 Escalane。它把一次运维处置拆成三个决定:应该选哪类方案、当前主机能不能动、具体怎么执行。常见的自由工具调用会让模型同时回答这三个问题。只要工具最终接到了 shell,监控数据里的提示注入就可能影响真正执行的命令。
Escalane 的入口只接收故障症状,拒绝看起来像命令的字段。决策后端 System One 读取清理过的状态数据,以约定格式返回 playbook 选择、置信度和评分。playbook 是事先登记的一种处置方案。模型可选目录中的方案,也可上报。通过安全检查后,执行框架才用目录模板和状态里绑定的参数组装 shell 参数。模型能选操作,命令参数由执行框架填写。
限定输出格式只能保证答案长得符合约定。即便模型选的是一个真实存在的重启方案,也还得判断这次重启的影响范围,以及这个选择是否可靠。
选中了合法方案,为什么还要人工审核?
--gate-config 控制检查的严格程度。A0 到 A3 按顺序运行,每一级都能在执行前否决操作。
- A0 检查所选 playbook 是否在目录中。
- A1 检查
noul所表示的置信度是否足够。 - A2 检查潜在影响范围是否可接受。
- A3 检查拟合得到的逐标签精确率是否达标。可以把它理解成,模型过去报出某个处置标签时,有多大比例确实报对了。未达标就转人工审核(HITL)。
下面的命令用本地 Ollama 上的 d3:4b 对 PHP 502 样例做一次真实决策,只判断,不改主机。
uv sync
uv run escalane decide \
  --backend ollama \
  --model d3:4b \
  --require-live \
  --state src/escalane/examples/incidents/php_502.json \
  --catalog datasets/sysops_decide/catalog.yaml \
  --gate-config A3
其中 --require-live 要求真实后端可用。后端掉线时,CLI 会直接失败,避免自动退回 mock 后还被当成一次真实验证。
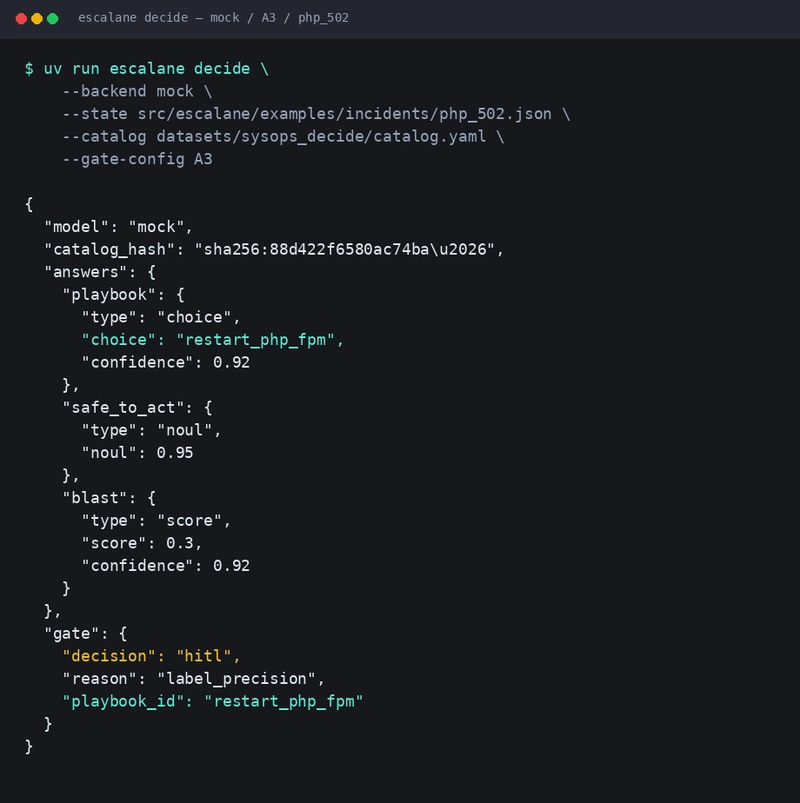
作者保留了这次实跑的关键输出,可以直接看出流程停在哪一关。
{
  "model": "d3:4b",
  "backend": "ollama",
  "playbook": "restart_php_fpm",
  "noul": 0.9878,
  "blast_score": 0.9822,
  "gate_decision": "hitl",
  "gate_reason": "label_precision",
  "dry_run_only": true
}
看 gate_reason 这一行。restart_php_fpm 在目录里,noul 达到 0.9878,但 A3 仍因 label_precision 转人工。单次回答的置信度和某个标签在样本上的精确率,是两个不同的判断依据。
默认预演,真正写入要过两道授权
Escalane 默认以 dry-run 运行。允许写入需要同时传入 CLI 参数 --allow-writes,并设置环境变量 ALLOW_WRITE_OPERATIONS=true。这两个开关负责授予写入权限,A0–A3 负责判断某一次动作是否应该放行。
作者用 Python 和 uv 搭 CLI,通过 httpx 访问本地后端,用 Ollama 或 LM Studio 跑决策模型,也保留了离线 mock 来验证流程接线。decide、run、replay 是作者优先固定下来的 CLI 入口。作者提到,CI 在 mock 上跑绿,只能说明这条流程接通了。模型如何处理真实事故输入,得让真实后端跑一遍才看得出来。
我的判断
我认同作者对命令参数来源的约束。自由工具调用接起来快,只给模型套一层 JSON Schema 也能过滤一部分非法输出。但只要字符串参数还能由模型自由填写,而且会流进 shell,风险就还在。目录方案要为每类操作维护模板和参数来源,适合重启、回滚这类能预先规定步骤的动作。碰到目录外的故障,人工接手也是这套设计的成本。
作者称,他们在一组种子案例上与无检查和自由工具调用方案做过对照,观察到只检查目录成员资格,仍不足以应对带注入特征的输入。文章没公开完整指标、样本规模或误拦截比例。实跑能确认的是,这个 PHP 502 样例确实被 A3 拦下。至于这套门槛能拦住多少危险动作、又会把多少正常处置推回人工,目前仍是作者的经验判断。一般团队如果缺少按处置标签积累的历史样本,也很难直接照搬 A3。
能拿来做什么
- 给 Node 服务的运维助手加重启或回滚能力时,先把允许的动作定义成固定 ID,由执行端从可信状态读取服务标识和参数。日志里的建议命令只当事故输入处理。
- 给日常 AI 编程用的运维 CLI 默认开 dry-run,让操作者看清目标和计划。实际写入同时检查本次调用的显式授权和运行环境的写入开关。
- 把 mock 测试用于验证流程接线,另用真实后端跑几条已知事故和带注入特征的样例。记录选中的方案、拒绝原因和转人工结果,方便判断门槛是否合适。