不改权重,靠指令迭代提升智能体表现
开源框架 cap-evolve 让编程智能体分析失败轨迹,修改提示词、工具或技能,并通过留出集筛选改动。作者报告其将 Gemma-4-31B-It 的 SpreadsheetBench 测试成绩从 43.5% 提升至 76.8%,测试集封存后仅评测一次。
AI 深度解读
模型做不好任务,未必只能换模型或微调。cap-evolve 尝试让编码 Agent 分析失败记录,反复修改模型每次执行任务前读取的指令。作者报告,Gemma-4-31B-It 在 SpreadsheetBench 上从 43.5% 提升到 76.8%,模型权重没有变化。
这个结果值得读,但更有用的是分数背后的细节:评测器是否重算公式,能显著改变基线;验证集太小,也会让候选指令看起来过于优秀。理解这些前提,才能判断这种优化能不能搬进自己的项目。
不改权重,为什么还能提高这么多
这里的 skill 是一份纯文本说明,类似新同事上手前阅读的操作手册。模型负责照着做,优化器负责根据失败经历改写手册。
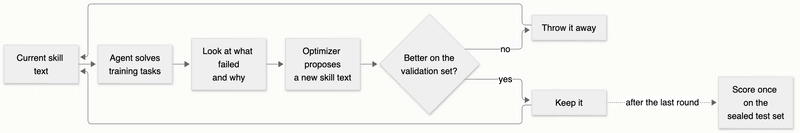
作者使用 SpreadsheetBench 的 verified 400 数据集,保留 40 道验证题和 280 道封存测试题。Gemma-4-31B-It 在 Python 沙箱里执行任务,每题最多 30 轮;Claude Opus 5 通过 Claude Code 读取轨迹、搜索文件并修改指令。
优化采用爬山算法(hill-climbing):连续运行 5 轮,每轮提出一个候选,在相同的 40 道验证题上与当前版本逐题比较。提升超过基于标准误设置的噪声阈值,才接受修改。最终留下的版本只在封存测试集上评分一次。
三次独立运行都从空 skill 开始,测试成绩分别是 75.4%、77.1%、77.9%,平均 76.8%。验证成绩却达到 95% 至 97.5%,已经说明两者不能混用。
作者拿来对照的 WikiSkill,同模型成绩为 48.3% → 68.0%;cap-evolve 则为 43.5% → 76.8%,最终高出 8.8 个百分点。不过,对照数字来自论文,作者没有重新运行对方的方法。
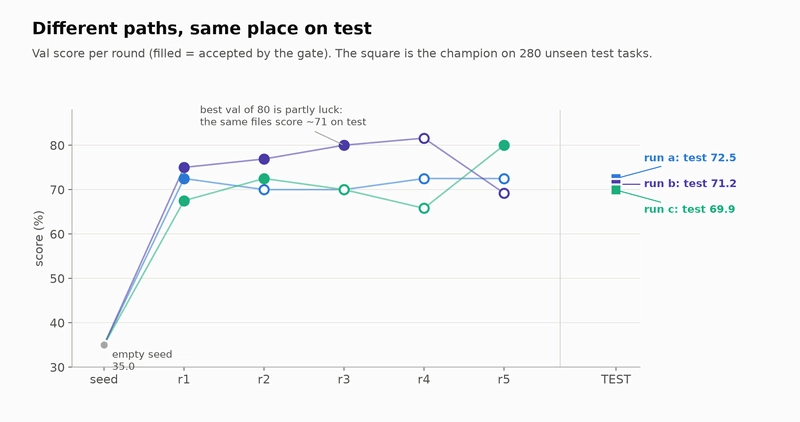
他们也让 Gemma 同时充当执行模型和优化器,得到 72.5%、71.2%、69.9%,平均 71.2%。相同循环下,Opus 5 优化器领先 5.6 个百分点,支持「更强的老师能写出更有效指令」这个判断,但尚不能解释全部收益。
分数暴涨,有多少来自读懂评测器
最关键的问题藏在 Excel 文件的读取方式里。
评测器使用 openpyxl.load_workbook(path, data_only=True) 读取已保存的单元格值。Python 写入 =SUM(A1:A9) 时,如果没有同时产生公式计算结果,读回来可能是空值。先用 LibreOffice 重算,再读取,同一道题就可能通过。
公式写对了,不代表按这套评分协议就能得分。
作者发现,仅重算方式这一项,就让无 skill 的 Gemma 测试成绩相差约 15 个百分点。GPT-5.5 更明显:按保存值评分为 38.6%,重算后为 77.5%。
于是优化器很快学到一条高收益规则:写入计算后的具体值,避免依赖公式重算。作者报告,每次运行的第一轮就修复了 18 至 21 道验证题,最多破坏一道。
最终指令还明确要求:数字使用 int/float,日期使用 datetime,遵守双方四舍五入到小数点后 2 位的比较规则,并解释 answer_position 的含义。对整表任务,它表示允许写入的最大范围,不是必须填满的区域。
这些要求把隐含验收条件变成了可执行说明。它们很有效,也限定了成绩应该怎样解读。
GPT-5.5 经优化达到平均 87.6%,高于 SkillOpt 的 80.7%。但重算后的基线已经是 77.5%,优化版本平均为 87.4%。如果业务关心的是重算结果,收益约为 10 个百分点,而不是接近 49 个百分点。SkillOpt 的指令也包含写入静态值的规则,因此两边都受这一评分协议影响。
好指令怎样产生,优化边界又该放在哪里
作者认为,有效优化需要让优化器知道失败原因和读者能力。
反馈会指出失败用例、错误单元格、输出文件是否缺失,以及答案是否因公式没有缓存值而被判空,但不提供预期答案。优化器还会收到模型能力档位:frontier、strong、mid 或 weak。这次 Gemma 使用默认的 strong 档位,生成的说明偏向明确规则、编号检查和复杂格式示例。
这些做法有合理解释,但作者没有逐项做消融实验,也没有测量换一个能力档位会怎样。它们目前仍是经验归因。
另一个设计是限制可修改范围。task_frame.md 保存任务字段、每轮只能回复一个 Python 代码块的要求和停止规则,只通过 {guidance} 插槽接收补充说明。因为执行器只运行围栏中的 Python 代码,这部分属于运行协议。
优化器只允许修改 prompt.md 和 guidance.md,配置为 editable_paths: [prompt.md, guidance.md]。候选修改其他文件,会在执行任务前被拒绝。
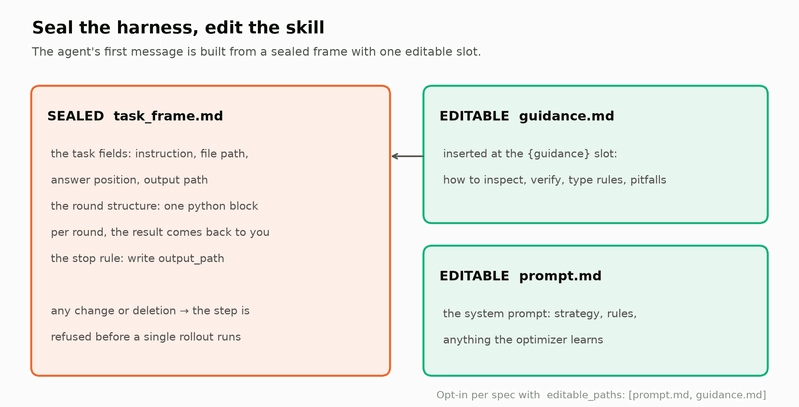
Gemma 自优化时使用 output_guard,no_subagents 配置,增加大输出读取规则并关闭子 Agent。15 轮优化中,封存框架保持不变。不过,作者也披露:Opus 5 和 GPT-5.5 的成绩来自较早版本,当时还没有封存运行协议。不能把后来的保护措施当作早期成绩已经验证过的条件。
成本也值得单独看。无 skill 的 Gemma 基线测量耗时 8 小时 4 分钟,消耗 79.4 M agent tokens;每题约 165 k tokens,优化后约 45 k。它通过不按量计费的 vLLM endpoint 提供服务,因此没有对应美元成本。
GPT-5.5 三个最终版本测试成绩只相差 1.1 个百分点,测试费用却分别为 $18.86、$38.48、$44.19。当前选择逻辑只看成绩,还不会优先保留便宜版本。
我的判断
我认可它把失败记录变成长期操作规范的方向。重复出现的工具误用、输出格式错误和验收误解,适合通过明确指令或代码约束解决。相比每次重新提醒模型,这种流程还能通过 git commit 查看差异、追溯和回退。
但「超过现有最佳结果」需要带着实验条件读。WikiSkill 使用 bash 工具,未说明轮数预算和解码参数;作者使用最多 30 轮的 Python 沙箱,Gemma 采用 temperature 0。对方优化 8 次,这里优化 5 次。起点更低,也不能单独证明整套运行环境更难。
GPT-5.5 对比的限制更多:SkillOpt 用 GPT-5.5 自优化,这里用 Claude Opus 5,不能分离优化器与算法的贡献;SkillOpt 的 direct chat 描述与多轮执行描述也有不明确之处。作者使用 reasoning effort medium,每次调用最多输出 16,384 tokens,没有传 temperature。
统计检验同样不能消除小验证集的偏差。GPT-5.5 三个最终版本中有两个在 40 道验证题上达到 100%,测试却约为 87%。Gemma 自优化均值的 95% CI 为 [68.0, 74.4],下界正好触及 WikiSkill 的 68.0,也不宜据此宣称稳定领先。
这组实验更有力地证明了明确执行规则的价值,尚未证明复杂进化流程优于人工修订指令。
原文没有给出这项对照,也没有逐项拆解六个设计选择的贡献。先人工补齐「写具体值」这类关键规则,再比较自动优化还能增加多少,才更接近一般团队要做的决策。
能拿来做什么
- 如果在做 Node 或 Python 驱动的表格 Agent,先确认验收读取保存值还是重算结果,并明确数字、日期、精度和允许修改的单元格范围,再讨论换模型。
- 为日常 AI 编程任务积累失败轨迹,优先记录工具返回、错误位置和验收原因,用这些证据修订项目指令,并保留独立测试任务检查回归。
- 让自动优化器修改指令时,把代码块格式、工具调用约定和停止条件设为固定协议,先限制可编辑文件,再逐步扩大范围。
- 比较两份指令时,同时记录通过率、tokens 和费用;验证成绩接近满分后,应扩大或交叉验证选择集,避免靠几道题的波动选出昂贵版本。