在 AWS 部署低延迟语音模型
Cartesia 介绍如何结合专用状态空间模型与 AWS 基础设施,实现其宣称的低于 100 毫秒的语音合成和识别。文章还说明 Sonic 模型在 SageMaker AI 或自管 EC2 GPU 实例上的部署方式。
AI 深度解读
语音 AI 的难点,不只是把声音做得像真人,还要在用户期待的时间内接上话。AWS 这篇文章给出的方案,是用 Cartesia 的状态空间模型处理流式语音,再通过托管或自建 GPU 服务控制部署链路。
最值得带走的有两点:模型为什么适合边接收、边输出,以及团队该如何选择部署方式。不过,文中的「低于 100ms」主要指首字节延迟,不能直接理解为用户说完话后,整个 AI 助手能在 100ms 内开口。
为什么流式语音需要换一种模型思路
一轮语音对话通常要经过语音转文字、LLM 生成回答、文字转语音。每一步都等完整输入处理完再交给下一步,停顿就会叠加。
文章把突破口放在状态空间模型(SSM)上。它逐步处理序列,并把历史信息压进一个固定大小的内部状态。可以把它理解为:模型一边听,一边更新手里的摘要,后续计算继续使用这个状态。
与标准全注意力机制对序列元素两两比较相比,这种递推结构适合持续到来的音频,推理时也不需要让历史缓存随序列不断增长。作者还强调,结构化 SSM 的状态参数化有助于保留长距离信息,缓解经典 RNN、LSTM 的长期信号衰减问题。
Cartesia 把这套思路用在两个模型上:
- Sonic 负责文字转语音(TTS),首个音频字节约在 90ms 到达,支持超过 44 种语言,可以用 10 秒音频样本克隆声音,并在完整文本到达前开始生成音频。
- Ink 负责语音转文字(STT),持续输出部分转写结果,并利用语义判断用户是否结束发言,减少单独接入语音活动检测(VAD)或端点检测模型的需求。
这里最有价值的是流水线并行:Ink 尚未收到完整发言时,下游 LLM 就可以开始准备回答;Sonic 也能在回答文本尚未全部生成时开始合成。
但原文没有解释如何处理部分转写被修正、用户继续补充,以及提前生成的回答需要撤销等问题。这些仍然需要应用层设计。
想把 Sonic 放进自己的 AWS 账户,要先分清交付边界
原文提供两条 Sonic 部署路线:通过 AWS Marketplace 模型包部署到 Amazon SageMaker AI,或者拿到 Cartesia 的容器后,在 EC2 GPU 实例上自行运行。
Sonic 可以部署进自己的 AWS 账户,Ink 在原文中仍通过 Cartesia API 提供。
因此,需要数据驻留的团队不能只看到「VPC 内推理」就认定整条语音链路已经私有化。Sonic 的部署边界,并不自动覆盖 Ink 和后续 LLM。
托管路线使用 Sonic 3.6 SageMaker 模型包。订阅只授予模型包访问权,不会创建推理资源。之后还要创建模型、配置实时端点,并等待状态从 Creating 变为 InService。
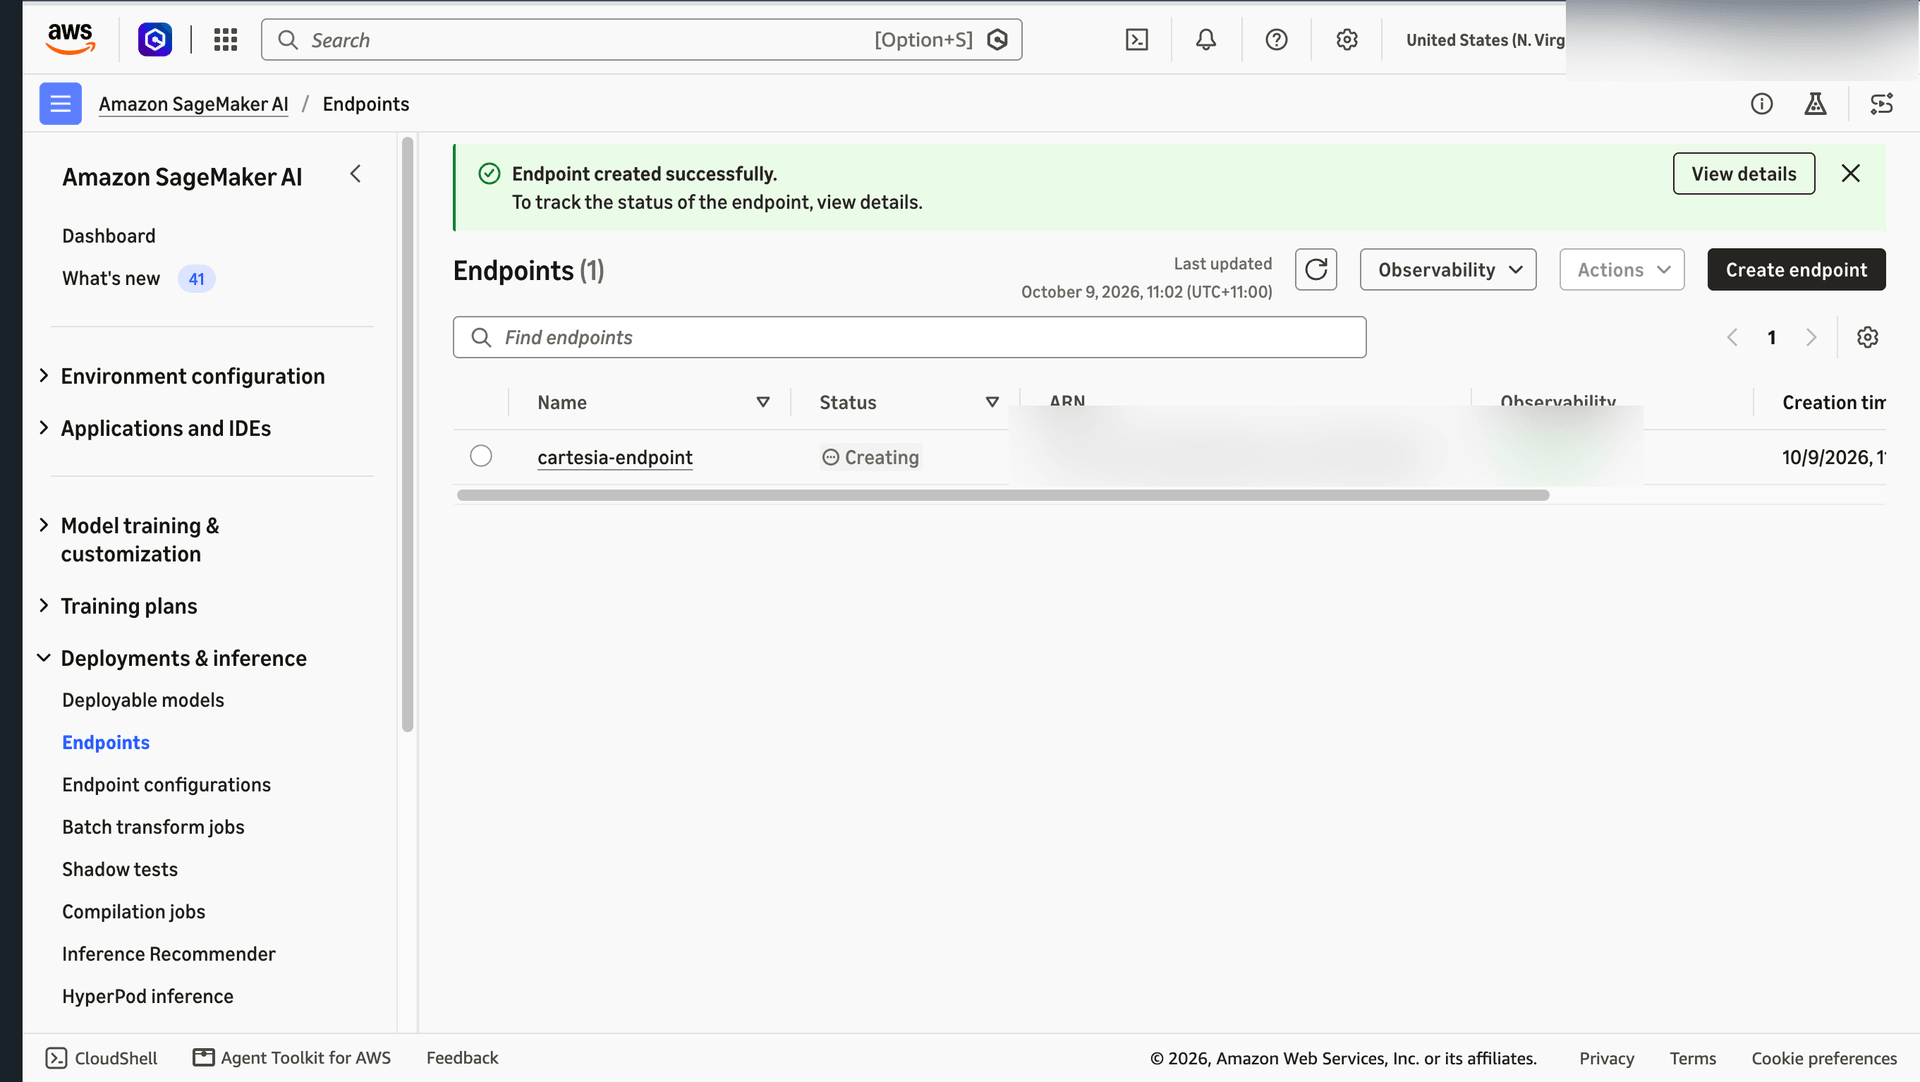
原文要求从 SageMaker Notebook Instance 或 SageMaker Studio 操作,执行角色具备 AmazonSageMakerFullAccess。订阅需要 aws-marketplace:Subscribe、aws-marketplace:Unsubscribe 和 aws-marketplace:ViewSubscriptions,或者账户已经完成订阅。
支持的实例起点包括 ml.g6e.xlarge、ml.g7e.2xlarge、ml.g7.2xlarge,部署示例使用 ml.g6e.2xlarge。实际选择要检查模型包的 SupportedRealtimeInferenceInstanceTypes,并确认服务配额能够覆盖现有用量与新增端点实例数。
下面这段命令用于核对美国东部北弗吉尼亚区域的模型包状态、产品标识和支持的实例类型:
export MODEL_PACKAGE_ARN="arn:aws:sagemaker:us-east-1:865070037744:model-package/sonic36-sagemaker-v0-c6e9cacffcdf31178d1bd7c98c587480"

aws sagemaker describe-model-package \
    --model-package-name "$MODEL_PACKAGE_ARN" \
    --region us-east-1 \
    --query '{Status:ModelPackageStatus,ProductId:InferenceSpecification.Containers[0].ProductId,InstanceTypes:InferenceSpecification.SupportedRealtimeInferenceInstanceTypes}'
要看清 --region us-east-1 这一行:模型包 ARN 与区域绑定,不能直接搬到其他区域使用。端点就绪后,通过 SageMaker Runtime 的 InvokeEndpointWithResponseStream 接收音频流。
自建 GPU 的难点,是让每条音频流持续稳定
自建路线需要向 Cartesia 获取容器镜像和许可,再将镜像放进自己的 Amazon ECR。原文推荐 G6(L4)、G6e(L40S),也支持较早的 G5(A10G);为了简化扩缩容,建议每个模型副本使用单张 GPU。
调度可以用 ECS 或 EKS。ECS 的任务定义需要通过 resourceRequirements 声明 type GPU,服务放在 Application Load Balancer 后面;EKS 则需要 GPU 节点、GPU 优化 AMI 和 NVIDIA device plugin,再通过 Service/Ingress 暴露服务。
真正影响体验的,是后面的运行细节。
首先是冷启动。原文建议把数 GB 的模型权重放在 EFS 或 FSx for Lustre 共享卷上,避免每个副本重复下载,并在容器启动时预热,通过健康检查后才接流量。不过,共享存储能缩短多少启动时间,文章没有实测数据。
其次是吞吐与延迟的取舍。扩大 batch 通常有利于 GPU 利用率,却可能让请求等待更久。原文建议围绕低于 100ms 的目标,实测每张 GPU 能承载多少并发音频流,再确定副本容量。
扩容指标也应贴近负载。ECS 可以使用 AWS Application Auto Scaling 和自定义 CloudWatch 指标;EKS 可以使用 HPA/KEDA,并配合 Karpenter 或 Cluster Autoscaler 增加节点。活动音频流数量、GPU 利用率通常比 CPU 更贴近这里的工作量。
最后是持续连接的可靠性。原文建议至少两个副本跨节点运行,发布时配置滚动更新和连接排空,避免切版本切断正在播放的声音。网络上则建议使用 cluster placement group、单可用区副本和 ECR/S3 的 VPC endpoints,混合部署可考虑 AWS Direct Connect 或私有 Network Load Balancer。
我的判断
这篇最有用的部分,是把模型流式能力、GPU 调度和连接生命周期放到同一个问题里。声音生成得快,只解决了链路中的一段;应用还要及时消费、传输和播放这些音频。
但对架构优势的描述需要收一收。原文将 Transformer TTS 概括为需要处理完整序列后才能输出,这个说法过于绝对,不能据此认定所有 Transformer 方案都无法流式工作。文章也没有提供同硬件、同音质要求下的对照测试,无法判断优势分别来自 SSM、模型实现还是部署优化。
「低于 100ms」同样缺少测试条件:并发量、网络位置、冷暖启动状态,以及 P95、P99 都没交代。Sonic 的约 90ms 指标是首个音频字节,不是浏览器真正发声,更不是包含 Ink 和 LLM 的完整对话耗时。
原文还以 Amazon Connect 作为生产案例,声称可以承接高峰流量、提供实时转写和多语言语音,但没有给出具体负载、延迟分布或成本数据。这能说明其生产应用主张,尚不足以替一般团队证明收益。
我的取舍是:希望尽快接入,可以先评估 Cartesia API;明确需要账户内运行 Sonic,再考虑 SageMaker AI;已有 GPU 平台或特殊网络约束,才有充分理由承担自建成本。单可用区有利于缩短网络路径,但跨节点副本不能覆盖可用区故障,也应单独权衡。
能拿来做什么
- 做语音助手原型时,把转写、LLM 首段输出、TTS 首字节、浏览器开始播放分别记录下来,先找最长的等待发生在哪一步。
- 在前端或 Node 接入音频流时,验证从接收、转发到播放的整条链路是否持续消费数据,并补齐取消请求、用户打断和旧回答停止播放的处理。
- 评估 Sonic 3.6 的私有部署时,先核对区域 ARN、实例支持列表、服务配额和许可,再分别确认 Ink、LLM 的数据流向。
- 已有 ECS 或 EKS GPU 平台的团队,可以用真实并发音频流测试 batch、预热与连接排空,拿到首字节延迟和每 GPU 容量后再决定扩容策略。